Twitter AI - 2026-09-23
1. 大家在讨论什么
1.1 Jev 和其他小型决策层,已从“新鲜事”走向“工具包” 🡕
2026-09-23,大约有 25 条非转推内容符合 Jev / decision-model 这一话题簇,高于 2026-09-22 的约 16 条。比起数量增加,更重要的是讨论性质的变化:人们不再追问 Jev 是什么,而是开始发布实现文章、速查表、路由演示,以及带边界约束的 GUI 决策相关发布,把这种快速的类型化选择视为独立于负责写作或规划的大模型之外的一层。
@Av1dlive 发帖称(93 个赞,29 条回复,12,223 次浏览,151 次收藏)发布了一篇 Jev 构建文章,随后又在回复中把大家引向 Keel——这是一个开源的 Rust 编码工作区,会把新任务路由给本地 Laya selector 或托管版 Jev,同时保留由宿主掌控的权限检查。这种组合之所以重要,是因为它把 Jev 从基准测试中的谈资,变成了真实的编码循环设计:通过 ACP 连接的代理、受边界约束的选择,以及可在事后审查的决策记录。
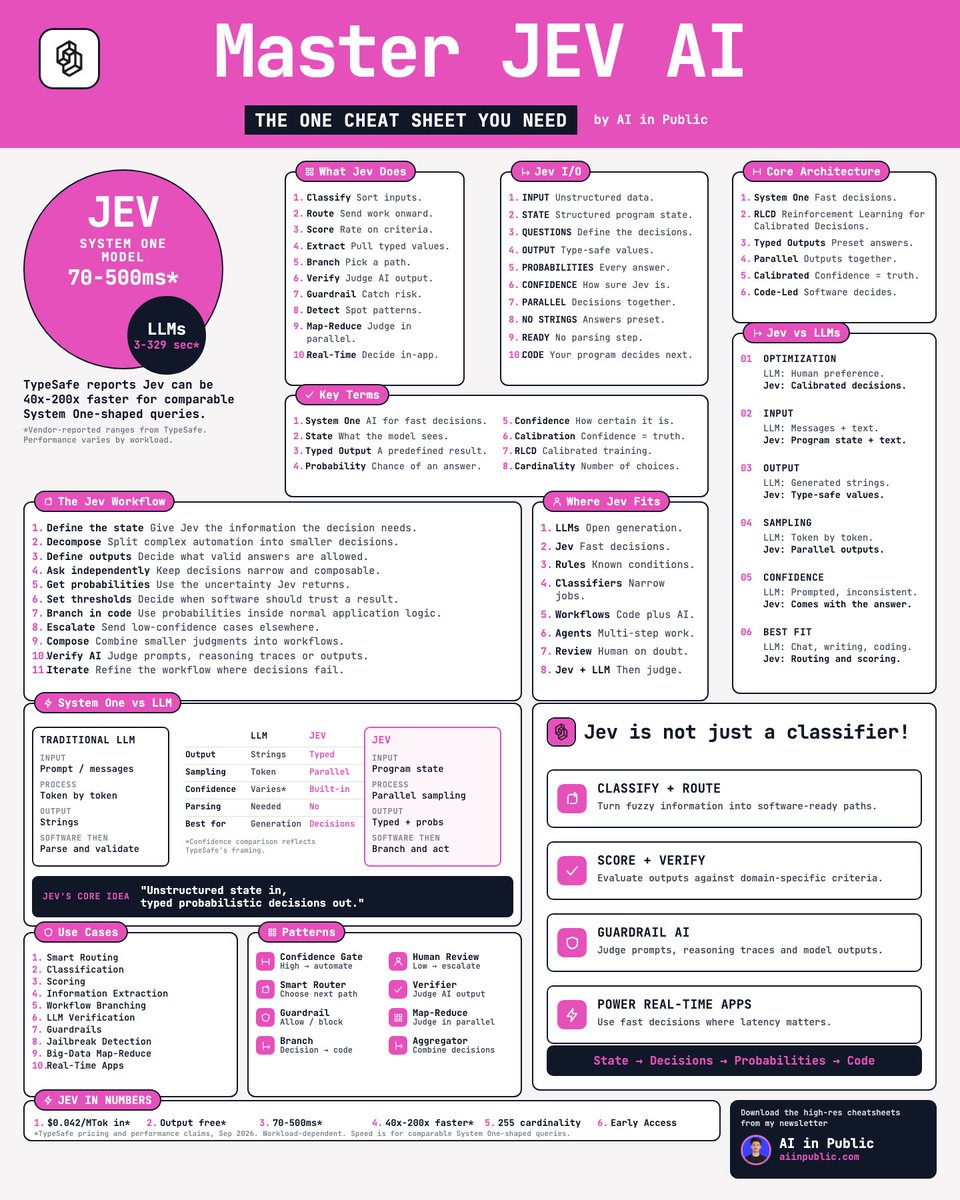
@humzaakhalid 认为(3 个赞,3 条回复,368 次浏览)表示,大家误解了 Jev,因为它根本不是写作模型,而是一层快速的类型化决策层。随附的速查表把这一点落到了操作层面,列出了路由与评分用例、置信度处理,以及何时仍然应该让完整的 LLM 留在环路中。
@AGTPinsights 报道称(2 个赞,310 次浏览,3 次收藏)表示,CUA-S1-4B-0.2 把同样的设计模式推进到了计算机使用领域:这是一个基于 Qwen3.5-4B、采用 Apache-2.0 许可的小型决策模型,用于选择带边界约束的 GUI 操作,并且根据发布卡,其在 GUI-360 上取得了 92.9% 的成绩,而对比基线为 60.1%。更广义上的 Cua repo 之所以重要,在于它把这个小模型放进了一个更大的开放栈中,包含驱动、云桌面和基准测试,这让“决策层”这条叙事看起来越来越像产品化形态,而不再只是概念。

@hellonehha 分享了(12 个赞,4 条回复,387 次浏览,5 次收藏)展示了一个正在进行中的项目里的实时 Jev 路由演示,这又提供了一个较小但依然有价值的构建者信号:Jev 已经开始被接入真实的产品工作流,而不只是停留在理论讨论中。
讨论洞察: 最有价值的一条回复来自 @roscherveniak,他告诉 Av1dlive,决策层的强弱取决于它能检查到什么证据,并要求提供输入、工具调用和停止原因的追踪记录。这让实际问题从“Jev 快不快?”转向了“事实依据是什么,以及这个决策如何被审计?”
与前一天相比: 在 2026-09-22,Jev 这一话题簇主要围绕阈值和盲检;到了 2026-09-23,重心已经转向构建工具包、对比指南和专门的计算机使用模型。
1.2 模型讨论仍然围绕经济性展开,但开源权重与可读性改变了叙事框架 🡕
模型经济性这一话题簇仍然很大,约有 32 条匹配的非转推内容,略高于前一天的大约 29 条。变化出现在叙事框架上:信息流依然痴迷于价格,但讨论已经从前沿实验室的发布对照表,扩展到了开源权重的成本前沿、长期的能力-成本曲线,以及人们是否真的喜欢与这些模型交流。
@simonw 总结了(194 个赞,29 条回复,20,006 次浏览,104 次收藏)将发布日定义为一次定价重置:他链接的文章给出的价格是,GPT-6 Luna 为输入 $0.10/M、缓存输入 $0.01/M、输出 $0.50/M;GPT-6 Sol 为输入 $2/M、缓存输入 $0.20/M、输出 $10/M;Claude Opus 5.5 为输入 $4/M、缓存输入 $0.20/M、输出 $20/M(文章)。这篇帖文最有价值的部分不在于谁“赢了”,而在于回复中引出的路由含义:价格、努力等级、延迟和失败模式,如今比“是否存在一个通用最强模型”的说法更重要。
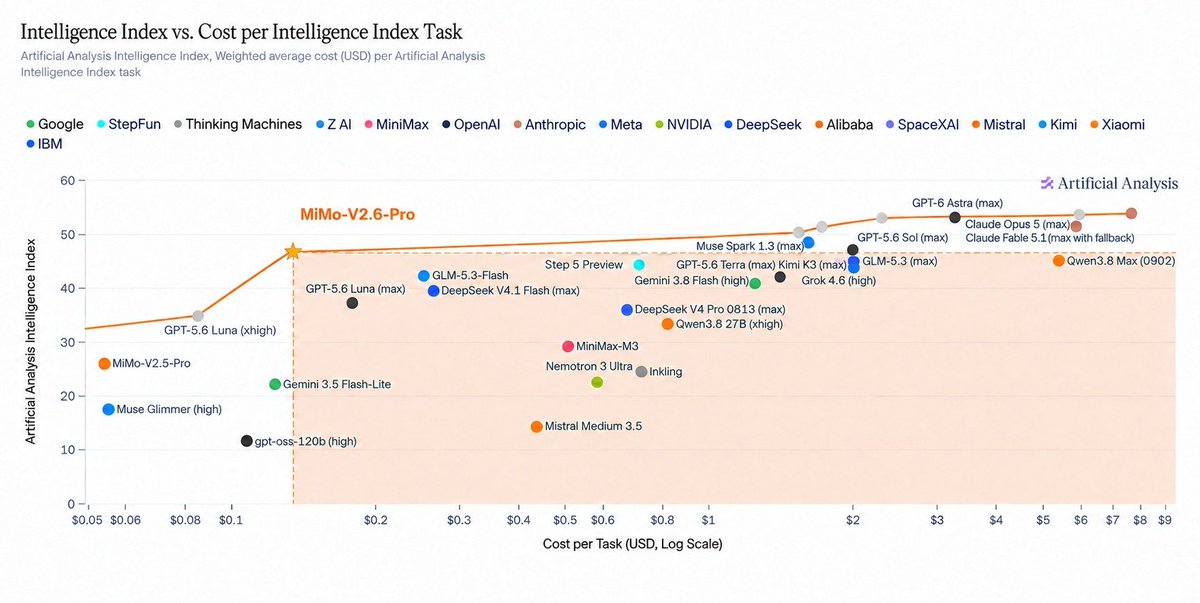
@TheAIColony 认为(109 个赞,5 条回复,6,168 次浏览,65 次收藏)表示,Xiaomi 的 MiMo-V2.6-Pro 值得关注,与其说是因为它登顶了某个开源权重排行榜,不如说是因为它把每个 Intelligence Index 任务的成本压到了约 $0.13,而且是通过高度依赖任务和评测的后训练达成的。真正让这个说法站得住脚的是配图:图中显示,MiMo 位于智能-成本的帕累托前沿上,单任务成本接近低端区间,同时在 Intelligence Index 的开源权重分层中位居顶端。


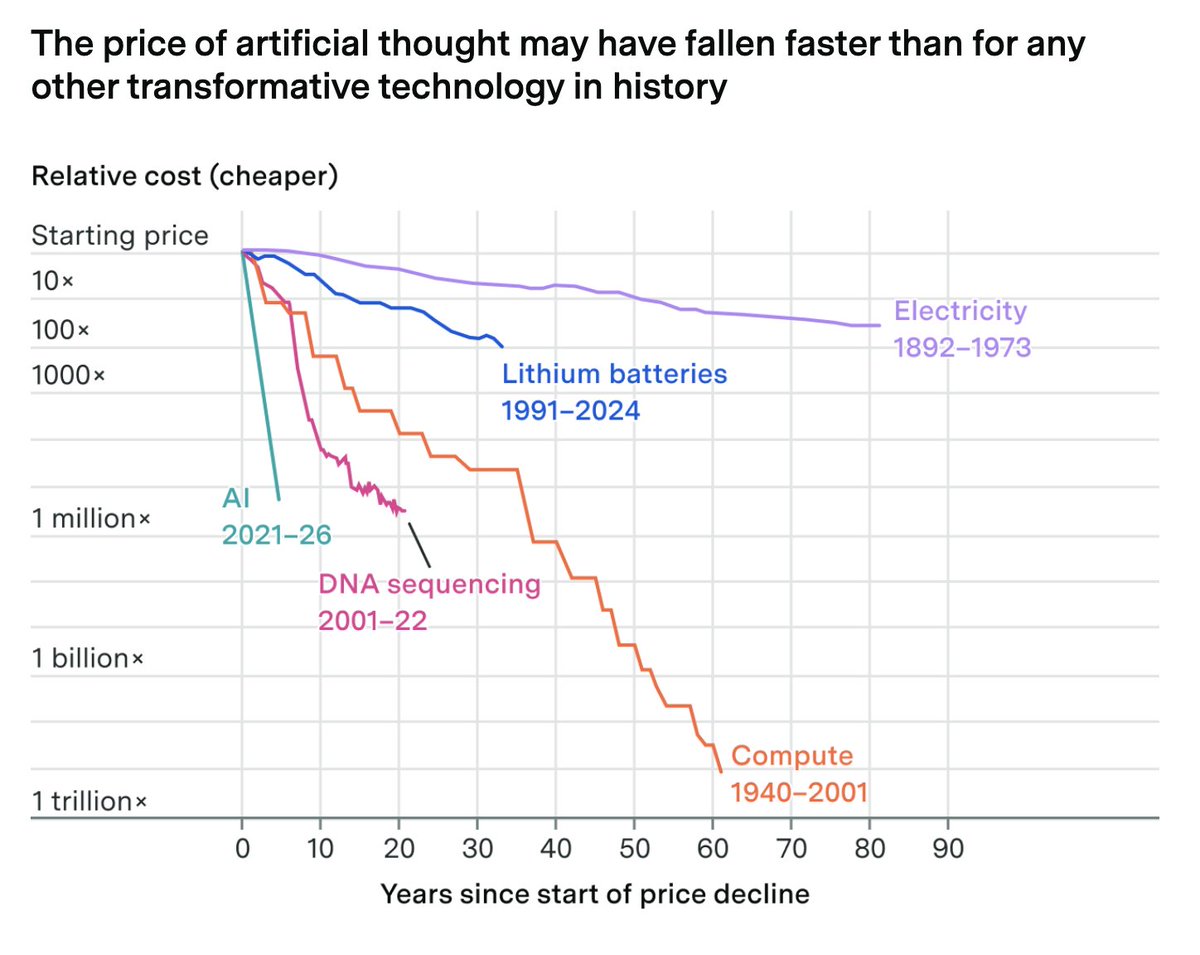
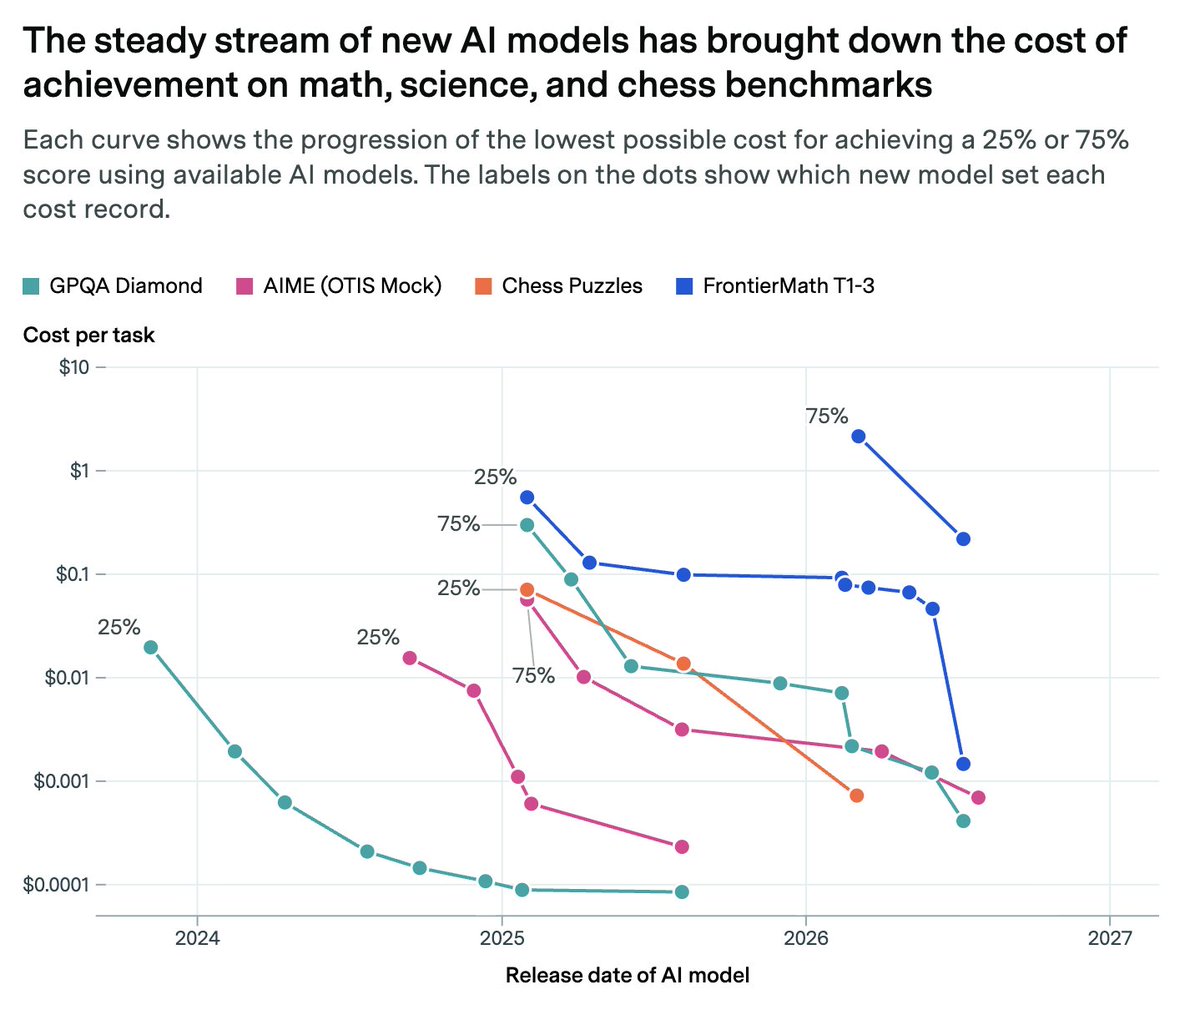
@kimmonismus 进一步补充道 也把同一叙事延伸到了宏观经济层面(234 次点赞,23 条回复,13,995 次浏览),并引用 Epoch AI 的估算称,自 2023 年以来,达到固定 AI 性能水平的成本大约每个季度下降 47%。随附图表之所以重要,是因为它们同时展示了跨技术比较,以及“每年 13 倍”这一标题背后按基准拆分的曲线。
@cyrilXBT 补充道 则提出了一个不同但相关的角度(71 次点赞,10 条回复,2,706 次浏览):前沿模型也许在变得更聪明的同时,却变得更难读,而 Opus 5.5 之所以突出,是因为它没那么像一堆项目符号拼成的文字糊糊。这让“好的经济性”不再只意味着 token 更便宜:人们同样在意输出是否值得一读。
讨论洞察: 最有力的修正来自 @ZypherHQ,他 提问(55 次点赞,31 条回复,1,646 次浏览)质疑,如果没有更深入的测试,Opus 5.5 所体现出的基准差距是否真的站得住脚。这种怀疑也呼应了 Simon Willison 的回复串:如今,人们期待模型路由决策能够经受住特定工作负载的检验,而不只是停留在发布时的幻灯片上。
与前一日对比: 在 2026-09-22,“经济性”主要意味着比较各家前沿实验室彼此之间的高下。到了 2026-09-23,这一框架扩大到了开放权重、持续下行的成本曲线,以及基准测试表格无法反映的表达质量。
1.3 本地与端侧智能体栈变得更具体:从一键安装到边缘部署之争 🡕
本地运行时这一簇内容,从 2026-09-22 大约 10 条匹配的非转推,增长到 2026-09-23 的约 16 条。关键变化在于更具体了:人们不再泛泛而谈隐私,而是开始贴出实际安装流程、终端 UI、延迟测量,以及更明确地讨论推理究竟应该部署在哪里。
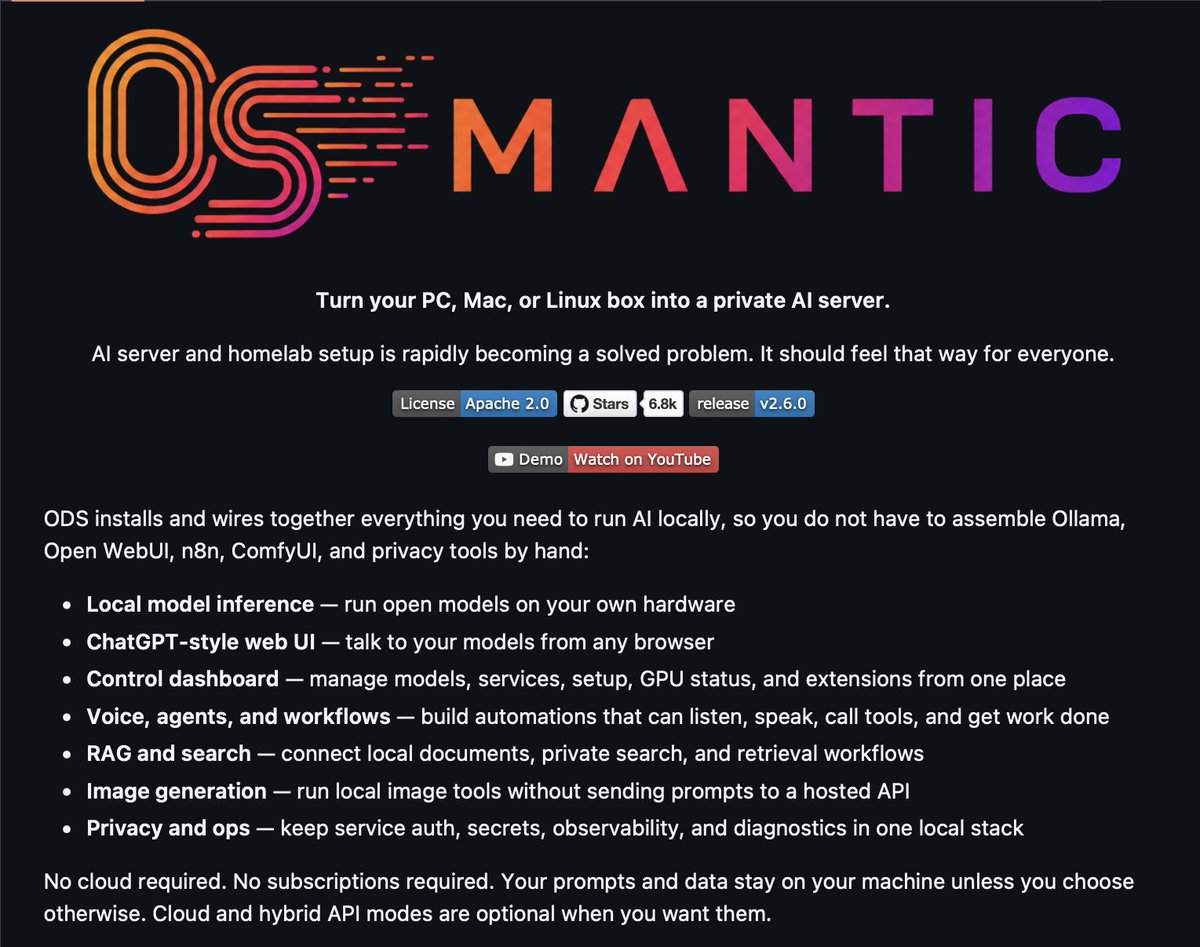
@TheAhmadOsman 推介了 将 ODS 称为上手本地 AI 的最简单方式(44 次点赞,3 条回复,2,180 次浏览,31 次收藏)。这不只是营销文案:ODS 的仓库和 README 介绍了一套 Apache-2.0 栈,可安装本地推理、Open WebUI、语音、智能体、工作流、RAG、搜索和图像生成,让一台机器默认就变成私有 AI 服务器。
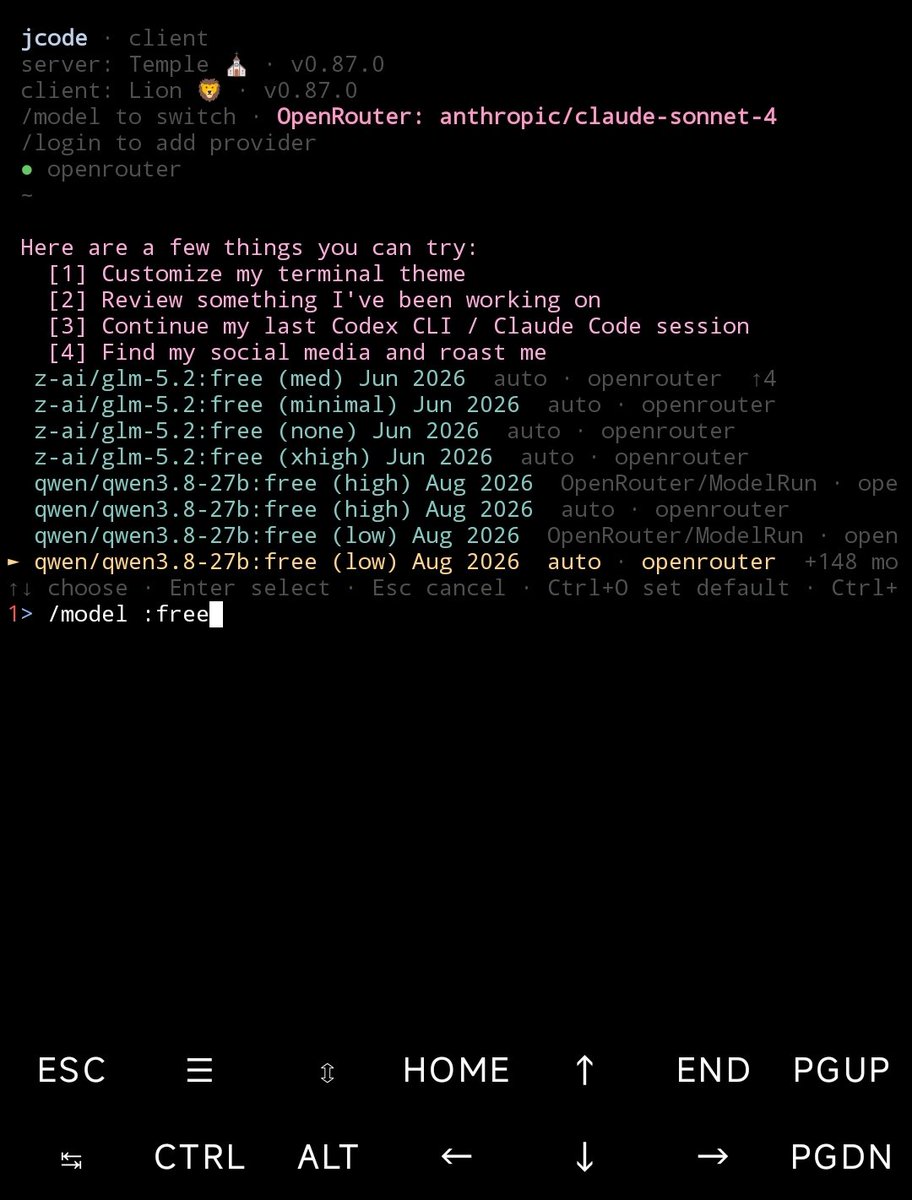
@itsjdraven 提到了 将 Jcode 介绍为开源的 Rust 终端智能体 harness(10 次点赞,11 条回复,555 次浏览)。这条推文强调了并行智能体、记忆和公开转录;抓取到的 仓库 也印证了这一点,其中明确主打低 RAM 占用和高效的多会话扩展,说明本地智能体工具如今比拼的不只是 prompt,也包括系统工程能力。
@yoheinakajima 发布了 宣布将 Glance Speedlab 开源(11 次点赞,3 条回复,2,425 次浏览,8 次收藏),而链接的 技术报告 则补上了信息流里通常缺少的硬指标:原生多问题批处理可提速 2.405 倍,另有一条 MLX 8-bit 路径,在保持 84/84 固定测试集决策不变的同时,将新帧 p50 从 358.5 ms 降到 259.6 ms。这比“能在我的笔记本上跑”更像一个成熟的本地推理叙事,因为它清楚记录了究竟是什么带来了提速,以及哪些方案没能通过质量检验。@babyfolio 认为(33 次点赞、7 条回复、4,444 次浏览、17 次收藏)认为,Muse 按用户划分的持久化 VM 架构,可能才是真正值得关注的 AI 基础设施信号,因为那些会浏览网页、登录并执行操作的智能体,可能需要安全隔离的运行环境。@AlphaSenseInc 补充道(2 次点赞、2 条回复、1,133 次浏览、5 次收藏)提供了来自一场 NVIDIA 访谈的一线视角:成本和延迟是边缘部署普及的主要驱动因素,60-70% 的客户已经拥有模型优化团队,而受访者预计,未来两到五年内,65-70% 的推理将转移到设备端或本地部署环境。

讨论洞察: 最能暴露真实摩擦点的,不在标题里,而在回复区。ODS 引来了意料之中的硬件层面质疑;babyfolio 的帖子很快转向一个问题:持久会话能否以较低成本挂起并恢复;而 Glance 的讨论则聚焦于时效性滞后与门控机制。人们对“本地优先”的热情是真实的,但对运营层面现实可行性的要求也同样强烈。
与前一天对比: 相比 2026-09-22 更宽泛地讨论如何把智能嵌入现有工作流,2026-09-23 的讨论下沉了一层,转向部署载体、p50 延迟、内存占用,以及让智能体运行时保持热启动状态的经济性。
1.4 基准测试与智能体基础设施已超越静态标准答案,转向沙箱、隐藏式验证和长时程任务 🡕
广义上的基准测试 / 智能体基础设施板块仍是当天最大的主题之一,匹配到的非转推帖文从 2026-09-22 的约 59 条上升到 2026-09-23 的约 65 条。值得注意的变化在于概念层面:人们不再只是追问哪个模型最擅长回答固定提示词,而是开始强调那些评估整个求解系统的体系,或者那些主要用于构建训练和衡量这些求解系统所需环境的基础设施。
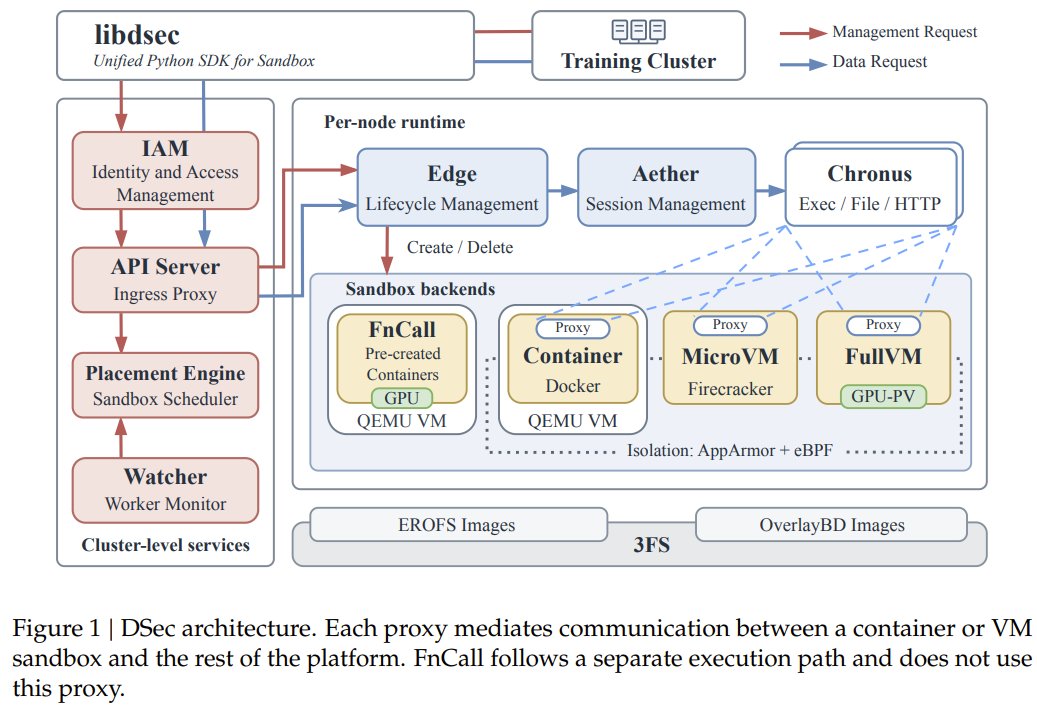
@jiqizhixin 报道称 提到 DeepSeek 的 DSec 是一个沙箱平台,每天运行 300 万个 AI 智能体环境(11 次点赞、4 条回复、648 次浏览、8 次收藏)。配图中的架构图让这一说法更为具体:它展示了一个统一的控制平面,横跨 FnCall、容器、microVM 和完整 VM;其链接的 论文 与公开报道也与推文给出的运行数据相互印证,包括约 160 节点集群、380,000+ 并发沙箱,以及每秒 5,000+ 个新沙箱。
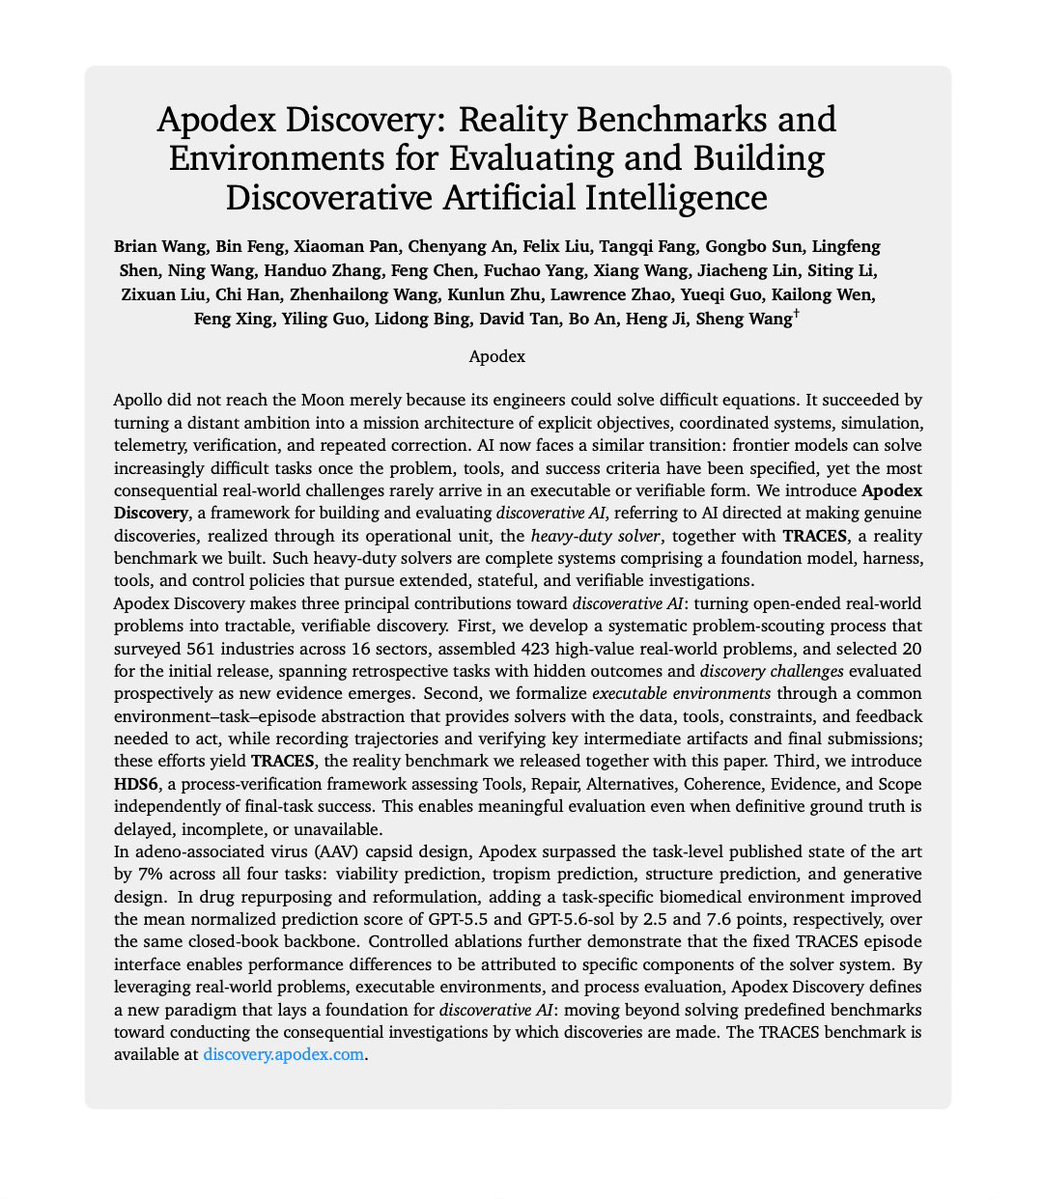
@dr_cintas 认为(9 次点赞、3 条回复、1,379 次浏览、4 次收藏)认为,Apodex 的 TRACES 之所以重要,是因为它通过隐藏式验证和 HDS6 评分框架,对整个求解系统——模型、执行框架、工具、记忆和控制策略——进行评分。HDS6 包括 Tools、Repair、Alternatives、Coherence、Evidence 和 Scope。该网站也用一个覆盖 17 个环境、1,182 条轨迹的实时基准测试支撑了这一定位,任务涵盖 AAV 衣壳设计、药物再利用、临床试验和 LLM 工程。
@AGTPinsights 报道称 宣布推出 OpenRSI-Index(1 条回复、102 次浏览),并将其描述为一个开放的递归自我改进基准,包含 60+ 小时轨迹、1,000 块 GPU,而且仅 v0.1 就已投入超过 100,000 个 H100 小时。公开的 仓库 则进一步补充了这一叙述,提供公开任务、日志,以及一个 RSI-Anything 贡献流程,试图把新任务的打包时间压缩到约一小时。

讨论洞察: 在 DSec、TRACES 和 OpenRSI 这几个案例中,基准测试已不再只是一个数据集。如今被评估的对象,越来越是整个系统:规划器、工具、记忆、安全检查,以及让整次运行成为可能的运行时底座。与前一天相比: 在 2026-09-22,人们已经开始要求基于工作流的测试。到了 2026-09-23,他们开始把为此而设计的沙盒、隐藏验证器框架,以及公开的长时程任务套件挖出来。
2. 什么让人沮丧
基准测试表格依然回答不了工作负载或路由问题
最强烈的挫败感并不在于缺少基准测试讨论,而在于人们看完之后,仍然无法判断哪个模型该放进自己的技术栈。@simonw 翻译了 把前沿版本纳入了具体的价格区间,但他的回复最终还是回到了按工作负载进行路由;@ZypherHQ 推动(55 次点赞,31 条回复,1,646 次浏览)则在讨论:如果没有更多测试,公开的 Opus 5.5 基准差距是否真的可信;而 @dr_cintas 认为 指出,固定答案的基准测试漏掉了人们真正部署的东西:完整的求解器。即便是正面的基准测试帖子,也带着一种隐含的举证压力。
严重程度:高。当前的应对方式是跑内部任务套件、评估完整求解器,并把常规路由与前沿任务分开。这件事依然值得投入,因为评估负担本身正在成为一个产品类别。
更聪明的模型往往仍然写得空泛或啰唆
第二个挫败点是风格层面的,而不是数值层面的。@cyrilXBT 表示(71 次点赞,10 条回复,2,706 次浏览)指出,许多当前的前沿模型仍然会输出那种毫无生气、千篇一律的项目符号列表和“400 字的空话”,而他称赞 Opus 5.5,主要是因为它没那么像机器生成的。@Dan_Jeffries1 补充说 在他的 Nautilo AMA 中说,他“受不了”AI 写作那种泛泛的高中作文结构,并且会手工重写其中 70-80% 的内容。人们抱怨的并不是 AI 本身,而是原始能力依然无法保证可用的表达。
严重程度:中高。人们的应对方式包括把任务路由给自己觉得更好读的模型、大幅重写,或者把模型限制在更小的决策角色里。但这依然给更好的风格评估和行为回归工具留下了空间。
本地/私有代理栈仍然受制于硬件和热运行时经济性
本地优先的推动很有声势,但运营摩擦依旧明显。@TheAhmadOsman 进行了 让 ODS 看起来很容易,但紧随其后的回复立刻把话题拉回到硬件现实;@yoheinakajima 显示 指出,即便是很强的本地结果,也需要仔细测量,并在模型路径之间做权衡;@babyfolio 曝光 提到了让每个用户的 VM 保持热态的成本;而 @AlphaSenseInc 将其表述为 则把边缘部署视为一个成本/延迟决策,而且这已经需要专门的优化团队。
严重程度:中高。当前的应对方式是更好的封装、感知硬件的路由,以及对代理运行时进行挂起/恢复管理,但这些依然是不可忽视的工程负担。
可执行操作的代理仍然缺乏成熟的兜底机制和交易后逻辑
当讨论从“代理能不能点下那个按钮?”转向“点完之后会发生什么?”时,信心很快就降了下来。@Musecases 认为(15 次点赞,5 条回复,2,196 次浏览,7 次收藏)指出,代理之战真正争夺的是购买按钮,但最有价值的回复把缺失的那一层收窄到了商家覆盖、可信支付、退货/退款,以及订单失败时清晰的兜底方案。被引用的 @Alibaba_Qwen 公告,由 @OmNawale45831 这里 提出的问题,则从另一个角度清楚地强调了同样的警示:移动代理在执行敏感的支付或删除操作前,应先暂停并交还控制权。
严重性:高。团队可以通过审批检查点和受限工具来降低风险,但这股讨论潮仍将信任、可逆性和事后恢复视为尚未解决的产品问题。
3. 人们希望看到什么
团队可在自有技术栈上运行的求解器级评估
最明确的需求,是能测试整个运行系统的评估,而不只是基于公开提示词测试模型本身。@simonw 显示 解释了为什么路由如今取决于价格、缓存和任务组合;@ZypherHQ 显示 指出,发布当天的数据已无法再解决信任问题;@dr_cintas 指出 提到了求解器级评分;而 OpenRSI 则把这一思路扩展到公开的 60 多小时运行中。人们想要的是能映射到自身架构、延迟预算和成本模型上的评估。机会:直接。
安装之后依然易用的私有/本地代理运行时
人们似乎希望从本地 AI 获得的,不只是一个私有演示,而是一个在硬件、延迟和更新等现实因素加入后,依然稳定可用的运行时。@TheAhmadOsman 提供了 提出了一套“一次安装”的技术栈;@yoheinakajima 记录了 展示了让本地循环保持高速所需的测量纪律;@AlphaSenseInc 表明 则表明,端侧和本地部署的位置还会持续扩展。缺失的一层,是围绕打包、硬件感知路由和优雅降级的工程化打磨。机会:直接。
具备记忆、权限和暂停/恢复控制的持久化代理工作空间
当天关于运行时的帖子不断指向同一个愿望:代理要能持续存在足够久,真正变得有用,同时还要有易于理解的控制界面。@Dan_Jeffries1 描述了 将 Nautilo 描述为一个持久化的多用户组织级框架,并为每个人配备一个长期存在的 Genie;@itsjdraven 显示 描述了一个以公开转录和记忆为核心的终端框架;@babyfolio 曝光 则讨论了持久化 VM 带来的暂停/恢复经济性。机会不只是“更多代理”,而是具备更清晰归属、更强成本控制和更明确记忆边界的代理工作空间。机会:竞争型。
面向电商、预订和移动代理的更安全操作护栏
人们希望代理能够完成现实世界中的任务,而不会沦为客服支持的噩梦。@Musecases 降低了 将电商问题收束到购买按钮,但回复很快又把范围扩展到支付、商户访问以及退货/退款;@Alibaba_Qwen mobile-agent 公告 则强调,在执行敏感操作前应进行具备权限感知的暂停;以及 @AGTPinsights 曝光 一个更小的 computer-use 模型,可以嵌入更可控的闭环中。当前需要的是:在具备行动能力的系统周围,建立明确的审批、恢复和审计护栏。机会:直接。
具备类型化输出、追踪能力与领域校准的决策层工具
围绕 Jev / System One 的讨论指向了一个明确缺失的控制层。@Av1dlive 显示 展示了如何把决策模型接入编码工作区,@humzaakhalid 映射了 说明了快速类型化模型应处的位置,而 @roscherveniak 则强调了输入、工具以及停止原因的可追踪性。缺失的一环,是围绕这些决策建立面向具体领域的校准、审查与日志能力。机会:竞争性。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Opus 5.5 | 前沿模型 | (+) | 能力叙事强,沟通表达比许多同类更清晰,缓存读取价格低于 Opus 5 | 价格仍然偏高,而且其基准领先幅度仍有争议 |
| GPT-6 Luna | 高效前沿模型 | (+) | 输入/输出定价极低,尤其是缓存输入的经济性突出,适合作为默认路由目标 | 并不被定位为最难任务的最佳选择 |
| GPT-6 Sol | 前沿模型 | (+/-) | 相比 Luna 更适合高难任务,同时又没有 Anthropic 顶级模型那样的高定价 | 性价比仍取决于具体工作负载下的测试结果 |
| MiMo-V2.6-Pro | 开放权重模型 | (+) | 据称在智能/成本前沿上表现强劲,后训练路径也讲得清楚 | 真实世界采用与外部验证仍处于早期 |
| Jev / System One | 决策模型 | (+) | 类型化输出、校准过的置信度、低成本的重复路由/评分 | 仍需要 schema、追踪与升级处理逻辑 |
| ODS | 本地 AI 技术栈 | (+) | 提供私有 AI 服务器入口,支持本地推理、语音、智能体、工作流、RAG 和搜索 | 硬件与运行时复杂性并不会因此消失 |
| Jcode | 编码 harness | (+) | 并行会话、语义记忆、公开转录,以及强调 RAM 效率的定位 | 生态仍早期,装机量也小于主流 IDE 工具 |
| Glance Speedlab | 本地 VLM 方法 | (+) | 在固定测试集上可复现地降低延迟,同时保持决策质量 | 强依赖特定硬件,且适用范围局限于摄像头/VLM 闭环 |
| CUA-S1-4B-0.2 | computer-use 决策模型 | (+/-) | 小型开源 GUI 动作选择器,据称在 GUI-360 上表现很强 | 作用范围有限,且仍依赖更大的外围技术栈 |
| TRACES | 评测基础设施 | (+) | 通过隐藏验证和过程评分,对整个求解器进行打分 | 仍属早期框架,且有真实运营成本 |
| OpenRSI-Index | 长时程基准 | (+) | 公开了生产规模、时长超过 60 小时的智能体任务 | 计算需求极高,且 v0.1 版本成熟度仍处早期 |
| Qwen Intelligence mobile agents | 移动端智能体技术栈 | (+/-) | 将 planner/use/creative 分工拆开,并以真实设备基准进行了有力包装 | 权限、安全与失败恢复仍未解决 |
| FLUX 3 Action | 世界动作模型 | (+) | 更快、更轻的开源动作模型,并提供 LeRobot 与 Jetson 集成路径 | 目前主要与高级机器人开发者相关 |
整体情绪倾向更多是按层划分,而不是按品牌划分。前沿模型被当作具有不同经济性与沟通权衡的路由目标来讨论;决策模型在能切出边界清晰的是/否型工作时受到肯定;本地技术栈则主要按安装体验和运行时现实性来评判;而最有意思的“工具”往往是 TRACES、OpenRSI、Jcode 和 Glance 这类基准或 harness 层,它们让其余技术栈变得可测量、可操作。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Keel | @Av1dlive / codejunkie99 | 以本地优先为核心的 macOS 编码工作区,可通过 Laya 或 Jev 路由任务,同时保持主机端权限归用户掌控 | 让快速决策模型能够真正用于实际编码闭环 | Rust, GPUI, ACP, Laya/Jev routing, local-first workspace | Alpha | 推文, 仓库 |
| ODS | Osmantic | 把一台机器变成私有 AI 服务器,支持本地推理、语音、智能体、工作流、RAG、搜索和图像生成 | 降低搭建本地/私有 AI 的集成负担 | Python stack, Open WebUI, local models, voice, agents, workflows | Shipped | 推文, 仓库 |
| Jcode | 1jehuang | 终端原生的编码智能体 harness,支持并行会话、记忆和公开转录 | 为开发者提供比更重的、以 IDE 为中心的智能体流程更轻量且可检查的替代方案 | Rust, TUI, semantic memory, multi-session orchestration | Beta | 推文, 仓库 |
| Nautilo | @Dan_Jeffries1 | 面向多用户组织的开放 harness,每个人都能拥有一个跨桌面、Web 和移动端持续存在的 Genie | 提供支持自托管和记忆能力的共享、持久化智能体工作区 | Self-hosted server, desktop/web/mobile clients, persistent agents, shared rooms | Alpha | 推文 |
| Glance Speedlab | @yoheinakajima | 以测量为先的本地 VLM 实验室,用于把摄像头视频流转化为低延迟检测器 | 帮助团队在不损失决策质量的前提下优化本地摄像头推理 | Python, Qwen3-VL, MLX, PyTorch MPS, reproducible benchmark harness | Alpha | 推文, 报告, 仓库 |
| Muse phone-orchestrated SEO loop | @om_patel5 | 通过手机上的 Muse Agents 运行研究、简报、起草、发布以及 Search Console 反馈闭环 | 把搜索/GEO/AEO 工作变成持续在线的迭代式内容系统 | Muse Agents, Search Console API/MCP, repo publishing workflow, content clustering | Alpha | 推文 |
| OpenRSI-Index | OpenRSI | 面向递归自我改进的公开基准,采用超长轨迹 | 为前沿式长时程智能体评测提供开放参考点 | 1k-GPU 集群运行、60+ 小时任务、公开日志/任务、贡献流程 | Beta | 推文, 代码库 |
| FLUX 3 Action | @bfl_ai | 面向机器人及其他具身控制任务的开放权重 7B 世界动作模型 | 改善了开放动作模型在实际部署中的速度/性能权衡 | 7B WAM、视频+动作联合预测、LeRobot recipes、Jetson 部署路径 | Shipped | 推文 |
Keel、ODS、Jcode 和 Nautilo 都指向同一种构建模式:真正有意思的产品层,是围绕模型构建的运行时。Keel 封装了路由和权限,ODS 封装了本地部署,Jcode 封装了可检查的执行,而 Nautilo 封装了持久化和多用户协作。
表格其余部分是在扩展这一点,而不是反驳它。Glance 和 OpenRSI 把测量与评估做成产品;CUA-S1 把计算机使用收缩为更便宜的决策层;FLUX 3 Action 让具身 AI 始终与可部署性挂钩;而 @om_patel5 展示了 则表明,同样的智能体运行时逻辑,已经被用于通过手机推动搜索增长和内容发布闭环。
6. 新动态与值得关注的进展
OpenRSI-Index 将递归自我改进基准测试带入公开视野
@AGTPinsights 披露了 OpenRSI-Index v0.1 作为递归自我改进的公开基准发布,包含在 1,000-GPU 集群上运行的 60 多小时智能体轨迹,且初始构建已投入超过 100,000 H100 小时。公开的 代码库 让它不只是一次凭感觉发帖:任务、日志和贡献流程都构成了此次发布的一部分。它之所以值得关注,是因为它试图把一个前沿实验室式的能力问题,变成开放基准,而不是封闭式宣称。
Qwen Intelligence 把智能手机当作智能体运行时,而不是聊天机器人外壳
@OmNawale45831 认为 表明,Qwen 悄然改变了“AI 手机”的含义:它把规划器、手机使用智能体和创意智能体打包在一起。被引用的 @Alibaba_Qwen 公告 声称,其在 MobileWorld 上达到 82.1,在 MobileWorld-Real 上达到 92.2,在 AndroidDaily 上约为 97,在 WebArena 上为 73.6,在 ScreenSpot-Pro 上为 81.5;同时还描述了一个包含 100 多部手机和 150 多个 app 的真实设备环境。随附图片直接展示了各项基准的细分结果,以及智能体访问与模型访问的拆分,因此承载了这项说法中最实质性的部分。


它值得关注的地方,不只是排行榜上的那一行成绩,更在于框架的变化:手机正被呈现为持久化的智能体运行时,具备工具选择、记忆、重规划,以及对审批敏感的交接能力。
FLUX 3 Action 让具身 AI 继续立足于部署权衡
@bfl_ai 介绍了 FLUX 3 Action(103 个赞、31 次转发、2,531 次浏览、34 次收藏),将其描述为一个开放权重的 7B 世界动作模型:它在 RoboLab 上领先,同时参数更少、运行速度也快于此前的开放系统。最有用的细节出现在帖子回复里:2.13 秒的动作时域、视频与动作联合预测、一个单步 checkpoint 在每秒机器人运动上的运行速度比 Pi0.5 快 1.45x-1.66x,以及一个经 guidance distillation 的 checkpoint 相比此前领先的开放 WAM 快 2.85x-3.15x,同时还提升了成功率。它之所以值得关注,是因为具身 AI 帖子往往停留在演示视频层面,而这次把可部署性的账算清楚了。
7. 机会在哪里
[+++] Solver-level evaluation and long-horizon benchmark infrastructure — The strongest cross-section signal was that people still do not trust launch-day model claims without workload-specific validation, while TRACES and OpenRSI show a clear appetite for grading the whole solver. @ZypherHQ 质疑了 基准叙事,@dr_cintas 重新诠释了 围绕工具与流程开展评测,而 OpenRSI 则把公开的长周期任务纳入产品。这一方向很强,因为痛点已经体现在用户的怀疑态度、评测者的工作,以及新基础设施的上线之中。
[+++] Private/local agent runtime tooling — ODS, Glance, Jcode, Nautilo, and the edge-inference discussion all point to a growing market for packaged local runtimes that handle deployment, measurement, memory, and permissions. @TheAhmadOsman 展示了 安装覆盖面,@yoheinakajima 展示了 测量覆盖面,以及 @babyfolio 披露了 空闲运行时的经济性。这一方向很强,因为需求既务实、反复出现,又同时分布在构建者和运营方两端。
[++] Decision-model control layers for routed systems — Jev, Keel, and CUA-S1 suggest a growing opportunity in small typed control layers that decide, score, or act before handing off to a larger model. @Av1dlive 封装了 编码工作区版本,@humzaakhalid 实现了 让用例更清晰可辨,以及 @AGTPinsights 展示了 GUI 操作版本。这一方向强度中等,因为需求显而易见,但买方是谁、如何集成,仍因领域而异。
[++] Transaction-safe action rails for commerce and mobile agents — The commerce and mobile-agent posts imply a real product gap around payments, approvals, refunds, and recovery. @Musecases 命名为 购买按钮,最好的回应则集中在退货与可信支付上,而 Qwen 以移动端使用为框架时,仍为敏感操作保留了人工接手环节。这一方向强度中等,因为痛点明确且能够变现,但信任与集成复杂度仍然很高。
[+] Persistent multi-user agent workspaces — Nautilo and the VM-runtime discussion suggest a slower-burning opportunity in shared long-lived agent environments that preserve context, tools, and memory across devices and collaborators. @Dan_Jeffries1 实现了 直接点出了 org-harness 这个案例,而 Jcode 和 babyfolio 则展示了相关的执行与隔离问题。与上述类别相比,这一方向的把握更弱一些,但信号已足够明确,值得关注。
8. 要点
- Jev 相关讨论已从解释阶段走向落地实施。 最有力的帖子已不再是“什么是 Jev?”这类说明文,而是构建指南、速查表、路由演示,以及受限计算机使用的发布;这些内容都把快速键入式决策视为一个真实的控制层。(来源)
- 关于模型的讨论仍然集中在经济性上,但观察框架已不再局限于 token 价格。 Simon Willison 在发布日对定价的梳理很重要,但 MiMo 在开放权重上的成本前沿,以及越来越多人坚持认为输出质量和可读性也是经济性的一部分,同样重要。 (来源)
- 人们越来越希望评测的是整个求解系统,而不只是模型本身。 TRACES、DSec 和 OpenRSI 都在推动讨论转向测试框架、工具、隐藏验证和长周期运行,而不是固定答案。 (来源)
- 本地/私有 AI 已成为一个产品层面的议题,而不再只是隐私口号。 ODS、Jcode、Glance 以及关于边缘部署的讨论,都聚焦于封装、延迟、内存和运行时经济性。 (来源)
- 对行动型智能体的评判标准,正在转向它们如何处理失败,而不只是看它们能否顺利走完一条“理想路径”。 那些最具体讨论电商和移动端的帖子,很快都转向了审批、退款、商户覆盖范围,以及敏感操作的交接机制。 (来源)
- 开发者的精力正转向模型之外的运行时、测试框架和基础设施。 Keel、Nautilo、Jcode、DSec 和 OpenRSI 关注的,都是让智能体能够落地运行、可检查或可衡量的底层支撑。 (来源)
- 具身与移动 AI 的讨论仍然紧扣可部署性的现实账。 Qwen 的手机智能体技术栈和 FLUX 3 Action 之所以受到关注,是因为它们把自主性与真实设备基准、权限边界或运行时速度联系了起来——而不是因为它们听上去很有未来感。 (来源)