Twitter AI - 2026-09-25
1. 大家在讨论什么
1.1 Agent 技术栈继续拆解为更专业的分层 🡕
最有分量的基础设施类帖子,争论的已不再是哪一个模型最好,而是在讨论哪一层该负责规划、哪一层该负责路由、哪一层该负责回放,以及部署后哪一层该负责诊断故障。由此呈现出的 agent 系统图景,比前一天占主导的版本更加模块化。
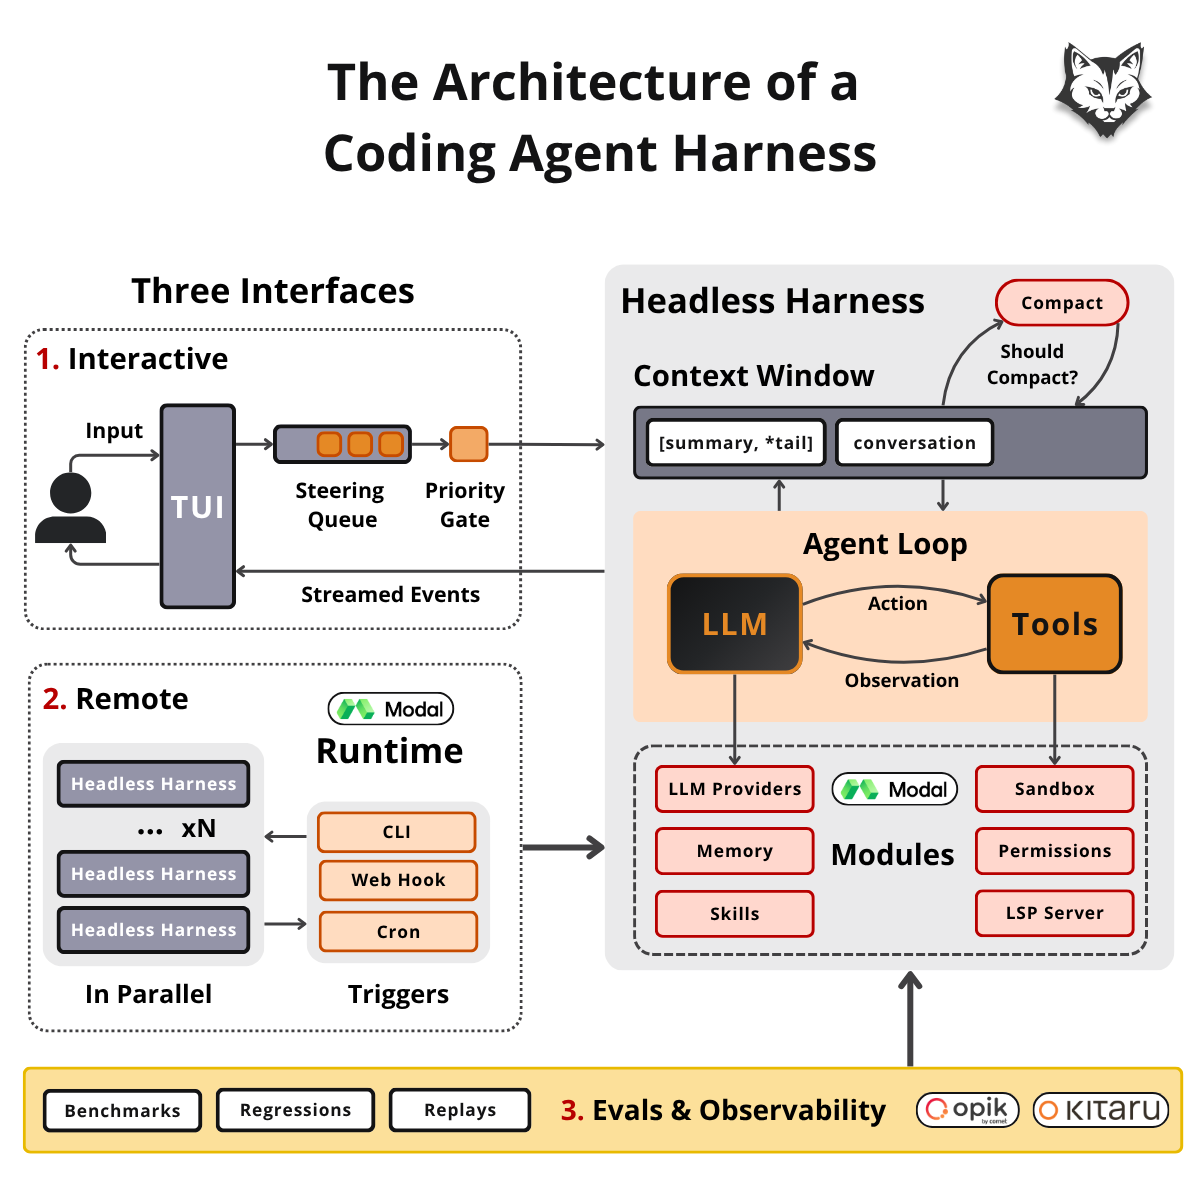
@pauliusztin_ 分享(9 个赞,14 条回复,262 次浏览)以少见的实现细节拆解了其开源编程 agent Decode 背后的技术栈:Pydantic AI 用于循环,Gemini 和 OpenRouter 用于托管模型,Modal 用于开放权重服务和远程沙箱,seatbelt/bubblewrap 用于隔离,Opik 用于追踪和评测,Kitaru 用于在不同模型或提示词下回放运行。随帖附上的架构图之所以重要,是因为它把各组件如何组合明确展示了出来:交互式和远程入口共同接入一个无头 harness,harness 在 LLM 与工具之间循环,另有独立模块负责 provider、memory、permissions 和 benchmarks。
@akshay_pachaar 解释了(11 个赞,2 条回复,1,987 次浏览,9 个收藏)讨论了 NVIDIA 和 Stanford 的 Contrastive Language Model,认为它更适合作为系统一组件来处理有界决策,而不是充当通用文本生成器。这条帖子对其机制的描述异常具体:CLM 会分别编码状态和候选动作,缓存动作嵌入,并将相似度分数转化为概率分布;作者称,这能让工具选择、路由和 verifier 类任务的延迟最多降低 9 倍。
@HacksonClark 宣布(16 个赞,14 条回复,404 次浏览)表示 SREGym 已被 NeurIPS 2026 接收,并借这条 thread 提出,下一个 benchmarking 瓶颈在于部署之后会发生什么。该 thread 称,SREGym 已从 90 个生产故障问题扩展到 125 个,覆盖应用、Kubernetes、网络、操作系统、硬件、并发故障和亚稳态故障;其公开网站和 repo 描述的重点是诊断、缓解和端到端指标,而不是单一的通过/失败式 coding 分数(网站, 仓库)。
讨论洞察: 最有价值的回复持续在追问层与层之间的接缝,而不是模型 IQ。在 Decode 的回复里,回放是否有效立刻变成了一个 repo 状态问题;在 SREGym 的 thread 中,最关键的结果是端到端解决率会因故障类别不同而最多相差 40 个点;而在更广泛的基础设施讨论中,反复出现的一个观点是:有些决策应该被评分或回放,而不是每次都从头重新生成。
与前一天的对比: 相比 2026-09-24,基础设施讨论已从 verifier 质量和分数与成本图表,扩展到更完整的控制平面:回放系统、生产事故基准,以及专业化决策层都获得了更多关注。
1.2 高风险工作抬高了“有用 eval”的门槛 🡒
关于 benchmark 的讨论依然密集,但更尖锐的观点是:如果一个团队无法在自己的工作流中定义什么才是正确答案,那么单纯拿下 benchmark 胜利并没有太大意义。实践价值最高的帖子,关注点都集中在答案键、部署风险,以及 benchmark 是否足够新鲜。
@businessbarista 报道(23 个赞,8 条回复,3,270 次浏览,29 个收藏)提到了一场与大型数据标注企业的对话,对方的核心判断是:企业 AI 的价值将存在于内部 eval 环境和专有答案键,而不在于获取那些所有人都能买到的同款公开模型。该帖还将这一点直接与采用情况联系起来:大多数公司之所以还没有明显超越 coding agent,是因为它们仍缺少让非工程类 agent 变得可靠所需的 eval 基础设施。
@rjs 写道(19 个赞,4 条回复,1,516 次浏览,39 个收藏)指出,有些软件的风险实在太高,不能靠 vibe-code 来做;随后又在一条传播更广的跟进回复中表示,“现在人人都是构建者”这一论点,模糊了一个更顽固的现实:角色分化依然源于判断力的差异。这一点之所以重要,是因为这种反驳并不反 AI;它要求的是更清晰的范围界定、更明确的问题定义,并承认某些失败的代价高到必须引入人工审查和专业专长。
@axisrobotics 介绍了(48 个赞,15 条回复,2,125 次浏览)介绍了 Open Axis Benchmark,将其定位为面向机器人操作模型的动态评测引擎。其最突出的主张是:每一轮都会锁定一组从不断扩充的任务库中抽取的新任务,因此模型必须具备泛化能力,而不是死记一个固定测试集。
讨论洞察: 回复不断从不同角度回到同一个约束:难点不在于跑一个 benchmark,而在于为某个具体业务或任务类别定义“好”究竟意味着什么,并让测试持续保持足够新鲜,避免过拟合取代真实表现。
与前一天的对比: 在 2026-09-24,eval 争论仍主要围绕公开 benchmark 分数、verifier 质量和 token 预算展开。而到了 2026-09-25,讨论重心已更明显地转向内部答案键、部署后故障,以及那些被设计为持续变化的 benchmark。
1.3 Physical AI 的瓶颈仍在数据层,但证据变得更具体了 🡕
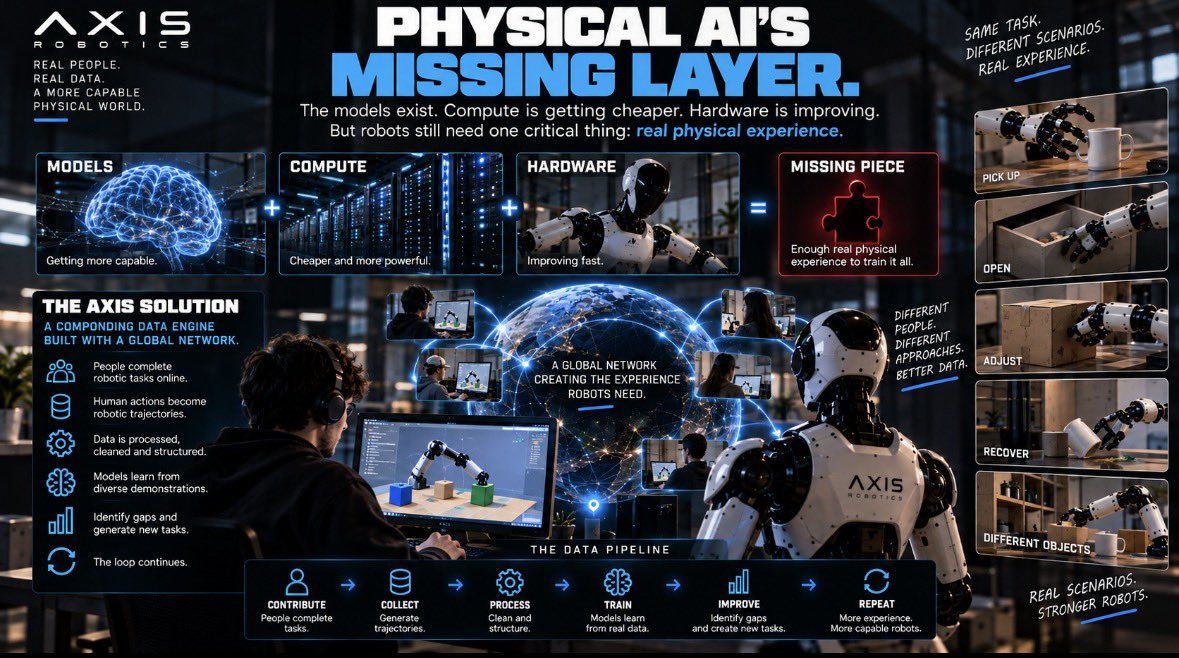
Physical AI 这组讨论的重点,主要不是模型能力层面的主张,而是真实世界经验从何而来、如何被验证,以及为什么静态 benchmark 或粗粒度感知仍会让机器人训练不足。几条经过审阅的帖子几乎采用了同样的结构:模型和硬件都在进步,但缺失的那一层,是新鲜、扎实、锚定现实的经验。@abgweb3 认为(12 次点赞、11 条回复、134 次浏览)指出,物理 AI 已经拥有模型、算力和不断改进的硬件,但仍缺少足够的真实物理世界经验。配图之所以重要,在于它把这一点转化成了一个运行闭环:贡献者演示变成轨迹,轨迹变成结构化数据,模型据此改进,新的行为缺口被识别出来,再生成下一批任务去填补这些缺口。
@elenalin01 认为(25 次点赞、22 条回复、138 次浏览)认为,物理 AI 与其说是机器人问题,不如说是真值问题。她的帖子将 Vangrid 的主张概括为:基于智能手机的空间采集、加密溯源,以及锚定在 Base 上的证明;而回复则给出了当天最有价值的质疑:消费级传感器的校准可能不够好,位置证明可能被伪造,而能否用大众市场设备取代专业车队,仍是一个悬而未决的问题。
@alex_crypto98 将其定义为 将同一问题概括为一种规模错配(19 次点赞、16 条回复、644 次浏览):卫星对于人行道级细节来说过于粗糙,企业车队要做全球更新又过于昂贵,而世界模型构建者需要一个更密集的采集闭环。配图补上了这一簇帖子里许多内容所缺少的具体信息,点明了 30 亿部智能手机、100,000+ 次已验证采集、直接链上验证,以及最近一轮 $9M 融资。

讨论洞察: 看多的帖子几乎都收敛到去中心化采集,但回复始终对可信度划出了一条明确边界:如果溯源层无法阻止伪造,或者通用传感器无法产出稳定的真值,那么光靠规模也解决不了机器人数据问题。
与前一日对比: 与 2026-09-24 相比,物理 AI 相关帖子略有增多,而且明显更偏向操作层面。讨论措辞也从宽泛的世界模型愿景,转向了可复利的数据引擎、任务库和可验证的采集管线。
1.4 消费级与智能体商业产品的叙事围绕日常习惯、身份与信任基础设施展开 🡕
相比泛泛而谈的“AI 助手”式评论,消费级智能体相关帖子要具体得多。信号最强的内容关注的是:一个智能体在视觉上如何被呈现,它是否会成为日常习惯的一部分,以及当两个智能体在没有人类介入的情况下开始交易后,将如何解决分歧。
@alexcornell 解释了(431 次点赞、38 条回复、25,293 次浏览、154 次收藏)解释了 Muse 为什么刻意把回复包裹在消息气泡里。图片展示了同一回答流程在有气泡和无气泡两种形式下的差异,而回复则补充了截图本身无法承载的产品逻辑:Muse 的设计目标是在一个统一的主线程中持续存在、处理不断增长的上下文,并主动给用户发消息,因此可见的轮次边界的重要性,是被动式搜索框所不具备的。

@sgrsagor 认为(66 次点赞、85 条回复、206 次浏览)认为,消费级 AI 的分发比大多数功能清单都更重要,并用引用的 Sleepagotchi 数据作为支撑:500K+ 注册用户、约 80K 日活,以及超过 75% 的用户会在醒来后 10 分钟内打开应用。帖子的更大判断是,围绕睡眠、健身、购物和生产力等日常习惯构建的垂直智能体,可能比又一个独立的通用助手更有切入优势。
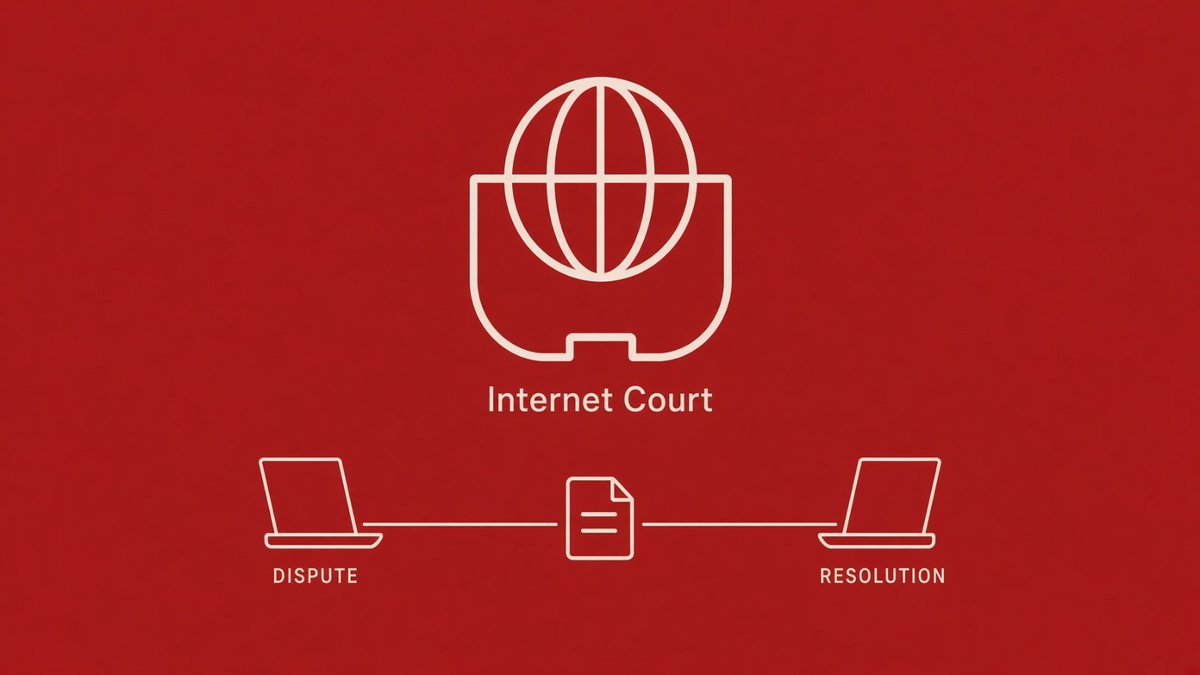
@d3rekson 描述了(24 次点赞、12 条回复、498 次浏览)提出将 Internet Court 作为智能体商业的争议处理层:机器人会预先选择路线,证据会被自动打包,并由三个不同的 AI 法官审理案件,而不是交给单一模型。配图很简单,但它让这一主张呈现为基础设施,而不只是一种比喻。
讨论洞察: 在整个商业相关讨论簇中,回复始终在区分炫目的自动化与更棘手的信任问题。@0xvati 认为(46 次点赞、6 条回复、7,378 次浏览、13 次收藏)指出,支付、验证、声誉、发现与争议处理才是真正的协同层;@Loreen2074591 补充说(29 次点赞,21 条回复,279 次浏览)认为,一旦代理开始反复相互雇佣,持续的工作履历比精心打磨的个人资料更重要。
与前一天相比: 2026-09-24 的商业讨论聚焦于激励机制、商家基础设施和治理。到了 2026-09-25,讨论又补充了两方面的产品形态证据:消费端的产品形态,以及商业端更清晰的信任原语,包括单线程式用户体验、日常留存、争议处理路径,以及持久的工作记录。
2. 什么让人感到挫败
一旦工作变得昂贵、具体或进入部署阶段,基准测试就会变得不那么可靠
最反复出现的挫败感是:一旦任务的失败代价真实存在,公开基准分数就远远不够。@businessbarista 报道(23 次点赞,8 条回复,3,270 次浏览,29 次收藏)指出,企业越来越把内部评测环境和参考答案视为专有知识产权,因为正是这些东西,才能让非工程类代理在自身工作流中变得可靠。@rjs 表示(19 次点赞,4 条回复,1,516 次浏览,39 次收藏)表示,有些软件风险太高,不适合靠 vibe-code 来做;而他随后那条互动更高的回复则认为,只要一个人无法判断所有失效模式,角色边界就会重新出现。
同样的抱怨也出现在基准设计本身。@HacksonClark 写道(16 次点赞,14 条回复,404 次浏览)指出,SREGym 的表现会因故障类别不同而相差高达 40 个百分点;与此同时,@axisrobotics 认为(48 次点赞,15 条回复,2,125 次浏览)认为,冻结不变的机器人基准会误导模型去记忆测试,而不是学会泛化。严重性:高。当前可见的变通办法包括自定义参考答案、真实环境事故测试套件,以及持续演进的任务库;这仍然值得投入建设,因为这些抱怨针对的是运营层面的信任,而不是表面的排行榜展示。
物理 AI 仍难以获得足够可信的真实真值
第二个明确的挫败点是,更好的模型和更便宜的算力并不能解决经验缺失的问题。@abgweb3(12 次点赞,11 条回复,134 次浏览)表示 机器人需要真实的物理经验,而不只是更好的权重;@elenalin01 表示(25 次点赞,22 条回复,138 次浏览)认为,物理 AI 存在真值问题;而 @alex_crypto98 补充说(19 次点赞,16 条回复,644 次浏览)则指出,卫星数据过于粗糙,而专用采集队伍若想在全球范围内持续保持数据新鲜,成本又太高。
之所以说这是真正的挫败,而不是一句营销口号,是因为回复中的怀疑态度非常明显。人们质疑智能手机传感器的校准是否足够、溯源系统能否在大规模场景下阻止伪造,以及去中心化贡献者能否持续足够长时间提供有用样本,从而真正产生影响。严重性:高。当前的应对策略包括贡献者网络、加密证明,以及能够生成新缺口的基准/任务引擎;但从这些讨论串层面的证据来看,这仍是一个尚未解决的系统性问题,因此也是一个很强的建设方向。
代理与代理之间的商业仍缺少验证、声誉和争议处理机制
商业相关讨论不断回到同一个缺失层:代理在演示中已经能够谈判和交易,但它们仍难以证明工作质量、保留声誉,并以低成本解决分歧。@0xvati 特别指出(46 次点赞,6 条回复,7,378 次浏览,13 次收藏)提到,支付、验证、结算、声誉和发现机制,都是没人愿意去建的底层管道。@d3rekson 描述了(24 次点赞,12 条回复,498 次浏览)之所以提到互联网法院,恰恰是因为对于 5 美元的自主微任务而言,人类法院太慢也太贵;而 @Loreen2074591 认为(29 次点赞,21 条回复,279 次浏览)则认为,一旦代理彼此反复雇佣,持续的工作履历比资料包装更重要。
回复并没有解决这个问题,反而让失效模式更清晰:验证可能漏掉带有主观判断的补救决定;随着风险升高,第二意见会变得更重要;而一次技术上正确的裁决,仍可能无法保住一段有价值的关系。严重性:中高。当前的变通模式是预先选定争议处理路径、自动打包日志,并随时间积累代理收据;这看起来值得投入建设,因为每一种变通办法,本质上都在手工搭建一层信任基础设施。
3. 人们希望看到什么
团队能够信任的、面向特定工作流的评测系统
最明确、最实际的需求,是能贴合公司真实风险面的评测基础设施,而不只是一个公开排行榜。@businessbarista 表示(23 个赞,8 条回复,3,270 次浏览,29 次收藏)内部评测环境和答案集正逐渐成为专有 IP,@rjs 表示(19 个赞,4 条回复,1,516 次浏览,39 次收藏)有些软件风险太高,不适合用 vibe-code 来开发,以及 @HacksonClark 展示了(16 个赞,14 条回复,404 次浏览)即使是处理生产事故的 agent,其表现也会因故障类别不同而差异极大。这是一个紧迫度很高的现实需求。SREGym 和 Open Axis Benchmark 目前对此有所覆盖,但从信息流来看,大多数团队仍缺少贴合工作流的答案集和故障测试套件。机会:直接。
面向 agent 与 agent 协作的协调、声誉与争议处理层
这里人们要的不是更聪明的文案,而是朴实可靠的轨道。@0xvati 希望(46 个赞,6 条回复,7,378 次浏览,13 次收藏)一个覆盖支付、验证、结算、声誉和发现的通用协调层,@d3rekson 提出(24 个赞,12 条回复,498 次浏览)一条面向低价值机器商业的 AI 裁决争议路径,以及 @Loreen2074591 认为(29 个赞,21 条回复,279 次浏览)持续的工作履历在招聘后会比基准测试更重要。这是一个紧迫度中高的现实需求。早期组件已经存在,但从信息流来看,还没有任何方案接近成为共享默认。机会:直接。
可复用的控制平面组件,让团队能拼装 agents,而不是购买单体系统
第三类需求是那些嵌在模型与实际工作之间的组件,而不是同时替代两者。@pauliusztin_ 展示了(9 个赞,14 条回复,262 次浏览)一个由 Pydantic AI、Modal、Opik、Kitaru 和沙箱工具拼装而成的定制 harness,@itsjdraven 披露了(4 个赞,4 条回复,474 次浏览,5 次收藏)My Free Code 作为多个 coding agents 的路由与回退网关,以及 @RoundtableSpace 重点提到(10 个赞,2 条回复,26,836 次浏览,7 次收藏)Cua 作为让 agents 获得真实计算机的开源技术栈。对构建者而言,这是一个紧迫度很高的现实需求,但这个领域已经相当拥挤,也已有若干可信实现。机会:竞争型。
面向物理 AI 的真实数据基础设施
信息流中的机器人方向不断指向同一个缺失的产品:某种能比专用采集团队更快产出新鲜、可信现实世界经验的系统。@abgweb3 描述了(12 个赞,11 条回复,134 次浏览)一个复利式数据引擎,@elenalin01 聚焦于(25 个赞,22 条回复,138 次浏览)关于可由密码学证明的采集,以及 @alex_crypto98 关联到(19 个赞,16 条回复,644 次浏览)将这一问题推向全球规模与时效性。这是一个现实需求,但由于伪造与校准仍是持续存在的反对点,它依然资本密集且对公信力高度敏感。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Pydantic AI | Agent 框架 | (+) | 让模型/工具循环保持简单且可组合,适合定制 harness | 仍需要团队自行在外围搭建控制平面 |
| Modal | 云运行时 / 沙箱 | (+) | 可在同一平台运行远程沙箱、开放权重服务和并行触发 | 在 agent 循环之外增加了部署和运行时复杂度 |
| Opik | 可观测性 / 评测 | (+) | 可在同一栈中追踪会话,并支持基准、回归和在线评测 | 适合作为观测与埋点工具,但不是独立的答案集系统 |
| Kitaru | 回放 / 优化 | (+/-) | 可针对新提示词或新模型回放运行过程,而无需重做工具调用 | 当底层仓库或环境变化时,复用输出可能失效 |
| SREGym | 基准平台 | (+) | 在贴近真实的故障场景上评估诊断、缓解和端到端事故解决能力 | 基础设施负担重,且高度依赖故障类别的覆盖度 |
| Open Axis Benchmark | 机器人基准 | (+) | 新鲜任务集与不断扩展的任务库推动模型走向泛化而非记忆 | 仍处于早期,其价值取决于任务生成质量能否持续 |
| my-free-code | AI 网关 | (+) | 为 coding agents 提供多提供商路由、顺序回退、健康退避和稳定的模型标识 | 代理配置和本地安全加固本身就是运维负担的一部分 |
| Cua | 计算机使用栈 | (+) | 为 agents 提供桌面、本地 VM、专用计算机使用模型和基准工具 | 功能强大,但对大多数团队而言仍更像一套技术栈,而非即插即用 |
| CLM | 决策模型 | (+) | 缓存动作嵌入有望实现低延迟的工具选择、路由和 verifier 式评分 | 仅在候选动作集合已知时才有效 |
| Jev-Mem | 记忆架构 | (+) | 使用轻量控制器,在提升检索质量的同时缩短记忆构建时间和查询延迟 | 目前证据仍停留在论文阶段,尚未成为被广泛使用的产品 |
| Vangrid | 物理数据网络 | (+/-) | 推动围绕真实数据采集建立大范围空间采集、来源证明和可验证结算 | 回复中质疑了其抗伪造能力、校准质量和长期贡献者激励 |
| Internet Court | 争议解决层 | (+/-) | 打包证据,并使用多模型裁决小组处理低价值自治争议 | 主观性的补偿裁定和关系权衡仍无法完全纳入正式规则 |
整体满意度是按层划分,而不是按供应商划分。Pydantic AI、Modal、Opik、Kitaru、my-free-code 和 Cua 这类框架与控制平面工具之所以得到正面讨论,是因为它们解决了特定的运营衔接问题。相比之下,Vangrid 和 Internet Court 引发了更复杂的反应,不是因为这些想法被否定了,而是因为其背后的信任假设在回复中遭到了直接质疑。
常见的变通模式是拆解。构建者并不是要求某一个 frontier model 包办一切,而是描述了一套栈:一个组件负责规划,另一个负责路由或评分,另一个负责回放/评测,还有一个负责执行环境。这种模式也同样出现在评测中:SREGym 的真实云端事故、Open Axis 的新鲜任务库,以及 Jev-Mem 和 CLM 的独立控制逻辑。
竞争态势并不是一个基础模型取代另一个。真正的竞争发生在那些围绕模型、试图成为默认连接点的专用层之间:网关、回放器、记忆控制器、桌面环境和基准引擎。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 | |---|---|---|---|---|---|---|| Cua | trycua | 面向计算机使用的开源技术栈,为智能体提供桌面环境、本地 VM、专用决策模型和基准测试工具 | 让智能体能够操作真实计算机,而不是被困在聊天界面或仅限 API 的循环中 | 桌面自动化、隔离式云桌面、本地 macOS/Linux VM、CUA-S1、Cua Bench | Beta | 推文, 代码库, 网站 | | My Free Code | hkqr | 面向 Claude Code 和其他编程智能体的多提供商网关 | 为团队提供路由、故障切换和提供商抽象层,而不是把每个智能体都绑定到单一厂商 | Python、FastAPI、兼容 Anthropic/OpenAI 的端点、提供商适配器、故障切换路由 | Beta | 推文, 代码库 | | Decode | @pauliusztin_ | 带有沙箱、追踪和回放功能的定制编程智能体 harness | 帮助开发者自行组合和检查自己的编程智能体,而不是购买一个大而全的单体系统 | Pydantic AI、Gemini、OpenRouter、Modal、seatbelt/bubblewrap、Opik、Kitaru | Alpha | 推文 | | SREGym | SREGym | 面向 AI SRE 智能体的基准测试平台,用于解决接近真实线上场景的生产事故 | 衡量软件在生产环境中出故障后,智能体实际会做什么 | Python、Docker/Kubernetes、实时云环境、可观测性工具、基准排行榜 | Beta | 推文, 代码库, 网站 | | Open Axis Benchmark | @axisrobotics | 面向机器人操作模型的动态基准引擎 | 防止对固定不变的机器人任务集产生过拟合 | Axis Library、全新任务集锁定、持续任务生成、OpenRoboto 协作 | Beta | 推文 | | SFR-AutoR&D | @SFResearch | 可自主运行的研发闭环,能够发现、构建、评估实验并从中学习 | 推动智能体从写代码走向在仓库或模型上实现可度量的改进 | Discover/Build/Evaluate/Learn 工作流、可复现实验、仓库/模型目标、预算边界 | Alpha | 推文, 网站 |
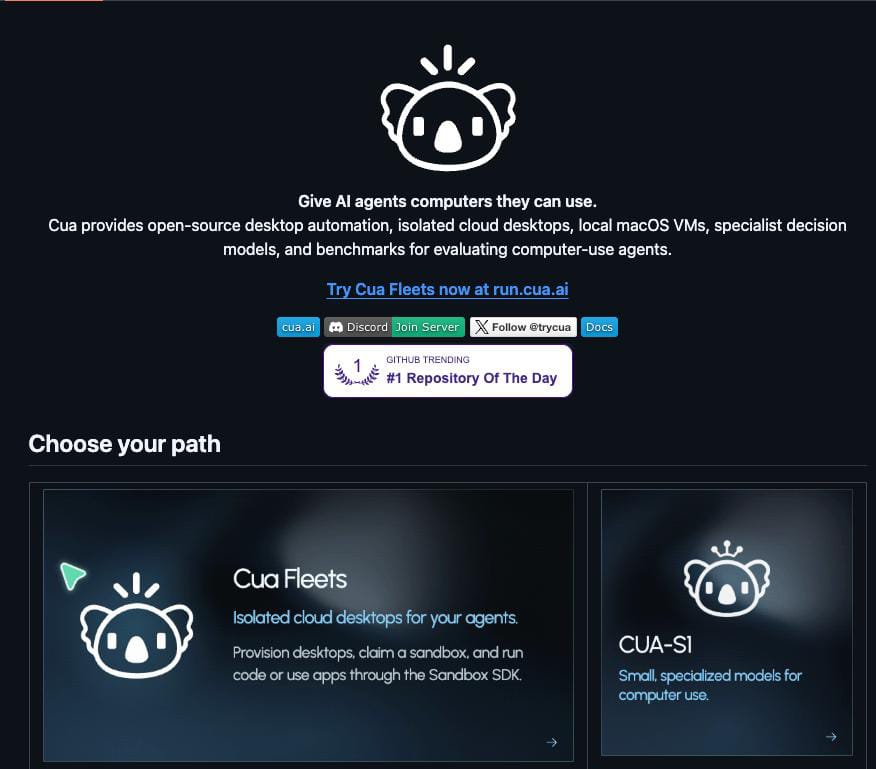
在这组面向开发者的项目里,Cua 是最清晰的增长势头信号。@RoundtableSpace 指出(10 个赞、2 条回复、26,836 次浏览、7 次收藏)称,它已成为 GitHub 上排名第一的热门趋势仓库;而公开仓库和 README 展示的并不是一个狭窄的演示,而是一整套横跨云端集群、本地 VM、专用决策模型和基准测试工具的技术栈。这让它格外值得注意,因为它把完整的计算机使用能力面打包进了一个开源系统。
My Free Code 和 Decode 从不同方向指向了开发者相同的直觉。My Free Code 把编程智能体基础设施变成一个网关问题——路由、故障切换、稳定的模型标识,以及提供商健康状态;而 Decode 则把它变成一个 harness 问题,聚焦远程沙箱、可回放追踪和明确的模块边界。两者的构建动机都来自同一个痛点,这一点在信息流其他地方也很明显:团队想要的是围绕智能体行为的控制面,而不只是又一个模型端点。
SREGym 和 Open Axis Benchmark 则把这种模式延伸到了评测领域。SREGym 把生产事故当作工作单元,衡量诊断与缓解;Open Axis Benchmark 则把固定任务套件视为失效模式,并持续从一个动态演进的库中抽取新的机器人任务。两者都是对同一触发因素的回应:一旦智能体开始对公开基准过拟合,这些基准的参考价值就会下降。
SFR-AutoR&D 则把开发者图景从编程和运维进一步扩展了出去。@SFResearch 展示了(2 个赞、1 条回复、365 次浏览)展示了一个闭环:智能体先提出一个假设,再构建方法、进行评估,并且只保留经过验证的收益;这比“生成代码然后碰运气”要严格得多。这张图之所以重要,是因为它把这种带检查点的结构明确展示了出来。

反复出现的构建模式已经很清楚:人们正在围绕模型交付控制平面、基准引擎和执行环境,而不是宣称某一个新模型就能解决一切。第二个模式则是面向重复使用的信任基础设施——工作历史、争议处理层和可验证结果——它们正在商业、运维和机器人相关讨论中各自独立浮现。
6. 新的和值得关注的内容
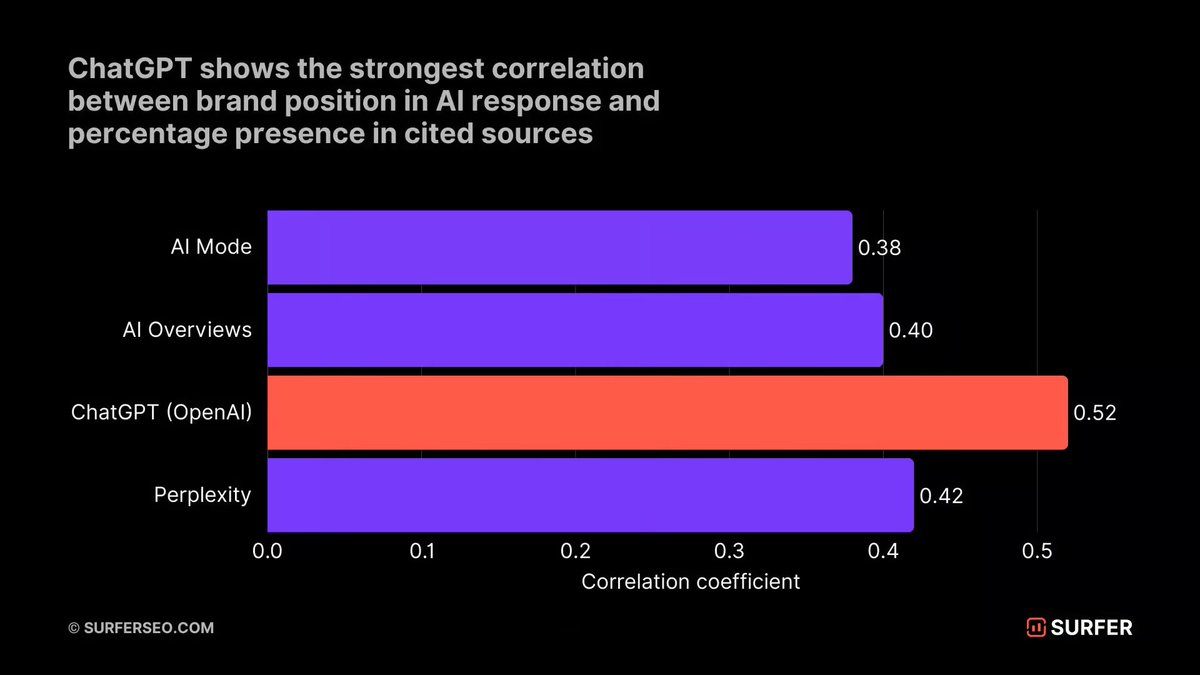
AI 搜索优化迎来了迄今最清晰的“引用经济学”案例研究@alexgroberman 详细介绍了(18 次点赞、7 条回复、1,079 次浏览、5 次收藏),一项 Surfer 研究覆盖了 26,573 次 AI 调用、289,105 个被引用 URL,以及 12 个行业中近 1,000 条提示词。主图之所以重要,是因为它把核心论点落到了实处:在这组数据中,ChatGPT 在“品牌出现在被引用来源中”与“推荐排序位置”之间呈现出最强的报告相关性(0.52),高于 Perplexity(0.42)、Google AI Overviews(0.40)和 Google AI Mode(0.38)。同一条帖子还称,ChatGPT 的引用来源数量比 AI Mode 多 84.7%,比 AI Overviews 多 129.7%,这让站外品牌提及显得不是更不重要,而是更重要。
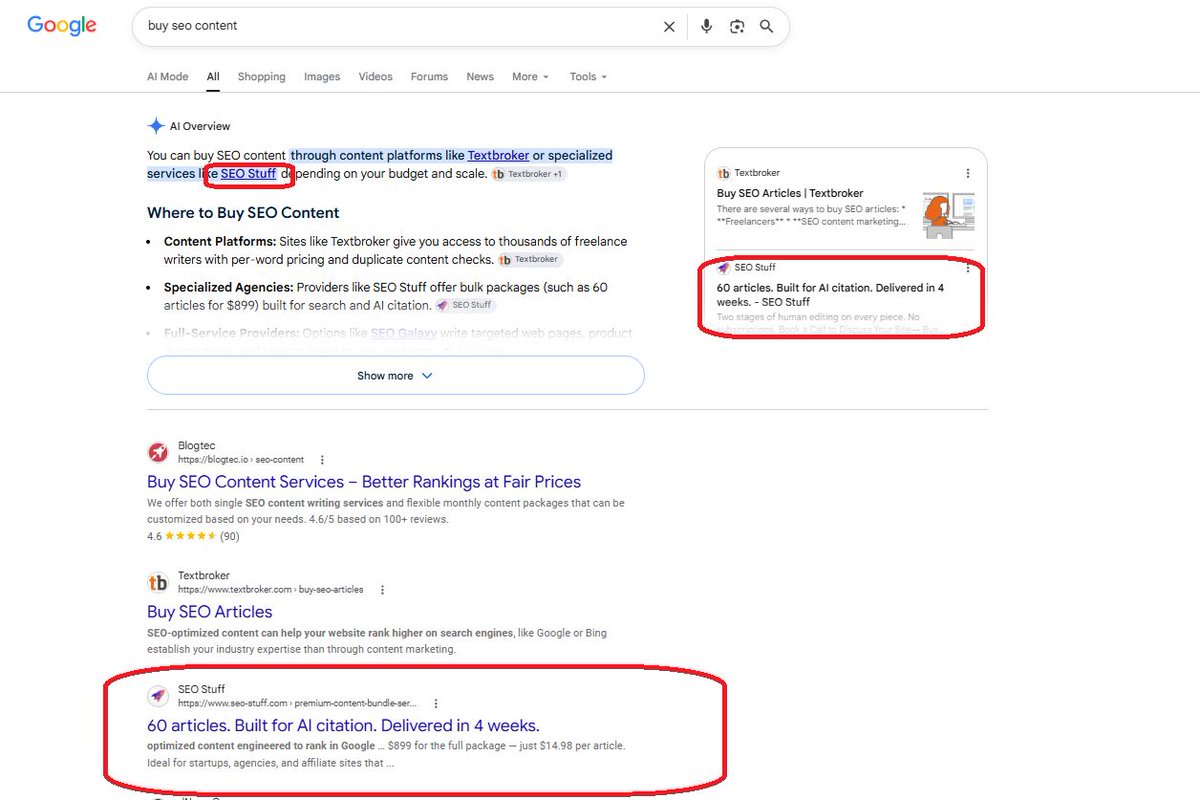
这条帖子之所以更值得关注,还因为它并未停留在理论层面。所附截图之一显示,Google AI 和搜索结果中出现了一项承诺提供“60 篇文章。专为 AI 引用打造”的服务,这让 AI 搜索优化从一个模糊的营销口号,变成了一门具体的供给侧生意。
Jev-Mem 用硬指标量化了控制器主导的记忆
@omarsar0 重点提到(6 次点赞、861 次浏览、9 次收藏),一份 Jev-Mem 报告将记忆视为控制问题,而不是更大上下文的问题。可见的结论足够具体,因此值得关注:一个轻量级控制器负责记忆类型划分、路由、检索预算、图遍历、评分和停止;记忆构建速度提升 6.6 倍;平均查询延迟下降 36.7% 至 0.93 秒;系统在由 LLM 担任裁判的 LoCoMo 上取得 0.777 分。这让它成为当天更广泛“转向专业化层”趋势的一个有价值延伸。
LongCat 2.5 预览展示了如今发布说法会多快遭到基准质疑
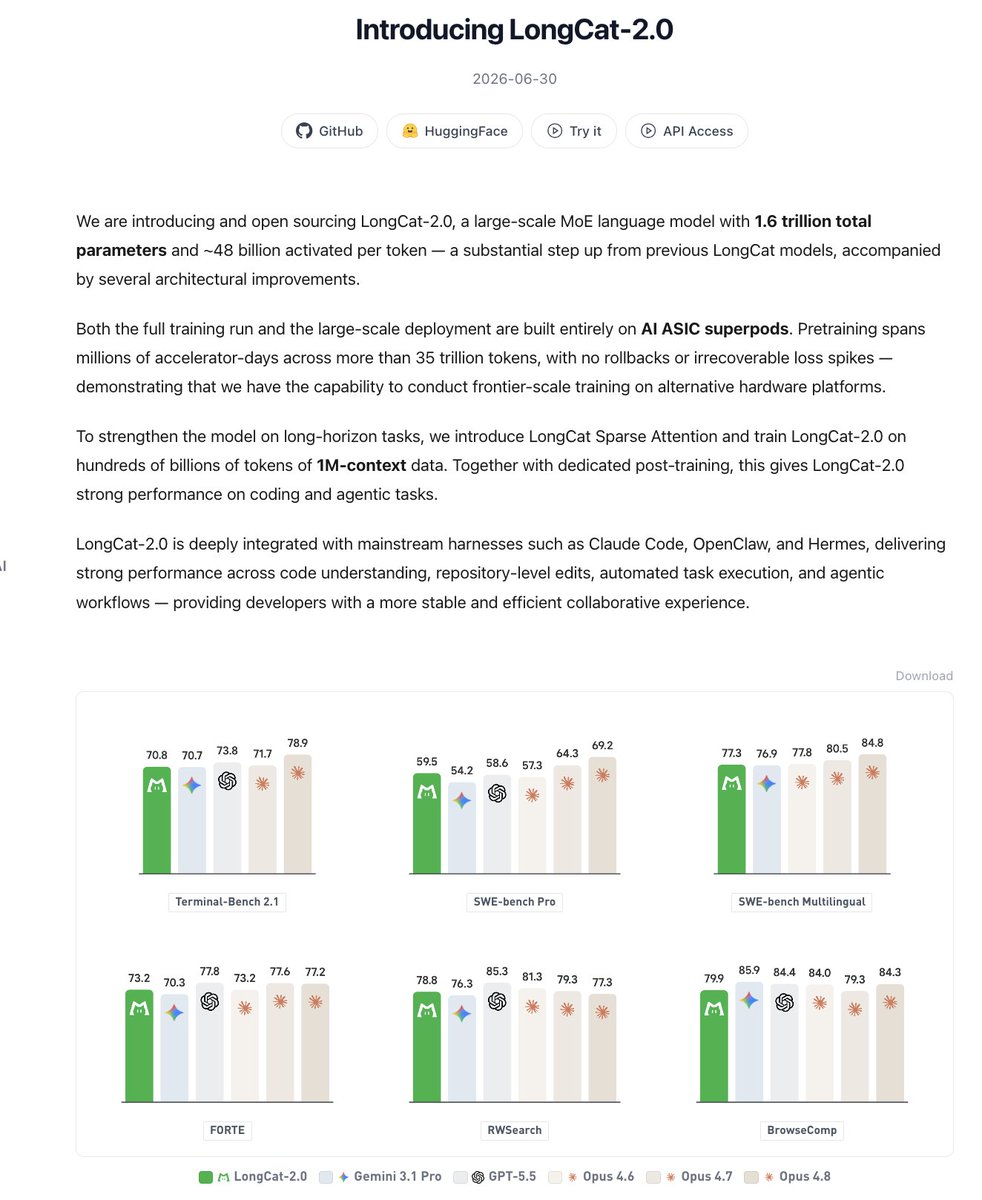
@teortaxesTex 批评了(65 次点赞、5 条回复、4,407 次浏览、17 次收藏),LongCat 2.5 Preview 之所以引人关注,不是因为这次发布显得小,而是因为它在没有拿出新的基准证据的情况下,却显得声势很大。所附截图仍然突出了一系列重磅说法——1.6T 参数、约 48B 激活参数、1M 上下文、与 Claude Code/OpenClaw/Hermes 集成,以及较早的基准柱状图——而帖子及回复始终在追问同一个问题:这个版本的新基准结果在哪里?
7. 机会在哪里
[+++] 面向工作流的评测与事故基础设施 —— 这是最强的跨板块信号。Businessbarista 的企业答案键论点、rjs 对高风险场景的警告、SREGym 的生产故障基准,以及 Open Axis Benchmark 的新任务设计,都指向同一个缺口:团队需要的是部署后能匹配自身故障模式的评测,而不只是公开基准上的炫耀资本。
[+++] Agent 协调、信誉与争议处理机制 —— 0xvati 关于协调层的帖子、d3rekson 的 Internet Court 流程,以及 Loreen2074591 关于工作历史的论点,都汇聚到重复性自主工作所需的信任基础设施上。这个机会之所以强,是因为底层需求横跨支付、验证、信誉与结算,而不是某一个狭窄功能。
[++] 计算机使用与网关控制平面 —— Cua、Decode 和 My Free Code 显示,开发者正在围绕模型封装桌面、沙箱、路由、回退、回放和提供商抽象。这是一个扎实的机会,但竞争也已明显升温,因为已有多个严肃项目在追逐这一控制面的相邻切片。
[++] 物理 AI 的真实世界真值引擎 —— Axis Robotics 和 Vangrid 从不同方向瞄准了同一个瓶颈:生成更多真实世界经验,对其进行验证,并保持任务/数据管线持续更新。这个机会很有意义,因为痛点已经被明确指出,但可信度和数据质量仍是现实中的主要质疑点。
[+] AI 搜索引用情报 —— Surfer 研究以及所附付费“AI 引用”服务截图表明,一个围绕“追踪回答引擎引用哪些来源,以及品牌露出如何影响排名”的新兴细分市场正在形成。它仍处于早期,营销色彩也较重,但这些数据让它比此前多数日子的讨论更具体。
8. 要点
- Agent 构建者越来越关心模型周边的层,而不只是模型本身。 Decode 公布的技术栈、CLM 的缓存决策层,以及 SREGym 的生产事故基准,都表明路由、回放、沙箱和部署后诊断正在成为一等产品层。(来源)
- 企业采用仍然取决于答案键和面向工作流的专项评测。 当天最强的面向企业帖子认为,公司的评测环境正在变成专有 IP,而且许多团队仍然无法让非工程类 Agent 可靠运行。(来源)
- “风险高到不该靠 vibe coding”正逐渐成为一种现实中的边界,而不只是口号。 rjs 的帖子及其后续回复,将问题重新框定为判断力与角色分工:当失败成本高到一定程度时,人们依然希望有更精准的范围界定、明确的审查,以及专业化的专门能力。 (来源)
- 关于 Physical AI 的讨论不断绕回同一个问题:缺少真实真值。 这一天里反复出现的是同一套论点:机器人需要新鲜的物理世界经验,静态基准和粗糙感知都不够,而溯源只有在能经受住校准与欺骗质疑时才有意义。 (来源)
- 消费级 AI 最有势头的地方,似乎仍是 agent 能嵌入日常流程,或对应一种持续存在的身份。 Muse 的单线程气泡式框架,以及 Sleepagotchi 早晨一打开就使用的行为模式,都表明:比起再增加一套抽象的“助手”功能清单,使用模式和产品形态或许更重要。 (来源)
- Agent-to-agent commerce 在实现规模化之前,仍需要一层不起眼但必不可少的信任机制。 仅靠支付并不足以让信息流里的讨论者买账;缺失的部分是验证、争议处理和持久声誉,无论它被表述为协调层、AI 法庭,还是 agent 的工作履历。 (来源)
- AI 搜索优化正从口耳相传的经验之谈,走向可衡量的引用策略。 Surfer 那条讨论并未证明因果关系,但它确实给构建者提供了一份具体的数据集、一张相关性图表,以及一个清晰可见的付费“AI 引用”服务市场。 (来源)