Twitter AI - 2026-09-26
1. 人们在讨论什么
1.1 专用智能体控制平面正从概念走向实际操作层 🡕
最值得注意的智能体相关帖子,已经不再只是说“用更小的模型做路由”。它们开始公开控制层本身:路由器能看到什么、评判器如何校准不确定性、哪些记忆会跨会话共享,以及自主性应如何只在证据充分后逐步扩大。至少有六条经审阅的帖子都集中在这一方向上,使这一话题相比 2026-09-25 更偏向可操作的系统层面。
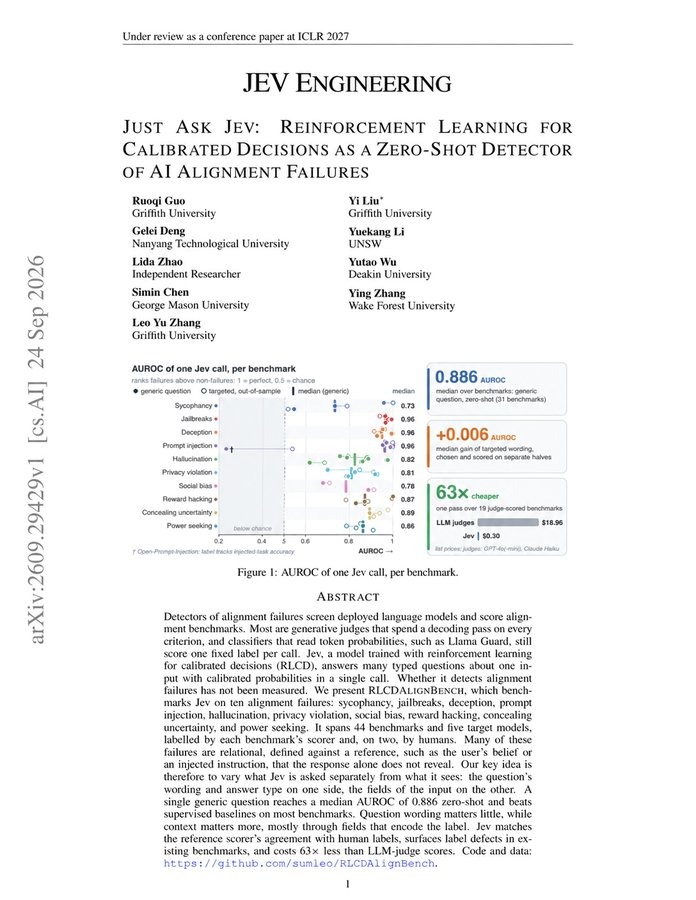
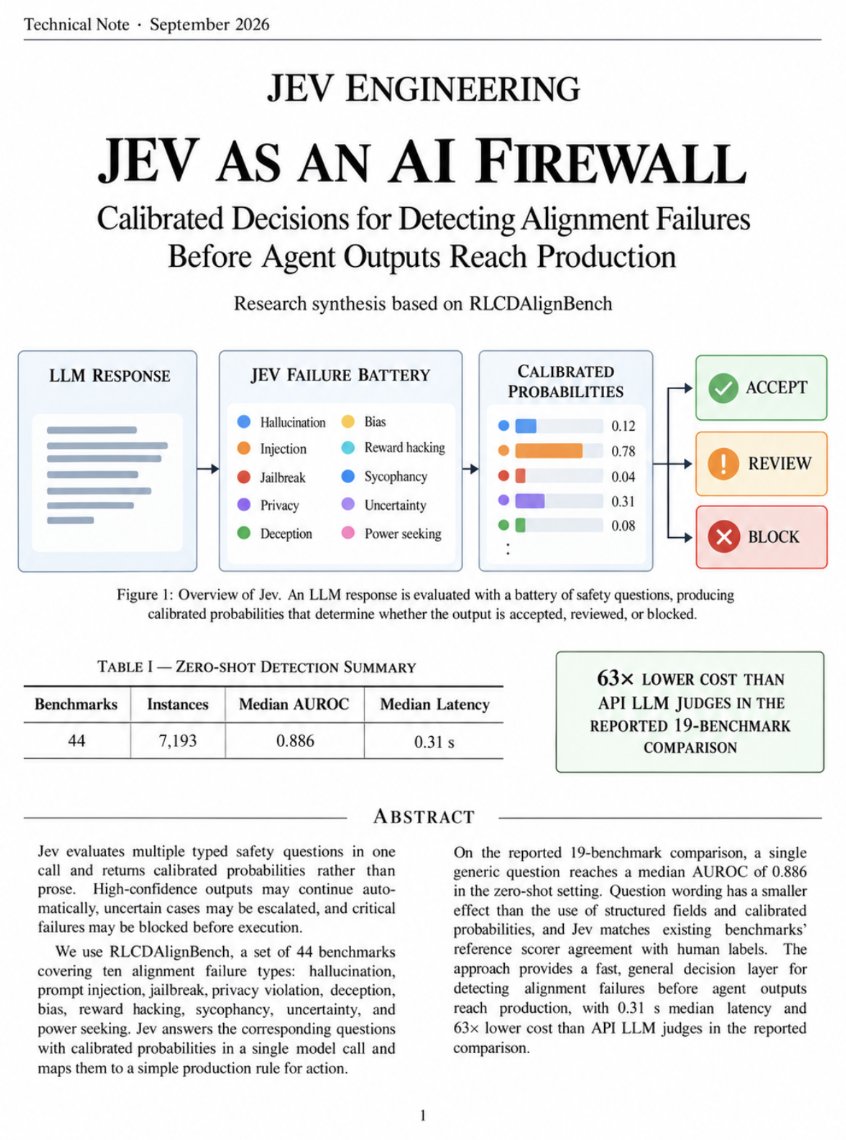
@RoundtableSpace 表示(29 个赞,11 条回复,52,429 次浏览,26 次收藏)称,JEV research 在 10 类失败类型上测试了 7,193 条回复,AUROC 中位数达到 0.886,并且在 19 个基准上将评判成本降至 $0.30,而 LLM judges 为 $18.96。其特别之处不只在于便宜,更在于结构设计:保留概率输出而非简单的是/否判断,向评判器提供源上下文,并把不确定案例路由至另一轮复核。
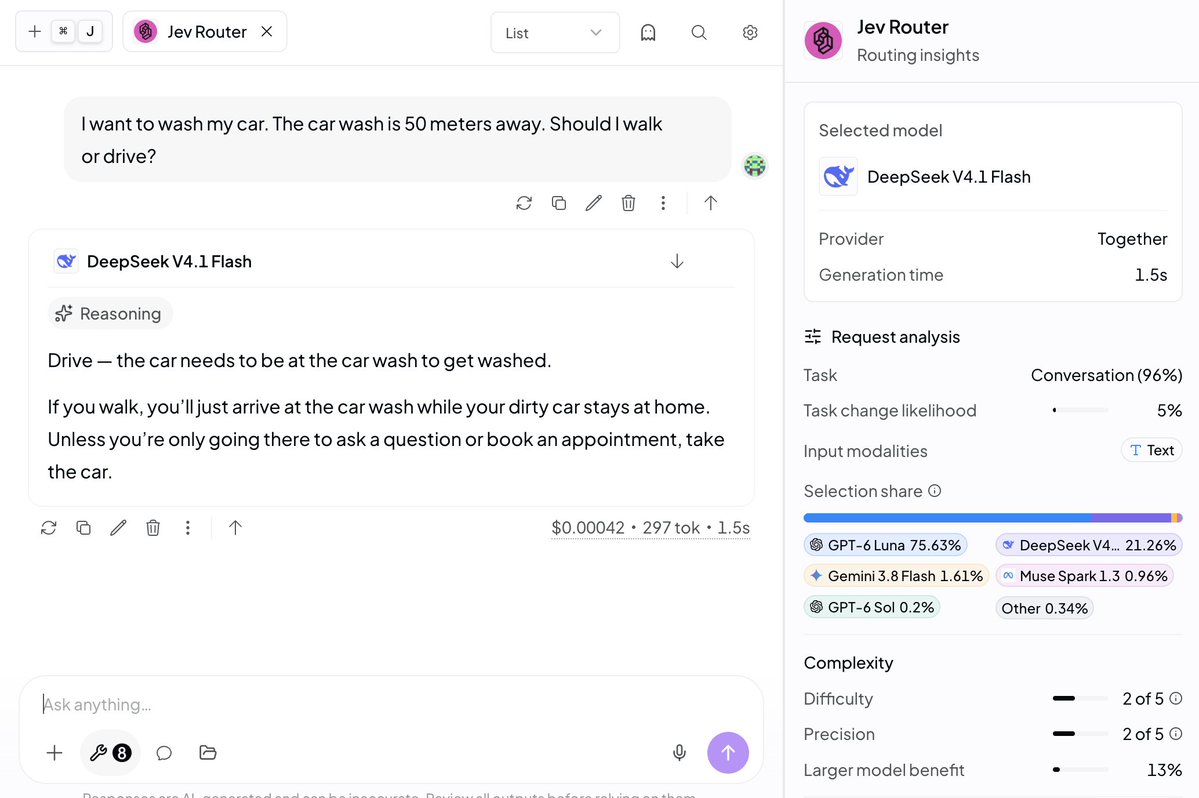
@alexatallah 宣布(50 个赞,9 条回复,6,606 次浏览,20 次收藏)展示了 Jev Router 作为 Chatroom 内部具备缓存感知能力的模型路由器。截图之所以重要,是因为它直接暴露了运行逻辑而非将其隐藏起来:所选模型、提供方、生成时间、请求分析,以及 GPT-6 Luna、DeepSeek V4.1 Flash、Gemini 3.8 Flash、Muse Spark 等模型之间的选择占比。
@beamnxw 介绍(32 个赞,10 条回复,536 次浏览,17 次收藏)展示了 64 个智能体及子智能体会话共享一份只追加的记忆,其中记录了决策、证据和理由。在三天内的 178 次配方检查中,68% 证实了先前决策,约 4.5% 改变了智能体的行动;最让人印象深刻的例子是,一个智能体删除了一个看似未使用的数据库索引,直到人工复测后才推翻该决定,并将这次修正记录下来供后续会话使用。
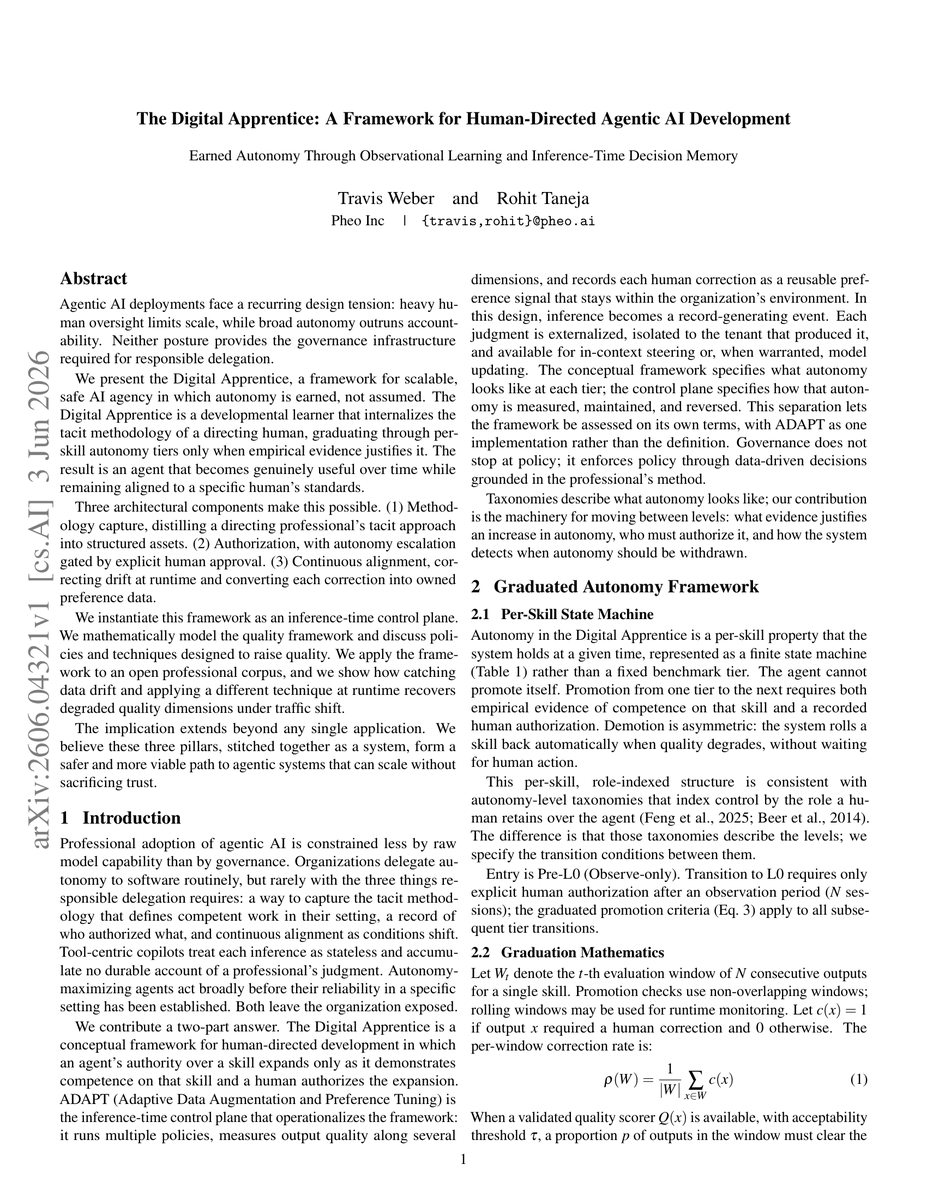
@beamnxw 强调(20 个赞,11 条回复,373 次浏览,16 次收藏)介绍了 Digital Apprentice 框架,将其作为一种按技能划分的授权系统:智能体从低自主性起步,只有在经验证明后才能获得更多权限。论文页面让这一框架变得更具体:观察式学习、层级之间明确的人类批准,以及持续对齐,而不是一次性的权限切换。
讨论洞察: 回复讨论的重点,已经不太是这一类别是否可行,而更多转向失败边界。在 JEV 线程中,人们担心封闭的失败分类体系会漏掉新的错误类型;在路由器线程中,warm-prefix 与 cold-model 行为之间的差异成了真正的系统问题;在 Digital Apprentice 的回复中,按技能设门之所以受到称赞,恰恰是因为它避免了一开始就授予全面自主权。
与前一天的对比: 相比 2026-09-25 当时信息流还在将整套技术栈拆分为 replay、sandbox 和 benchmark 等层,2026-09-26 又往下深入了一层,进入更具体的智能体治理:路由器、评判器测试组、共享决策轨迹,以及分级自主性。
1.2 具身智能讨论聚焦于数据引擎、新任务与缺失的本地适配 🡕
与前一天相比,具身智能相关帖子更多,也更具体。共同观点已不再只是“机器人需要更多数据”,而是有用的机器人数据必须始终与新的任务库、公开基准循环,以及车队再训练与真正本地适配之间的差距绑定在一起。五条经审阅的帖子从略有不同的角度汇聚到了这一框架上。
@still_gm 写道(57 个赞,65 条回复,547 次浏览)称,Open Axis Benchmark 是一个基于 OpenRoboto 构建的动态基准引擎,其中每一轮都会从不断增长的 Axis Library 中锁定一套全新的任务集。这一点之所以重要,是因为它的整体主张就是反记忆化:用训练机器人的同一套数据引擎,也让评测持续变化。
@HVnS42442600 认为(93 个赞,114 条回复,2,536 次浏览)称,真正重要的数字不是五百万条轨迹,而是任务覆盖度与测量能力。帖子提到超过 1,800 个任务、150 万条评测轨迹,以及 π0.5 + AXIS 在 LIBERO-Plus 上从 83.9% 提升到 88.8%,而附带图示则将这一论点明确呈现为“任务 → 数据 → 训练 → 测量”的闭环。

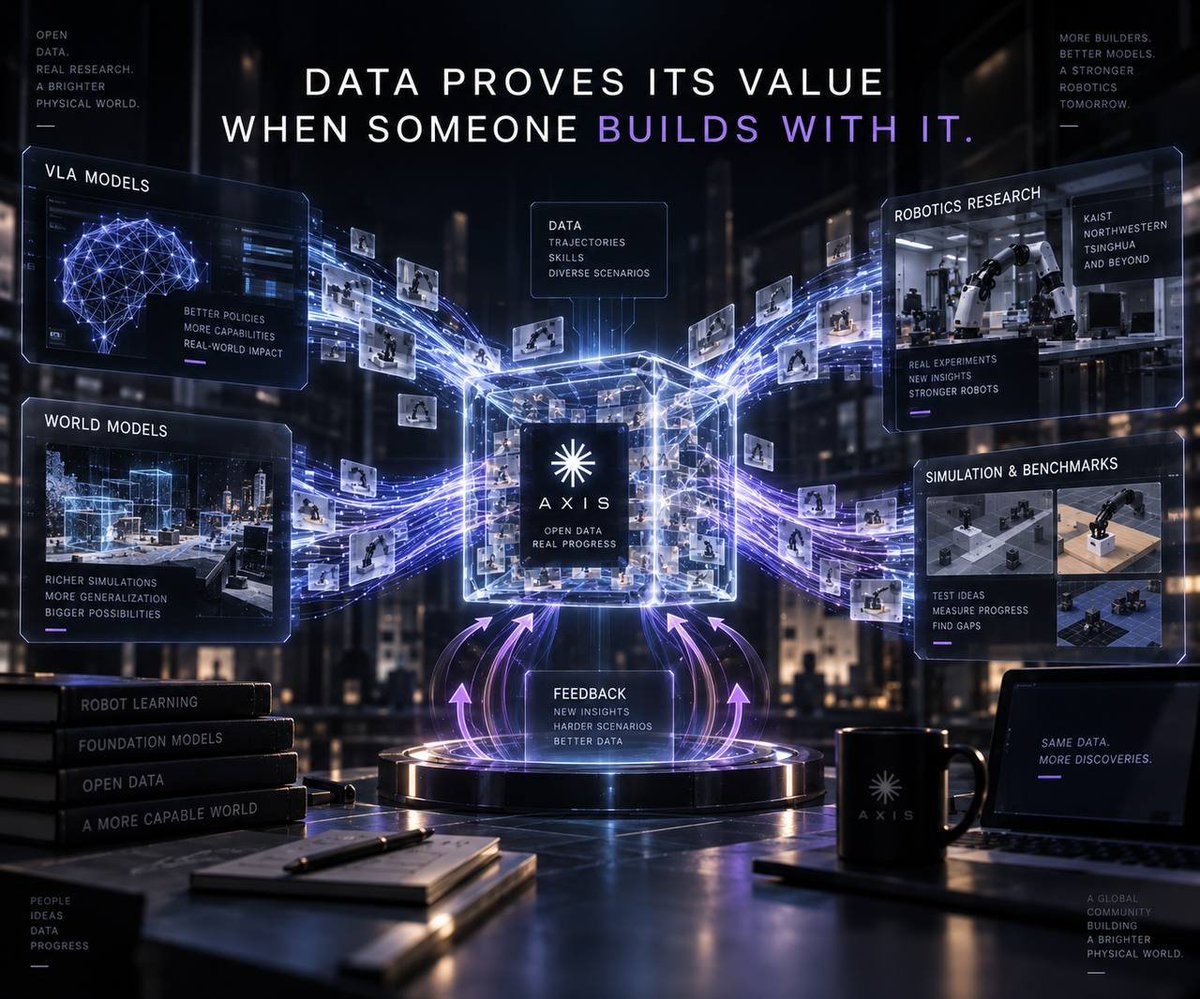
@nafas22000 推动(44 个赞,35 条回复,204 次浏览)把同样的观点又推进了一步,称下载量和外部使用情况比单纯的数据采集规模更重要。帖子称,Axis 的开放 Franka 数据集下载量已超过 160,000+,并提到 KAIST、Northwestern 和 Tsinghua 等团队的外部使用,还将这种复用视为证据,说明该网络的产出表现得更像一个产品,而不是一项虚荣指标。
 @OLTOAK 将其定义为(56 次点赞、52 条回复、365 次浏览)将 Vangrid 描述为一个更低成本的 ground-truth 网络:用智能手机采集、进行来源验证、提供资助型赏金,并在 Base 上结算,60 天内已锚定超过 100 万次采集。关键的保留意见其实就写在推文里:相比信任问题,规模扩张的争议反而更小。
@PTrubey 补充说(18 次点赞、5 条回复、1,182 次浏览、7 次收藏)从系统层面描述了当前的机器人技术栈:一个缓慢的多模态推理层、一个快速控制层、模仿学习加 RL,以及面向整支机群的再训练。但这篇帖子也点出了真正缺失的部分:机器人仍然无法把几次本地失败尝试,转化为持久的新运动技能。
讨论洞察: 最有价值的帖子,持续把“物理 AI”压缩为可验证的闭环。相比泛泛而谈机器人技术的未来,新任务、可下载数据集、数据溯源和再训练频率都重要得多。
与前一日对比: 2026-09-25 的讨论重点是 ground-truth 的短缺和去中心化采集。到 2026-09-26,话题转向了价值验证:新增了哪些任务、谁复用了这些数据、基准如何保持新鲜,以及哪些错误仍然无法在本地学会。
1.3 人们对基准测试的怀疑依然强烈,但开始把更便宜的评判层和更长任务纳入闭环 🡒
对基准测试的怀疑仍是当天最响亮的主线之一,但并没有表面看起来那么虚无。被审阅的帖子不断把“基准测试已经失灵”和具体替代方案配对提出:超大型任务提示、带验证器的开放任务集、低成本评判层,以及面向特定领域边缘案例的协议。
@bindureddy 表示(173 次点赞、29 条回复、8,858 次浏览)称 DeepSeek 是“最会刷基准测试的王者”,但在真实使用中并不真正能与前沿模型相提并论。回复很快澄清了失效模式:差距出现在持续一小时、包含多步骤的工作中,在这类任务里,从错误中恢复比短答案答对更重要。
@pvncher 认为(131 次点赞、22 条回复、9,835 次浏览)指出,小而孤立的任务并不能衡量真实 agent 运行中真正会出问题的地方。他引用的推文把缺失变量点得很明白——模糊提示、混乱的 repos、compaction 和 steers——而他的回复则建议,要么把很多任务打包进一个长提示,要么改为回放高难度 rollout。
@Paiky16 使用(11 次点赞、1 条回复、27,159 次浏览、11 次收藏)借 Xiaomi 的 7,780 个开放 RL 任务,从相反方向说明了同一点:真正有意思的不是 headline score,而是在环境和验证器公开后,模型如何在一个真实任务里找到了具体捷径。
@ValsAI 展示(31 次点赞、3 条回复、1,194 次浏览)解释了为什么尽管遭遇反弹,基准测试回顾仍然有意义:Claude Opus 5.5 以 69.7% 拿下 Vals Index 第 1 名,并在 Terminal-Bench 4.0、ProgramBench 和 SRE Bench 上取得大幅提升,但单次测试成本也升至 $22.30,且部分领域分数还出现下滑。正因为它没有把一切都压缩成一次胜利,这份回顾才有价值。
@0xClodex 强调(18 次点赞、2 条回复、394 次浏览、17 次收藏)介绍了一种基于 Jev 的“AI 防火墙”,它会在输出进入生产环境前,把校准后的失败概率映射为接受、复核或拦截决策。这张图之所以重要,是因为它把基准测试工作视为生产控制层:44 个基准、7,193 个实例、0.886 的 AUROC 中位数、0.31 秒延迟,以及据称相较 API LLM judges 有 63 倍成本优势。
讨论洞察: 即便是批评者,也不是要求团队停止衡量。他们要求的是:衡量更长的运行过程、公开验证器、列举边缘案例,并把单次测试成本与单次测试得分分开看。
与前一日对比: 相比 2026-09-25 信息流里“有些工作风险太高,不适合 vibe-code”的争论,2026-09-26 则把抱怨说得更具操作性:短任务太干净、已发布的基准太容易被针对性优化,而 harness 往往比模型本身更重要。
1.4 采用问题被归结为教育、工作流重构、ROI 跟踪和算力经济性——而不是模型 IQ 不足 🡕
另一组观点认为,AI 当前的瓶颈已经是扩散、核算和基础设施,而不是模型能力再多一点点边际提升。最有力的帖子不断回到同一个问题:即便模型已经能完成这项工作,在价值真正显现之前,用户、组织或算力栈还必须发生哪些改变?@buccocapital 认为(175 个赞,28 条回复,10,678 次浏览,70 次收藏)认为,AI 进一步普及的障碍不在模型能力,而在于人们是否理解 AI 能做什么、能否围绕它重构工作流程,以及能否克服对某些任务“必须亲自完成”的偏好。最有启发性的一条回复把这个观点转成了产品语言:如果一个工具要先让主流用户变得更“AI-forward”才有帮助,那说明产品本身还不够成熟。
@NandoDF 写道(134 个赞,8 条回复,6,686 次浏览,97 次收藏)表示,他决定永远不将自己在 Oxford 和 UBC 的课程商业化,因为他希望基础 AI 教育始终保持广泛可及。被引用的那条推文则通过把这件事与一项劳动力市场判断并列,赋予了它不同寻常的分量——据称 Anthropic 愿意为真正理解深度学习的人支付 65 万美元年薪——同时仍强调整套课程将永久免费。
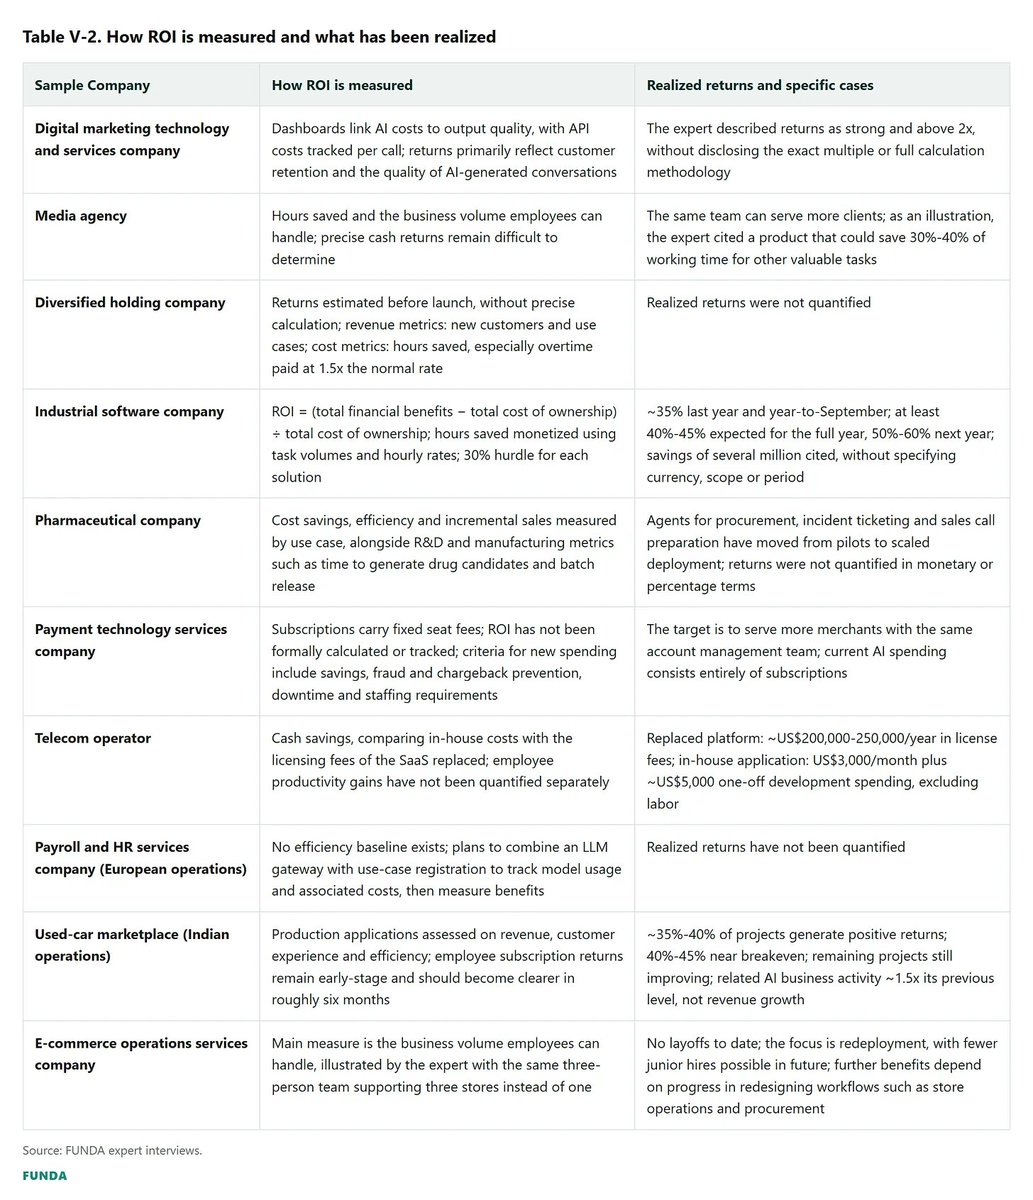
@pequityresearch 分享(25 个赞,3 条回复,3,949 次浏览,17 次收藏)分享了一张来自 FundaAI 的表格,展示 10 家公司如何衡量 AI ROI。其中最具体的一点是,一家工业软件公司正从去年的约 35% ROI 迈向明年的 50%–60%;而另外几家公司甚至仍完全无法清晰量化自己的回报。
@deedydas 拆解(69 个赞,12 条回复,4,345 次浏览,38 次收藏)讨论了“neolab”的经济账:三年内部署 1,000 块 GB300 或约 14 个 NVL72 机架,成本大约为 1.25 亿至 1.5 亿美元;此外,在推理利润率为 50% 的情况下,还需要提供大约 10 万亿 token 的服务,才能收回 1,000 万美元的训练成本。这条帖文真正的重点不是渲染声势,而是战略判断:如果你无法在价格或效用上胜过大实验室发布的模型,就需要不同的模型类别,或者专有数据集。
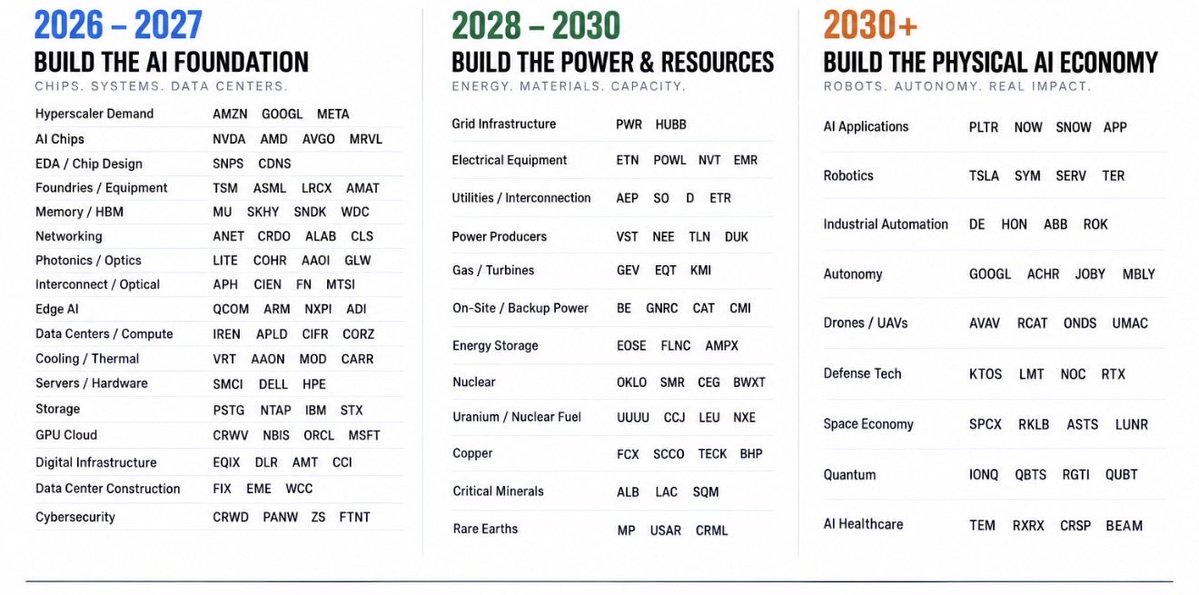
@RealJGBanks 可视化展示(22 个赞,6 条回复,5,201 次浏览,57 次收藏)则把同样的建设逻辑表述成一条分阶段路线图:先是芯片、网络、散热、GPU 云和数据中心;接着是电力、存储和材料;再到机器人、自主系统、无人机和 AI 医疗。那张图之所以重要,是因为它把“AI 基础设施”从一个模糊的宏大口号,变成了一条按行业展开的依赖链。
讨论洞察: 这一组讨论把采用视为一个有四层的系统性问题:先教会人们 AI 能做什么,再降低产品要求用户改变行为的幅度,再把 ROI 度量得足够扎实,让财务团队愿意相信,最后还要挺过前沿模型业务背后的资本密集型现实。
与前一天对比: 与 2026-09-25 相比——那天许多面向消费者的帖子主要围绕信任机制和使用习惯——2026-09-26 关于采用的讨论,更像是在谈组织变革管理和基础设施规划。
2. 什么让人沮丧
一旦工作变得更长、更乱或更依赖领域知识,基准测试依然会失灵
最常见的挫败感是,那些短小、干净的基准测试总在美化模型表现,可一到真实工作场景,模型就开始掉链子。@bindureddy 表示(173 个赞,29 条回复,8,858 次浏览)指出,DeepSeek 在基准测试上的表现可以非常亮眼,但在实际使用中并没有前沿级模型应有的感觉;而 @pvncher 表示(131 个赞,22 条回复,9,835 次浏览)则认为,那些孤立而微小的任务,根本无法覆盖含糊不清的提示、混乱的 repo、上下文压缩,以及需要持续引导的长流程。@Paiky16 使用 提到了 Xiaomi 的 7,780 个开放 RL 任务,借此说明:在单个真实任务内部出现的走捷径行为,比总分更值得关注;而 @FundamentEdge 认为(23 个赞,1 条回复,5,788 次浏览,35 次收藏)则表示,即便是 Excel 自动化,团队也得先把重述、拆分等各种边缘情况明确枚举出来,才谈得上真正有前景。
严重程度:高。当前可见的应对办法包括:超大任务提示、rollout 回放、带验证器的公开环境、像 JEV 这样边界清晰的评判层,以及面向特定领域的边缘案例协议。这个方向仍值得继续投入,因为人们抱怨的不是“基准测试毫无用处”,而是“基准测试的形态不适合我们真正关心的工作”。
采用仍然取决于教育、产品转译和 ROI 基线
第二类挫败感在于,许多工具仍要求用户和管理者在价值显现之前,先自行完成过多的解释和理解工作。@buccocapital 认为(175 个赞,28 条回复,10,678 次浏览,70 次收藏)认为,扩散受阻于认知门槛、工作流重构和人的偏好;而最有力的一条回复则指出,这本身恰恰说明产品层还不够成熟。@NandoDF 将其定义为(134 个赞,8 条回复,6,686 次浏览,97 次收藏)把免费讲座视为推动扩散的解决方案之一,而 @pequityresearch 展示(25 个赞,3 条回复,3,949 次浏览,17 次收藏)则指出,即便是已经在部署 AI 的公司,往往也仍然缺乏清晰的 ROI 核算。表格本身也呈现了这种挫败感的两面:一家工业软件公司称,其 ROI 已从约 35% 提升到 50%-60%;但也有几家公司依然没有量化回报。
严重性:高。当前的应对方式包括培训、免费教育内容、更窄的垂直领域应用,以及逐案建立 ROI 基线。这值得投入建设,因为信息流反复暗示,主流采用的瓶颈在于组织层面的转化,而不是获取原始模型能力。
物理 AI 仍缺乏可信的真实世界数据和本地学习闭环
物理 AI 相关讨论同时卡在两个不同的缺口上:如何获得可信数据,以及机器人在部署后如何从本地犯错中学习。@still_gm 表示(57 个赞,65 条回复,547 次浏览)指出,冻结不变的机器人基准会很快过时;@HVnS42442600 认为(93 个赞,114 条回复,2,536 次浏览)指出,原始轨迹总量忽略了真正关键的变量——任务覆盖度;@nafas22000 认为(44 个赞,35 条回复,204 次浏览)则认为,有用的指标是外部人员是否真的会基于这些数据开展构建。在数据采集端,@OLTOAK 表示(56 个赞,52 条回复,365 次浏览)表示 Vangrid 可以通过智能手机和悬赏机制扩大采集规模,但也承认,信任仍是最难的一环;在部署端,@PTrubey 表示(18 个赞,5 条回复,1,182 次浏览,7 次收藏)指出,如今的 VLA 栈仍无法把少数几次本地失败尝试转化为持久的新运动技能。
严重性:高。当前的变通办法包括动态基准、溯源层、下载后复用的闭环,以及机群级再训练。这值得投入建设,因为这些抱怨直指训练数据、评估与部署后行为之间的关键接口。
重计算模型业务仍受制于残酷的利用率账
关于经济性的帖子,不满的重点与其说是能力,不如说是资本结构。@deedydas 估计(69 个赞,12 条回复,4,345 次浏览,38 次收藏)指出,一家 neolab 在证明产品与市场匹配之前,可能就要在 GPU 容量上烧掉 1.25 亿到 1.5 亿美元,而现货算力利用率低于约 60% 时仍会亏损。他提出的出路很能说明问题:要么根本不要玩前沿模型这场游戏,要么构建一种截然不同的模型类别,要么去获取机器人、生物或化学等领域的专有数据集。@RealJGBanks 已映射(22 个赞,6 条回复,5,201 次浏览,57 次收藏)则把同样的挫败感进一步延伸到芯片、散热、电力和材料层面,认为在物理 AI 的红利真正到来之前,世界将被迫先把这些层补上。
严重性:中高。眼下可见的应对方式是战略性收窄:转售闲置算力、追逐单位算力收入更高的市场,或者转向基础设施层——因为那里的需求不会那么直接地被拿来和前沿模型发布对标。这依然值得投入建设,因为这种痛点是结构性的,与利用率绑定,而不只是偏好问题。
3. 人们希望出现什么
团队可以信任的、贴合工作流的评测与裁判层
最明确的现实需求,是一种像真实工作而不是玩具版那样运作的衡量方式。@pvncher 想要(131 个赞,22 条回复,9,835 次浏览)希望有运行时间更长、包含歧义、代码仓库混乱和压缩等因素的评测;@bindureddy 想要(173 个赞,29 条回复,8,858 次浏览)希望有某种机制,能区分“基准成绩持平”和真实的多步骤质量;以及 @Paiky16 想要 这类可以真正检视捷径行为的开放任务。与 JEV 相关的帖子展示了这一方向第一层可能的样子:@RoundtableSpace 展示了 提出低成本、经过校准的评判器,而 @0xClodex 展示了 则展示了如何把这些评判器变成“接受 / 复核 / 拦截”的闸门。这是一个紧迫的现实需求,而且机会看起来很直接。
能记住决策、又不授予全面自主权的 Agent 控制平面
第二个需求,是帮助 Agent 安全继承上下文的基础设施。@alexatallah 展示了(50 个赞,9 条回复,6,606 次浏览,20 次收藏)展示了一种透明路由器,会公开成本和模型选择逻辑;@beamnxw 展示了(32 个赞,10 条回复,536 次浏览,17 次收藏)展示了一条可供后续会话继承的共享决策轨迹;而 Digital Apprentice 那条帖子 展示了(20 个赞,11 条回复,373 次浏览,16 次收藏)则提出了一个框架:只有在证据充分且获得批准后,权限才会按技能逐步提升。@eng_khairallah1 补充了(20 个赞,15 条回复,3,944 次浏览,29 次收藏)指出,如果构建者不理解工具的边界,那么像 Jev 这样的快速决策模型就很容易被误用。这是一个高度紧迫的现实需求,但这一层面已经足够拥挤,因此机会看起来竞争激烈。
能教育用户、捕获 ROI,并降低行为改变成本的产品层
另一个需求是,产品需要替用户和采购方完成更多“翻译”工作。@buccocapital 认为(175 个赞,28 条回复,10,678 次浏览,70 次收藏)指出,大多数人仍然不明白 AI 能做什么,也不知道该如何把工作拆解给它;而 @NandoDF 保留了(134 个赞,8 条回复,6,686 次浏览,97 次收藏)则主张基础教育应当免费,因为知识鸿沟依然真实存在。@pequityresearch 展示了(25 个赞,3 条回复,3,949 次浏览,17 次收藏)指出,即便是已经在部署 AI 的公司,往往也仍然缺少财务部门希望看到的 ROI 基线。GeoLibre 在一定程度上解决了这个问题:它让自然语言地图操作能够在领域工具内部被审计,但信息流仍然显示,大多数品类还没有这种贴近工作流的原生封装。这是一个中高紧迫度的现实需求。机会:直接。
物理 AI 的数据与适配基础设施
机器人相关帖子不断指向同一个缺失的产品:一种系统,能够收集可信的现实世界经验,将其转化为更好的任务和数据集,并在机器人进入实际场景后出错时,更快完成闭环。@still_gm 想要(57 个赞,65 条回复,547 次浏览)强调动态基准,@HVnS42442600 想要(93 个赞,114 条回复,2,536 次浏览)强调以任务为中心的衡量,而不是比拼人群规模的虚荣指标,@OLTOAK 想要(56 个赞,52 条回复,365 次浏览)更低成本、具备来源感知的采集,以及 @PTrubey 想要(18 个赞,5 条回复,1,182 次浏览,7 次收藏)更接近真正的本地适配,而不是等下一轮整队重训。这是一个紧迫性很高的现实需求。机会很直接。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Jev | 决策模型 / 裁判 | (+/-) | 能在毫秒级约束下做出决策,给出经校准的概率,而且在所报告的对比中,判定成本便宜得多 | 当分类体系过于封闭时,会漏掉未见过的失败类型;一旦用于有界决策问题之外,也很容易被误用 |
| Jev Router | 模型路由器 | (+) | 让路由过程可检查,并在 UI 中展示考虑缓存后的成本与质量权衡 | 效果取决于缓存状态,而且公开信息里依然是基准测试证据多于长期运营证据 |
| Open Axis Benchmark | 机器人基准测试 | (+) | 来自 Axis Library 和 Axis Data Engine 的新任务集推动模型走向泛化,而不是死记硬背 | 仍处于早期,其实用性取决于后续任务生成的速度与质量 |
| Vangrid | 空间数据网络 | (+/-) | 智能手机采集、来源追踪、悬赏和 Base 结算,让现实世界数据收集看起来更便宜、更有针对性 | 信任与校准仍然最难,最强烈的质疑指向的是数据质量而非规模 |
| GeoLibre AI Assistant | 领域应用 / 助手 | (+) | 将自然语言和语音请求转化为完整 GIS 工作空间内可审计的地图操作 | 专用于 GIS 工作流,且仍需要服务商配置和领域上下文 |
| Vals Index | 基准测试套件 | (+/-) | 并列展示跨基准提升和单次测试成本,让排行榜式说法更不容易失真 | 仍然以基准测试为中心,因此更好的分数并未消除当天对真实世界质量的怀疑 |
| Claude Opus 5.5 / Sonnet 5.5 | 前沿模型 | (+/-) | 公开基准成绩提升明显,且能力足以根据一份详细 PRD 搭出一个 Unity 游戏原型 | 单次测试成本上升,某些领域表现回退,而且 Sonnet 5.5 的比较仍主要基于隐身测试的轶事 |
| 自定义边缘案例评测集 | 评测方法 | (+) | 对确定性的电子表格工作流和长任务分组,比通用的小任务评测更有效 | 定义和维护成本高,而且许多团队仍缺乏能清晰衡量结果的基线数据 |
| VLA + fleet-retrain stack | 机器人架构 | (+/-) | 慢规划器加快控制器,已经能分解任务、重试失败,并通过车队级日志持续改进 | 还无法让机器人针对罕见的本地边缘情况实现持久的机载学习 |
整体满意度的分化,更多取决于所处层级,而不是厂商。像 JEV、Jev Router、Open Axis Benchmark 和 GeoLibre 这样的专用层,收获了更积极的反应,因为它们解决的是狭窄但关键的运作缝隙。相比之下,Vals 风格的基准回顾和前沿模型对比则更受保留地看待:人们仍然会看,但已经不再相信它们单独就能代表真实使用情况。
常见的应对模式是“分解”。用更便宜的决策模型来路由或裁决有界问题,用更大的模型负责生成步骤,显式枚举领域边缘案例,并通过新任务或回放运行结果让评测面持续变化。在机器人领域,同样的模式出现在更底层:把训练数据、基准任务、来源追踪和失败日志保持联通,而不是把它们当作彼此独立的项目。
迁移趋势是从不透明的提示工程,转向可见的控制平面和可见的评测面。竞争态势并不是一个基础模型取代另一个,而是路由器、裁判、任务库、来源追踪基础设施,以及原生嵌入工作流的助手,在竞争塑造“哪个模型该在什么地方被信任”。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Open Axis Benchmark | @axisrobotics / @openroboto | 面向机器人操作模型的动态基准引擎,每轮都提供新的任务集 | 防止机器人评测老化成记忆竞赛 | Axis Library、Axis Data Engine、OpenRoboto 基准平台 | Beta | still_gm 推文 |
| Jev Router | @alexatallah / @OpenRouter | 具备缓存感知能力的路由器,可为每个请求选择模型和推理强度,并在 UI 中展示其推理依据 | 让模型选择变得可检查,而不是手工决定或黑箱处理 | Jev、OpenRouter、缓存感知路由、请求分析侧边栏 | Beta | 推文, OpenRouter 页面 |
| GeoLibre v3.1.0 | opengeos/GeoLibre | 开源 GIS,为完整地理空间工作空间加入更快的自然语言与语音驱动地图操作 | 让地理空间团队能在领域应用中使用 AI,同时操作保持可审计、可撤销 | Tauri、React、TypeScript、MapLibre GL JS、DuckDB-WASM Spatial、deck.gl | 已发布 | 推文, 仓库, 网站 |
| Vangrid | @vangrid_io | 空间数据网络,付费鼓励贡献者用智能手机采集有针对性的现实场景 | 为机器人和世界模型训练产出具备来源感知的真值数据 | 智能手机采集、隐私过滤、Base 锚定、USDC 悬赏 | Beta | 推文 |
| Digital Apprentice | Travis Weber and Rohit Taneja | 一套“赢得自主权”的框架:智能体只有在经验证明并获批后,才会按技能获得相应权限 | 用分级、可审计的自主权,取代一刀切的智能体权限 | 观察学习、推理时决策记忆、按技能划分的状态机、运行时对齐 | RFC | 推文, 论文 |
| Heatwave prototype | @froessell | 一款单拇指操作的移动端警匪追逐游戏原型,基于 AI 生成的详细 PRD 搭建 | 测试 AI 驱动的游戏工作流在进入变现前,最远能推进到多有趣、可玩的核心循环 | Unity、Topdown Engine、Opus 5.5、ChatGPT 生成美术 | Alpha | 推文 |
在物理 AI 这一簇项目中,最清晰、也最反复出现的构建模式是 Open Axis Benchmark 和 Vangrid。Open Axis 让评测面持续变化,避免机器人模型记住一套冻结任务;而 Vangrid 试图让现实世界采集变得更便宜、且更具来源感知。它们解决的问题不同,但回应的是同一个瓶颈:物理 AI 需要更新鲜的外部现实,而不只是又一个抽象的能力宣称。
Jev Router 和 Digital Apprentice 则在软件智能体上体现了同样的控制平面思路。Jev Router 让路由与成本权衡在请求时刻可见,而 Digital Apprentice 试图把“智能体何时积累了足够多、由证据支撑的能力,从而可以获得更多自主权”这件事形式化。两者背后的动机相同:当天更大的抱怨是,脱离运行框架的原始模型能力,很难让人信任。
GeoLibre 和 Heatwave 指向了另一种同样重要的模式:AI 正在被嵌入真实工作流,或被用来加速边界清晰的原型开发,而不只是外挂到通用聊天界面上。GeoLibre 让 AI 操作在地理空间工作空间中保持可审计,而 Heatwave 则把前沿模型视为产品设计与原型助手,并设置了明确的里程碑、测试标准,以及在变现工作开始前的停止点。
这些构建背后的反复触发因素很清楚:人们在交付的系统,不是简单再暴露一个文本框,而是在约束、路由、验证或操作化模型行为。第二个反复出现的触发因素是环境适配:地理空间工具、机器人基准测试、智能手机采集网络和游戏原型,都在收窄问题边界,让 AI 这一层的任务更加明确。
6. 新动态与值得关注的内容
GeoLibre 发布了当天最清晰的垂直领域 AI 版本之一
@giswqs 已发布(54 个赞,1 条回复,1,222 次浏览,24 次收藏)发布了 GeoLibre v3.1.0,将其定位为一个云原生 GIS 平台,配备四个可互换的渲染引擎、基于 OAuth 的共享功能、全新的 God's Eye View 插件,以及速度更快的 AI Assistant。这条推文本身之所以重要,在于它给出了少见的、非常具体的发布范围:来自 15 位贡献者的 220 个 pull request、8 位首次贡献者,以及能在 1 秒内执行简单地图操作的语音驱动命令;而 GeoLibre 的公开网站则补充了完整技术栈,并明确说明该助手始终运行在一个可审计的地理空间工作区内,而不是自由式聊天环境中。
AI 搜索优化正越来越接近一种标准化运营职能
@alexgroberman 认为 表示,如今销售数字产品却不做 SEO 或 AI 搜索优化,看起来就像发布一个 SaaS 却没有用户引导。(23 个赞,2 条回复,658 次浏览,6 次收藏)这条帖子值得关注的,并不是那句营销口号,而是其中的运营细节:优化产品页、对比页、常见问题页、第三方提及以及长尾商业内容,然后衡量它们在 Google、ChatGPT、Claude、Gemini、Perplexity 和 Grok 上的可见度。被引用的讨论串还补充了一个明确的催化因素——Google Search Console 的生成式 AI 展现报告——这让 AI 搜索可见性更像一个常规报表维度,而不再像某种坊间经验。
AI 基础设施与电力扩建开始成为公共叙事内容,而不只是圈内人的资本开支话题
@Polymarket 报道 表示,已有 900 多人前往华盛顿特区参加一场“支持数据中心的派对”,随后又在回复中称,市场给出的概率是:到年底前,任一州出台数据中心暂停令的可能性为 29%。(407 个赞,66 条回复,50,720 次浏览)单看这件事会像个新奇现象,但它与 @deedydas 拆解 关于 neolabs 资本密集度的讨论,以及 @RealJGBanks 映射 关于 AI 扩建正从芯片和散热延伸到电力、电网和材料的判断相互呼应。综合起来的信号是:AI 基础设施如今已经足够显性,开始以公共政治议题和投资组合内容的形式出现,而不再只是实验室内部的规划事项。
7. 机会在哪里
[+++] 长周期评测与裁判基础设施 —— 这是当天最强的横截面信号。Bindu Reddy 对基准测试的怀疑、pvncher 对短小孤立任务的批评、Xiaomi 开放的 RL 任务发布、面向 Excel 的边缘案例评测,以及 JEV 更便宜且经过校准的裁判方案,都指向同一个缺口:团队需要更接近真实测试框架、持续时间更长,并且能够暴露不确定性而不是掩盖不确定性的评估体系。
[+++] 具备路由、记忆和分级自治能力的 Agent 控制平面 —— Jev Router、共享决策轨迹、Digital Apprentice 框架,以及 JEV 防火墙模式,都表明市场需要这样一种基础设施:决定调用哪个模型、继承哪些上下文,以及何时允许 agent 做更多事。这一机会之所以强,是因为它不依赖某一个垂直领域;同样的需求同时出现在编程 agent、安全层和评测闭环中。
[+++] 物理 AI 的数据与基准基础设施 —— Open Axis Benchmark、HVnS 的任务覆盖论点、nafas22000 关于复用与下载的证明、Vangrid 的采集网络,以及 PTrubey 对本地学习的抱怨,都汇聚到同一个瓶颈上。这个机会之所以强,是因为它覆盖的是数据采集、来源追踪、基准新鲜度和部署后的适配,而不是某个狭窄的缺失功能。
[++] 面向主流团队的采用与 ROI 监测能力 —— Buccocapital 的扩散理论、Nando de Freitas 的免费课程信号、FundaAI 的 ROI 表格,以及 GeoLibre 的工作流原生助手,都指向一个巨大但不那么光鲜的缺口:能教会用户、让操作可审计,并给财务团队提供可量化信任依据的产品。之所以判断为中等机会,是因为这类需求广泛且真实,但具体实现会因垂直领域而有很大差异。
[++] 算力利用率与替代性模型商业经济学 —— Deedy Das 的 neolab 算法和 RealJGBanks 的行业路线图,都暗示了一个市场:提供能提升利用率、缩小营收与算力之间差距,或帮助公司进入那些 frontier labs 在结构上没那么占优的品类的产品。这个机会属于中等,因为痛点很明显,但买方和商业模式很可能都高度专业化。
[+] AI 搜索可见性运营 —— Alex Groberman 的操作手册以及 Search Console 的 AI 展现视角表明,围绕帮助品牌理解自己出现在哪些 AI 答案里、以及如何提升这种可见度,正在形成一个真实的新兴细分市场。它看起来仍然偏早期,也带有较重的营销色彩,但此时它已经不只是一个空洞热词。
8. 要点
- 最具体的 AI 构建者动能,投入的是模型周边的控制界面,而不只是模型选择本身。 Jev Router、共享决策记忆、Digital Apprentice 和 JEV 防火墙,都把路由、上下文继承和自治门控变成了一等产品界面。(来源)
- 围绕 Physical AI 的讨论一再强调:任务覆盖范围和数据复用,比轨迹层面的亮眼数字更重要。 最有分量的帖子关注的是新增的基准任务、外部数据集下载,以及数据闭环是否真的改变了模型。 (来源)
- 人们对基准测试的反弹正变得更具建设性,而不再只是单纯的冷嘲热讽。 大家依然不信任短小而孤立的评测,但他们所转向的替代方案已经很具体:超大任务提示、带验证器的公开环境、经过校准的评审层,以及边缘案例协议。 (来源)
- AI 的采用看起来仍然更像是翻译和衡量问题,而不是能力缺失问题。 信息流反复回到教育、工作流重构和 ROI 基线,认为这些才是更广泛普及的现实障碍。 (来源)
- 重算力型 AI 业务如果找不到一个更聚焦的赛道,仍将面临严峻的利用率压力。 当天最清晰的一篇经济分析帖子认为,如果没有更高的单位算力收入或专有优势,前沿式的算力投入很难回本。 (来源)
- 这条信息流中最有力的产品形态,是嵌入真实工作流的垂直领域 AI。 GeoLibre 的 GIS 助手和其他边界清晰的产品之所以显得更可信,是因为 AI 层运行在一个具备明确操作、数据集和结果的工具之中。 (来源)