Twitter AI - 2026-09-27
1. 大家在讨论什么
1.1 更小的决策模型与自优化技能,正进一步贴近 agent 运行时 🡕
最清晰的软件 agent 主题,是架构上的“做减法”。人们不再要求一个大模型包打天下,而是不断分享边界明确的 sidecar:可训练的技能文档、经过校准的裁判器、快速动作选择器,以及允许模型弃权的 harness。至少有六条经审阅的帖子支持这一趋势,而且其中大多数相比模型本身有多“炫”,更在意成本、延迟和可检查性。
@RoundtableSpace 报道称(35 次点赞,11 条回复,49,687 次浏览,39 次收藏)称,Microsoft 的开源 SkillOpt 会评估 agent 表现、重写自身指令、拒绝未通过基准测试的改动,还能将优化后的技能迁移到不同模型上。公开的 SkillOpt README 则把这一思路又往前推了一步:把技能文档视为冻结 agent 的可训练状态,只有当编辑提升留出验证集表现时才接受改动,并最终直接交付生成的 markdown 工件,而不增加额外的推理时调用。
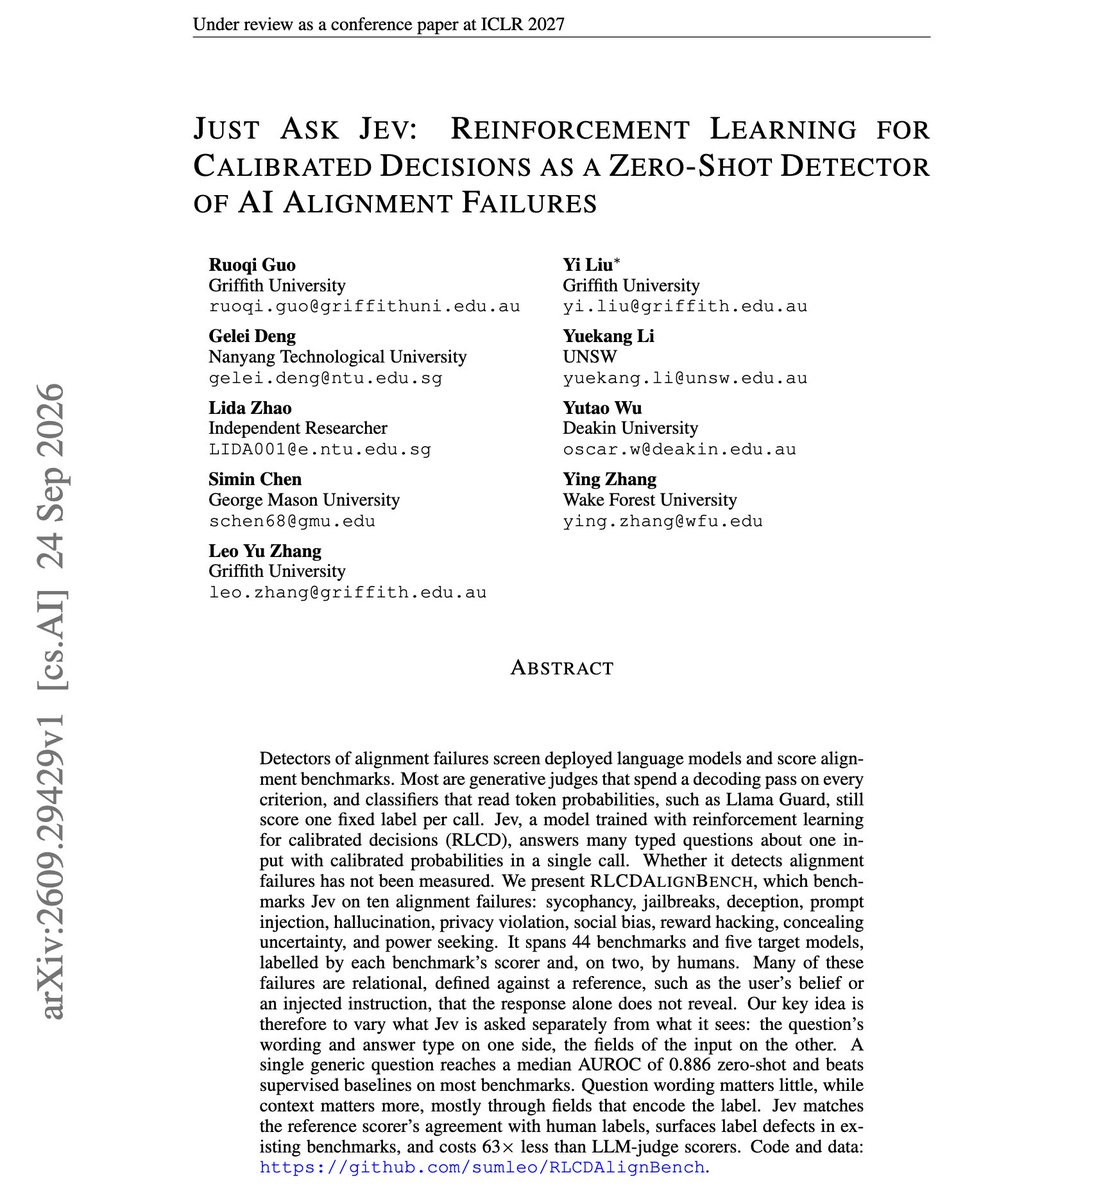
@omarsar0 报道称(54 次点赞,18 条回复,4,551 次浏览,47 次收藏)提到一篇 Jev 论文:它用一个通用的是/否问题,加上经过校准的概率,来给对齐失败打分。真正让它传播开来的,是其中非常具体的结论:AUROC 中位数为 0.886,RLCDAlignBench 由 44 个基准组成,覆盖十类失败类型,而且据称 Jev 单次评测成本为 $0.30,而这些基准所用的 LLM 裁判成本则为 $18.96。
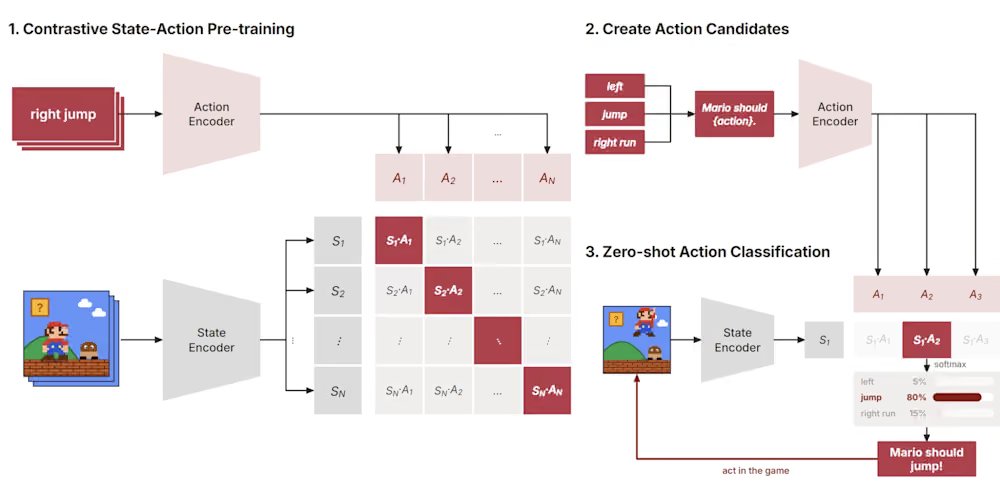
@bendee983 认为(10 次点赞,4 条回复,690 次浏览,5 次收藏)称,Stanford 和 Nvidia 的 CLM-8B 是首个真正有分量、公开开放权重、可与 Jev 风格决策模型竞争的公开对手。他的总结称,CLM 会对状态和动作进行编码与匹配,能够判断推理模型的输出,并且在所报告的实验中速度最高可达 Jev 的 9 倍;不过他也指出了一个限制:参考设置仅支持文本,且上下文窗口更短。
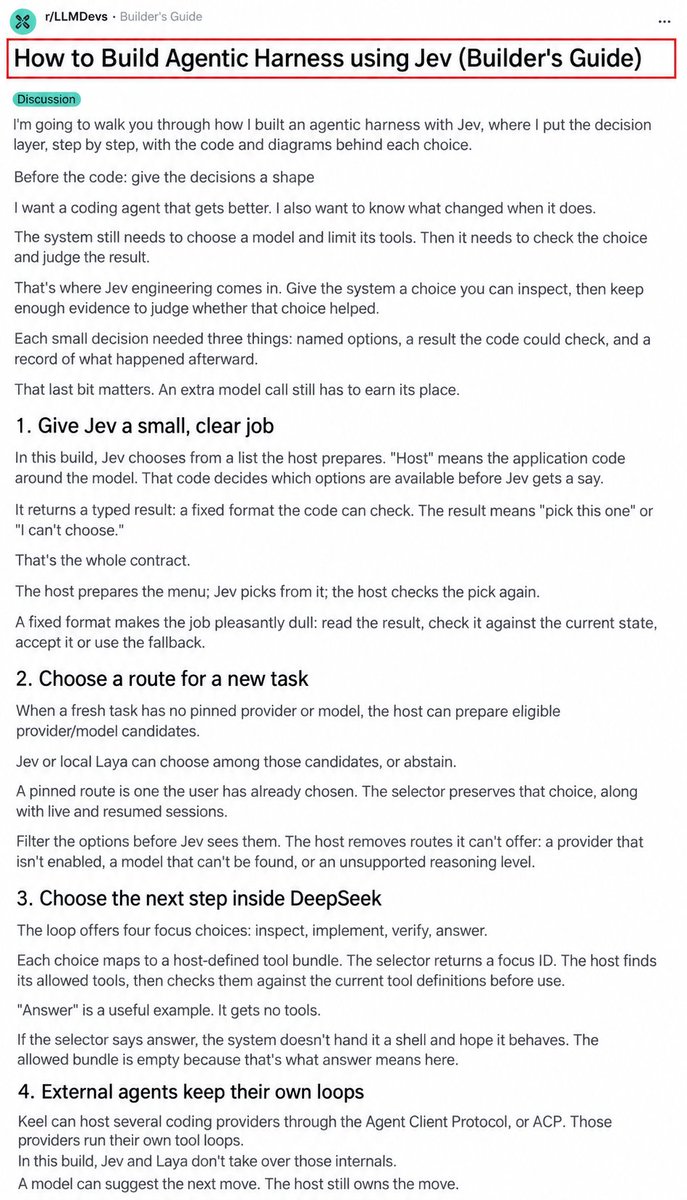
@omarsar0 强调(28 次点赞,12 条回复,6,101 次浏览,42 次收藏)介绍了一个把 Jev 当作模糊 linter 的 harness,这套方案刻意收窄问题范围:只保留那些易于判断的微小规则,用合成评测加留出集进行测试,并让中等置信度的输出触发二次检查,而不是自动接受。另一个来自 @0xGrimmer_ 将其界定为(9 次点赞,52 次浏览,8 次收藏)的回顾,则把同样的设计直觉说得更直白:一个健康的 agent 循环有时需要的是一个能直接说出“我无法选择”的模型,而具体动作仍应由宿主代码掌控。
讨论洞察: 回复讨论的重点,与其说是在争论这些层是否成立,不如说是在质疑它们的评测是否足够严格。在 SkillOpt 线程中,最尖锐的回复指出,如果自我重写能够钻基准测试的空子,那么基准本身才是真正的产品。在 Jev 论文线程中,最有力的批评则是:生产环境中的标签分布漂移,可能比一个漂亮的 AUROC 分数所暗示的来得更快。
与前一天的对比: 2026-09-26 的控制平面讨论,主要围绕路由、记忆和分级自治;到了 2026-09-27,话题又往下深入了一层,转向可训练的技能文档、开放权重决策模型,以及明确的弃权规则。
1.2 关于效率的讨论,从口号走向机制:重复工具调用、重复推理与缓存素养 🡕
第二个主题是,如今团队开始公开调试 agent 的低效问题。最有分量的帖子并不是抽象地抱怨成本,而是点出具体的浪费模式,解释它为何会在训练中漏过去,并说明构建者必须理解哪些系统概念,才能避免 agent 循环白白消耗时间和上下文。
@XiaomiMiMoDevs 报道称(187 次点赞,14 条回复,8 次转引,4,278 次浏览,28 次收藏)称,MiMo-V2.6 一直在重复发起完全相同或近乎相同的工具调用,因为它的奖励机制只跟踪最终答案是否正确,却遗漏了中间过程中的低效行为。最令人印象深刻的细节,就是这个阈值 bug 本身:只有当单轮工具调用超过 32 次时,泛滥惩罚才会触发。Xiaomi 表示,他们用一个轻量级、专门处理重复问题的 RL teacher 修复了这一问题;该 teacher 基于约 7,000 个样本训练了 12 步,随后再通过 MOPD 将结果合并回主模型,成本大约仅为完整重训的 4%。
@cline 表示(8 次点赞,2 条回复,629 次浏览)称,Fireworks 的 Ember-1 处理的是相邻的一类失效模式:重复推理。对于一篇公开讨论效率的帖子来说,这一说法具体得不同寻常:Ember-1 在各项基准上的总 token 用量减少了约 40%;而在一项面向编程流量的在线 A/B 测试中,在成功率相同的情况下,它的推理 token 比 Kimi K3 少 71%,总 token 少 39%。
@TheAhmadOsman 发布了(357 次点赞,17 条回复,22,373 次浏览,523 次收藏)提到一份免费指南,其核心卖点就是帮助构建者理解那些决定开放权重和本地 AI 运行能否持续实用的底层机制:KV cache、prefill 与 decode、量化、VRAM 计算、失效模式、服务模式,以及实际的部署路径。这与 @attharrva15 分享(111 个赞、5 条回复、3,519 次浏览、129 次收藏)相呼应:一篇关于 vLLM 的文章引来一则回复,称真正值得研究的系统层洞见是 PagedAttention。
讨论洞察: 最值得玩味的回复偏重于科普而非宣传。有一条回复是对 Ahmad Osman 提问:读者看完这份指南后,是否就能预测延迟和故障模式?而最有分量的那条 vLLM 相关回复则绕开笼统炒作,直接切入 KV-cache 管理。这表明,开发者越来越在意运行层面的机制,而不只是模型名称。
与前一天的对比: 相比 2026-09-26 对基准测试的怀疑,2026-09-27 出现了更多根因分析,也更具体地解释了 agent 循环一旦开始真正干活,算力究竟浪费在什么地方。
1.3 开源 AI 工作台受到关注,靠的是打包完整工作流,而不只是一个模型端点 🡕
最受好评的一组工具帖子,来自那些围绕模型提供完整工作界面的产品:文件、工具、代码执行、服务商选择,以及对执行过程的可视化追踪。信息流认为,这比又一次基础模型发布更有意义,因为它更贴近人们真实的工作方式。
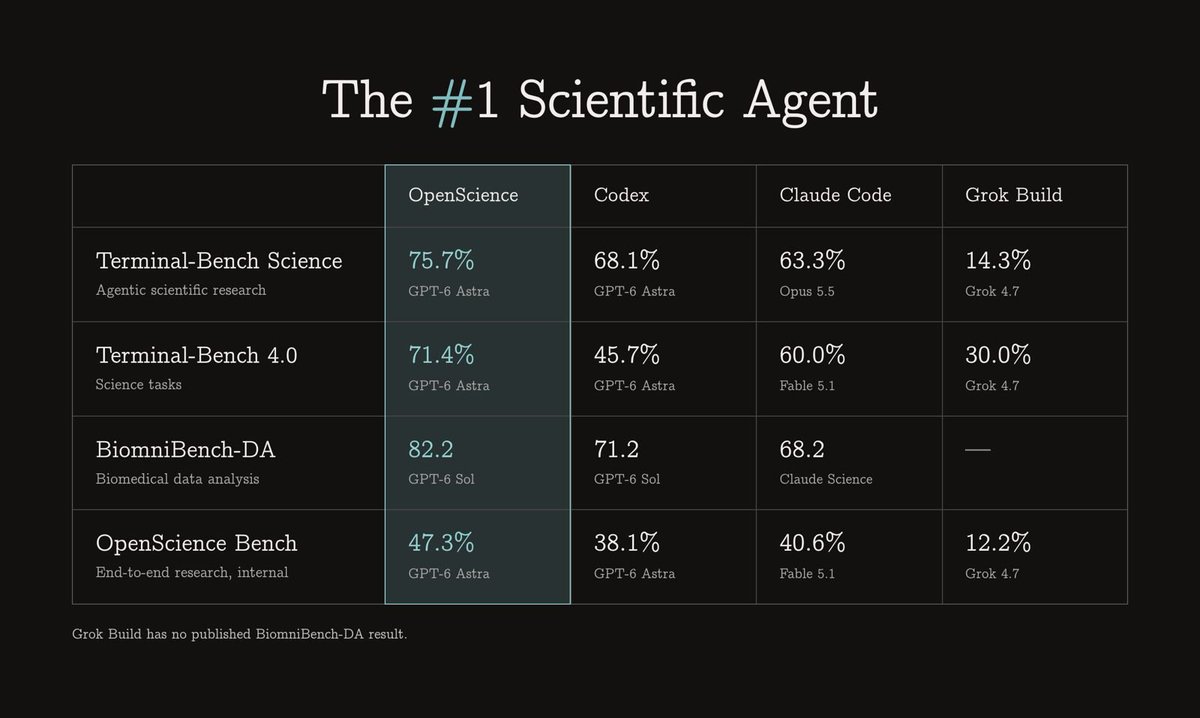
@AIStackLabX 报道称(137 个赞、2 条回复、19,690 次浏览、23 次收藏)称 OpenScience 在四项科学基准中领先,并直接附上了 repo 链接。被引用的发布帖表示,该产品已结束 beta,集成了 300+ 项研究技能和 50+ 个科学工具及数据库,并已在 30+ 所大学和研究实验室中投入使用。公开的 OpenScience README 则补充了运行层面的定位:这是一个科学工作台,提供 shell 访问、Python 和 R、可视化追踪,以及基准成绩,包括在 Terminal-Bench Science 上取得 53/70、在 Terminal-Bench 4.0 的科学子集上取得 10/14。
@rohanpaul_ai 补充道(14 个赞、7 条回复、2,638 次浏览、6 次收藏)则给出了更明确的基准对比,称 OpenScience 在 70 个 Terminal-Bench-Science 工作流中完成了 53 个,成绩为 75.7%,并且在这组对比中超过了文中引用的 Codex 和 Claude Code 科学分数。
@DanKornas 认为(8 个赞、2 条回复、627 次浏览、4 次收藏)称,RubyLLM 解决的是另一个不同但相关的工作流问题:Ruby 开发者不该为了每个模型服务商来回折腾不同的 SDK。这条推文将其描述为一个覆盖 18 个服务商的统一 Ruby API,而当前的 RubyLLM README 则写为 19 个服务商,并确认支持多模态文件处理、工具、agents、embeddings、reranking,以及 Rails 集成。
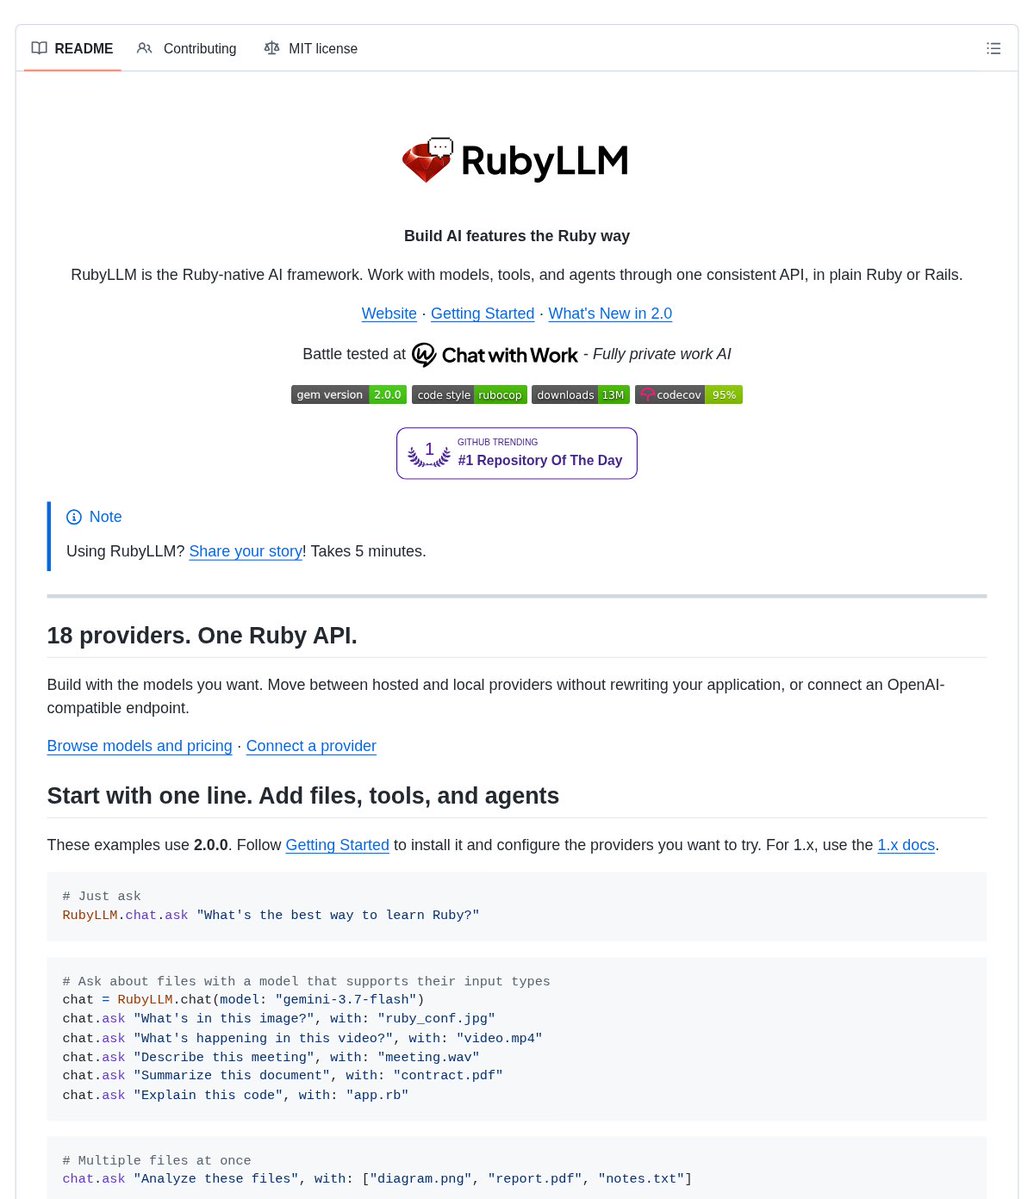
讨论洞察: 这里受到称赞的,是那些朴素但关键的系统界面,而不是模型“个性”:可视化追踪、文件、安全执行、服务商切换,以及应用框架集成。与泛泛的兴奋相比,这通常是更强的开发者信号,因为它指向的是团队已经反复需要完成的工作。
与前一天的对比: 相比 2026-09-26 当时更偏向 ROI 和工作流重构的 adoption 讨论,今天的工具帖更像 repo,也更便于安装。真正有意思的说法不是“AI 很重要”,而是“这才是它真正可以被操作起来的界面”。
1.4 Physical AI 仍然围绕数据溯源和动态基准展开,而不是模型本身 🡒
关于 Physical-AI 的讨论,仍然聚焦于本周早些时候同样的瓶颈:可信的真实世界数据,以及不会固化成记忆化游戏的评测界面。2026-09-27 的显著变化在于,人们更频繁地尝试用具体计数器、流程图,以及反对静态基准的表述,让这一瓶颈变得清晰可见。
@0xebii 表示(23 个赞、20 条回复)称,Vangrid 的 Explorer 已显示 2.3M+ 次 grid events、1.13M+ 次 captures、4,097 条 attestations、437K+ 个活跃节点,以及 $436K+ 已结算 USDC。附带截图之所以重要,是因为它把一种模糊的“空间数据网络”叙事,转化成了一个活动仪表盘。
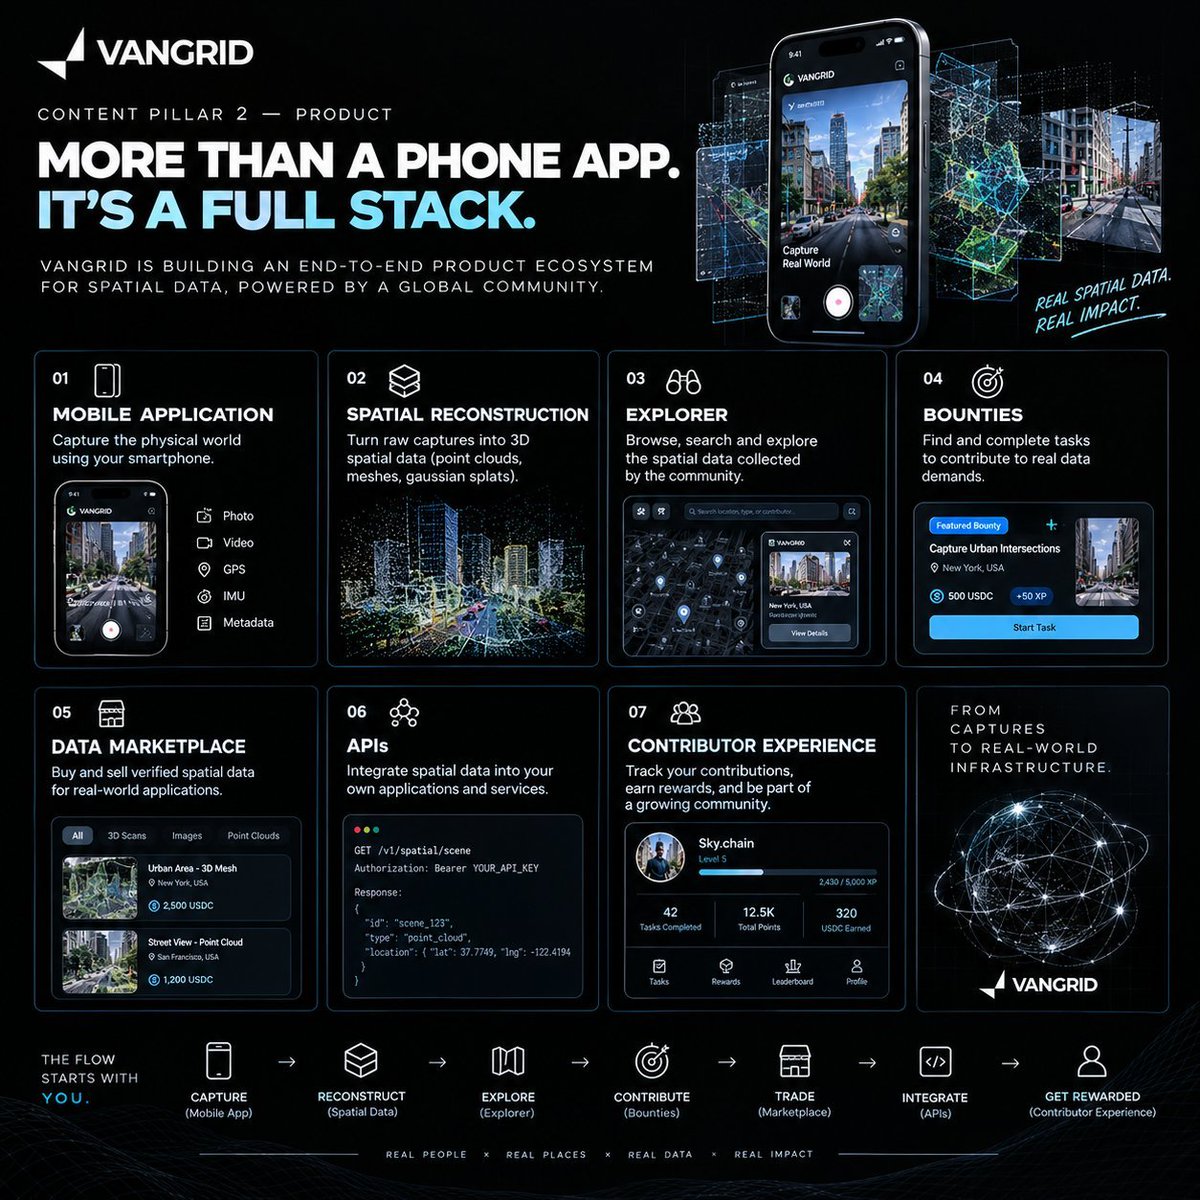
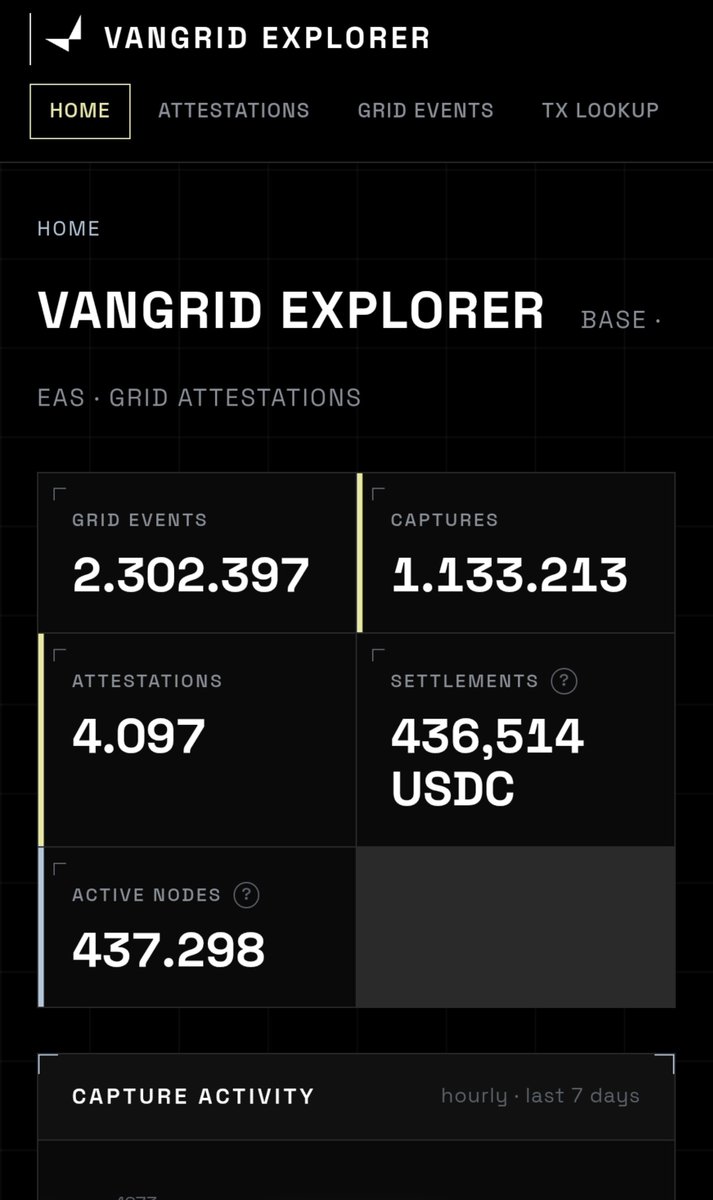 @VPhm23380671 提出了最有力的怀疑论观点(17 个赞,13 条回复)解释了为什么这些数字本身并不足够。他在帖子中认为,Vangrid 真正的挑战,是如何在不在隐私、质量或买方需求上失手的前提下,把数百万次智能手机采集转化为一致、具备商业价值的空间数据集。@SheviaXO 将其界定为(83 个赞,109 条回复,1,766 次浏览)则将同一个项目概括为一个端到端的基础设施闭环:采集、重建、探索、贡献、交易和集成。
@Md_Lokman_71 认为(33 个赞,33 条回复)认为,Axis 的真正贡献在于动态评测:从 Axis Library 提取未见任务,把成功轨迹验证为模块化技能,并将贡献重新接回模型改进。@SamiulA84391909 表示 则更直接地表达了同样的意思(23 个赞,19 条回复):静态机器人基准会很快过时,因此如果 Open Axis 的结果是为了衡量泛化而非记忆,那么每一轮都必须锁定一组全新的任务。

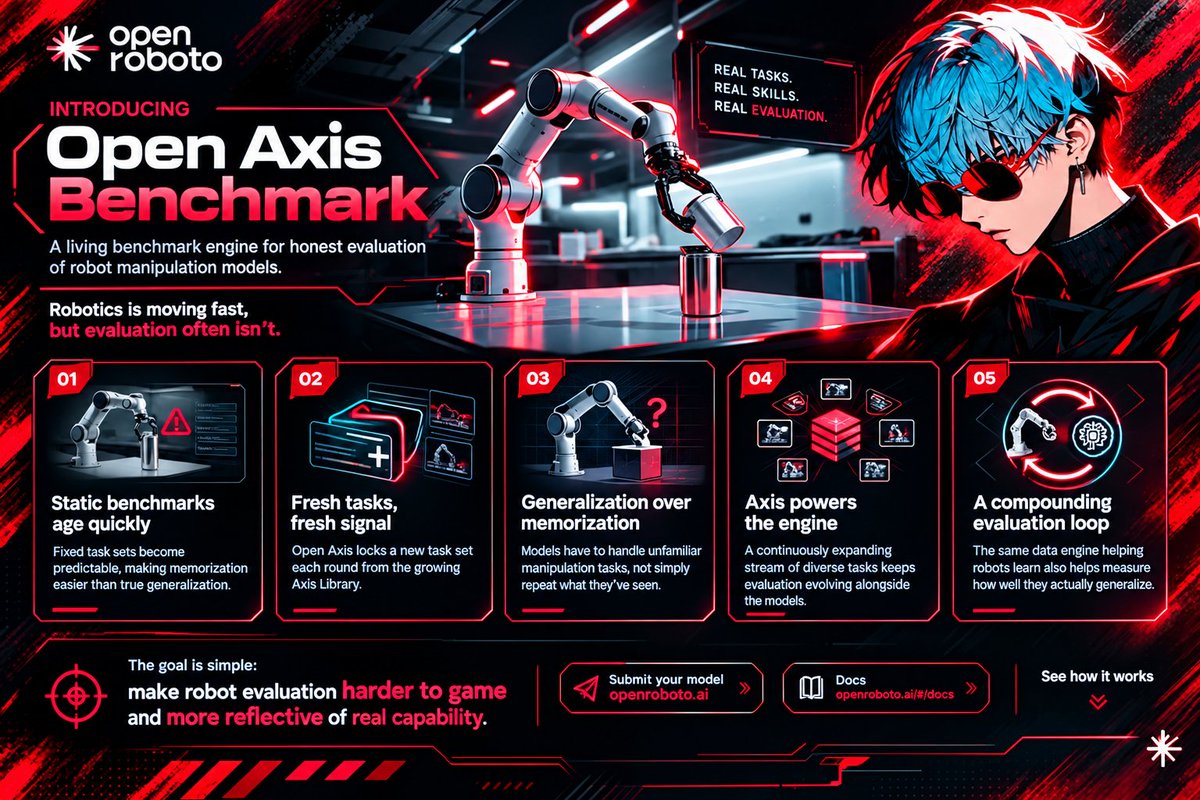
讨论洞察: 这一组回复中有不少只是泛泛支持,但有价值的批评始终反复回到两个问题:数据是否可信,基准是否能持续保持足够“新鲜”而不失去意义。这也是为什么围绕 Open Axis 的“反静态”表述,以及围绕 Vangrid 的“来源可追溯”表述,会一再出现。
与前一天对比: 与 2026-09-26 相比,同样的具身 AI 瓶颈依然存在,但今天的帖子加入了更明确的活跃度计数,以及更清晰的示意图,说明采集、验证和评测应如何衔接。
2. 什么让人感到挫败
Agent 循环仍在优化最终正确性,却浪费了大量过程开销
当天最明显的挫败感在于,一个 agent 即便在过程中浪费了大量算力,最终仍然可能被视为“成功”。@XiaomiMiMoDevs 表示(187 个赞,14 条回复,4,278 次浏览,28 次收藏)指出,MiMo 一直在重复调用工具,因为奖励函数只关心最终正确性,而不在乎中间过程中的低效行为。@cline 表示(8 个赞,2 条回复,629 次浏览)则指出,推理模型也可能在每一步都反复思考同样的内容,这也是为什么 Ember-1 所强调的真正改进是 token 削减,而不是原始分数提升。
严重程度:高。当前可见的应对办法包括针对重复行为的专项后训练、保留集上的 harness 评测,以及更小的 system-one 层,让模型可以说“我无法选择”,而不是凭空编造信心。这值得投入建设,因为这种浪费模式是明确的、可衡量的,而且代价高昂。
快速决策层仍需要更好的监控和更严格的评测
这些 agent 控制相关帖子总体上是乐观的,但最有力的回复始终指向同一个风险:一个快速裁决器或自我改进的技能,纸面上看起来很好,实际中却可能发生漂移,或通过操弄评测看起来更强。在 Jev 的讨论串里,有回复 警告称 指出,如果没有人监控裁决器本身,每周的标签漂移就可能悄悄侵蚀原本不错的 AUROC。在 SkillOpt 的讨论串里,最尖锐的回复 认为 指出,如果基准很容易被“刷”,那么技能可能在指标上变得“更好”,却在构建者真正想要的能力上变得更差。@bendee983 还指出 则指出,对 CLM-8B 当前的比较,应带着“仅文本”和“更短上下文”这两个限定条件来解读。
严重程度:高。今天的应对机制包括保留集验证闸门、合成评测、人工审核,以及更窄的任务范围界定。这依然值得投入建设,因为几乎所有现代 agent 栈似乎都想要一个更便宜的裁决器、路由器或选择器,但目前明显具备生产安全性的评测闭环仍然很少。
开源与本地 AI 仍在迫使用户以最艰难的方式学习系统概念
另一种挫败感则更偏向教育层面。@TheAhmadOsman 发布了(357 个赞,17 条回复,22,373 次浏览,523 次收藏)是一份指南,涵盖 KV 缓存、预填充与解码的区别、量化、VRAM 计算、运行时选择以及故障模式;而回复也清楚说明了它为何传播如此之广:人们至今仍会一再重新搜索这些基础却影响重大的系统概念。@DanKornas 将其界定为(8 个赞,2 条回复,627 次浏览)把 RubyLLM 视为应对提供商 SDK 泛滥的答案,而最有分量的那条 vLLM 回复 聚焦于 讨论的重点则是 PagedAttention,而不是演示是否打磨精致。
严重性:中高。目前的权宜办法,是把大型实用指南、代码仓库 README 的深度解读以及框架抽象混合起来使用。这值得去做,因为需求信号规模大、反复出现,而且直接关系到开放权重模型和本地工具链能否走出少数专家的小圈子,变得真正可用。
Physical AI 仍无法把规模宣称与信任宣称区分开来
Physical-AI 这一簇讨论始终围绕两个尚未解决的问题打转:数据是否可信,以及基准是否能保持新鲜。@VPhm23380671 明确说明了(17 个赞,13 条回复)讨论了 Vangrid 在执行、数据质量、隐私和需求方面的风险,而 @SamiulA84391909 认为(23 个赞,19 条回复)则指出,静态机器人基准终究会变得过于可预测。即便是支持 Vangrid 和支持 Axis 的帖子,也仍然需要反复解释为何数据溯源和新任务如此重要。
严重性:高。可见的应对办法包括探索仪表盘、证明层、锁定的全新任务轮次,以及明确的反记忆化设计。这值得去做,因为这个品类的发帖者已经直接点明了瓶颈:如果数据不可信、评测也不再困难,那么仅仅增加更多数据是不够的。
3. 人们希望有什么
从延迟、VRAM 和故障模式讲起的实用本地 AI 入门
当天传播最广的教育类帖子并不是在寻求灵感;它是在试图把一整套可用的系统知识压缩成一份可读指南。@TheAhmadOsman 提出了(357 个赞,17 条回复,22,373 次浏览,523 次收藏)做的正是这件事,而回复很快就聚焦到:它教会人的,究竟是如何预测延迟与故障模式,还是只是在传授术语。vLLM 的讨论 呼应了 也从基础设施侧体现了同样的需求:它把 PagedAttention 提升为构建者真正需要理解的那类机制。这是一个紧迫性很高的现实需求。RubyLLM 从应用框架这一侧部分回应了这一点,但信息流仍表明,许多构建者依然是在零敲碎打地学习那些难点。机会:直接。
能够弃权、可跨模型迁移且保持可审计的决策层
Jev、SkillOpt 和 CLM-8B 这几条帖子都指向了同一种缺失的产品形态:一个快速、边界明确的模型层,能够做出类型化决策、承认不确定性、经受留出评估,并且能在不同基础模型之间迁移,而不会沦为黑箱。@omarsar0 展示了 展示了一种利用置信度分层和留出评估的 harness 设计,@RoundtableSpace 展示了 展示了一个会重写并验证自身 skill 文档的系统,而 @0xGrimmer_ 认为 则指出,当允许模型说“我无法选择”时,agent 的表现会更好。这是一个紧迫性很高的现实需求。早期系统已经存在,但这个领域看起来也已经竞争激烈。机会:竞争型。
将轨迹、工具和模型选择整合在一起、原生融入工作流的 AI 界面
OpenScience 和 RubyLLM 这两条帖子从不同方向传达了同一种偏好:人们希望 AI 被嵌入在同一个界面里,文件访问、工具使用、提供商选择和输出结果都可检查,而不是分散在彼此割裂的服务之间。@AIStackLabX 关联了 将 OpenScience 呈现为一个具备 skills、tools 和基准化性能的科学工作台,而 @DanKornas 推介了 则把 RubyLLM 描述为 Ruby 和 Rails 开发者厌倦提供商频繁变动后一直缺失的抽象层。这是一个紧迫性中高的现实需求。OpenScience 和 RubyLLM 目前都在一定程度上回应了这一点,但需求看起来仍然比这两个界面中的任何一个都更广。机会:直接。
能证明溯源、且随着时间推移仍不易被“刷分”的 Physical-AI 闭环
机器人和空间数据相关帖子不断暗示同一个缺失的系统:收集可信的真实世界数据、公开其溯源,并让评测界面持续变化,从而使模型无法靠记忆应对。@0xebii 想要 证明这个网络仍然是活的,@VPhm23380671 想要 对隐私、质量和需求风险的严肃对待,以及 @Md_Lokman_71 想要 能真正检验泛化能力的动态任务。这是一个非常紧迫的现实需求。Vangrid 和 Open Axis 目前已部分回应了这一点。机会:明确存在。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Jev | 决策模型 / 评判器 | (+/-) | 在所报告的对比中,具备校准后的概率、类型化输出,而且评判成本低得多 | 阈值无法在不同基准之间顺畅迁移,而且有回复担心一旦标签分布变化就会发生漂移 |
| SkillOpt | 技能优化器 | (+) | 由验证门控的自我改写,把提示词/技能调优变成可重复的优化闭环 | 如果基准可以被“刷分”,优化闭环就可能奖励错误的东西 |
| CLM-8B | 开放权重决策模型 | (+/-) | 开放权重、可复用的状态/动作嵌入,以及据称相较 Jev 有速度提升 | 公开证据仍带有仅限文本、上下文更短的限定条件 |
| MiMo 面向重复问题的专用 RL teacher + MOPD | 后训练方法 | (+) | 无需完整重训,就能以低成本定向修复重复工具调用问题 | 解决的是一种病灶,而不是更广泛的奖励错设问题 |
| OpenScience | 科学智能体工作台 | (+) | 在一个界面里同时提供有基准支撑的科研表现、真实工具、文件、代码执行和可见轨迹 | 面向科学场景,而且这一类别还足够新,因此基准质量尤其重要 |
| RubyLLM | 框架 / 应用集成 | (+) | 用一个 Ruby API 覆盖众多提供商,并支持多模态文件、工具、智能体和 Rails 集成 | 明显是为 Ruby 生态深度优化,而非面向通用跨语言采用 |
| vLLM | 推理 / 服务引擎 | (+) | 仍因 PagedAttention 和 KV-cache 管理等系统层思路而广受赞赏 | 在这组数据里,讨论更多是赞赏而非诊断,因此新的局限信息较少 |
| Vangrid | 空间数据网络 | (+/-) | 智能手机采集、溯源表述、市场化定位,以及具体的 explorer 计数器 | 信任、隐私、质量控制和买方需求都仍未解决 |
| Open Axis Benchmark | 机器人基准 | (+) | 每轮引入新任务,加上递进式评测闭环,对抗“靠记忆取胜” | 仍处于早期,其价值取决于持续的任务生成和外部使用 |
当一个工具能把某个狭窄的操作环节处理得很好时,整体满意度最高。Jev、SkillOpt、RubyLLM 和 OpenScience 之所以受到称赞,是因为它们的接口非常明确:判断这个、优化这份技能文档、屏蔽提供商碎片化,或把科学研究流程端到端跑通。项目越依赖未来网络效应或广泛生态行为的叙事,反馈就越容易变得复杂而分化。
最常见的变通模式是拆解。对边界清晰的问题使用更便宜的决策层,对开放式生成使用更大的模型,用可移植层应对提供商更替,再用一个比玩具提示词更接近真实工作流的基准来评测。在物理 AI 里,同样的模式表现为对数据采集、溯源、动态任务和下游评估的拆分。
迁移趋势正在远离“一个模型包打天下”的整体式思路。如今的竞争格局更像是围绕模型旁边的位置展开的专用层竞争:技能优化器、评判器、路由抽象、提供商桥接,以及持续演化的基准闭环。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| SkillOpt | Microsoft Research | 面向冻结智能体的自演化技能优化器,可编辑并验证技能文档 | 用验证门控的优化闭环取代手工提示词/技能调优 | Python CLI、技能 Markdown 产物、留出验证门、多后端 chat/exec harness | Beta | 推文, 仓库 |
| OpenScience | @SynScience / Synthetic Sciences | 开源科研工作台,可阅读文献、编写并运行代码,并记录轨迹 | 为科学智能体提供一个可见的科研工作界面,而不是裸模型端点 | 桌面端/浏览器/CLI、shell、Python/R、科研连接器、带基准的工作台、300+ 内置技能 | Shipped | 推文, 仓库 |
| RubyLLM | @DanKornas / crmne | 原生 Ruby 的 AI 框架,统一工具、智能体、文件和模型提供商 | 消除 Ruby 与 Rails AI 应用中提供商 SDK 的碎片化 | Ruby、Rails、多模态文件、工具、智能体、embeddings、rerankers、提供商抽象 | Shipped | 推文, 仓库 |
| Open Axis Benchmark | @axisrobotics / @openroboto | 面向机器人操作模型的动态基准引擎,每一轮都有新任务 | 防止机器人评测老化成“记忆力竞赛” | Axis Library、浏览器数据采集、技能提取、动态任务锁定、仿真平台 | Beta | 推文 |
| Vangrid | @vangrid_io | 面向物理 AI 工作负载的空间数据采集、认证与市场层 | 用智能手机而非专用车队,生成具备溯源感知的现实世界 ground truth | 移动端采集、3D 重建、explorer 指标、Base + EAS attestations、USDC 结算、API | Beta | 推文 |
SkillOpt 和与 Jev 相关的帖子指向了一种反复出现的构建模式:用更小的控制层来约束或优化智能体行为,而不是取代底层模型。OpenScience 和 RubyLLM 在工作流侧体现了同样的倾向。产品不再只是“一个 AI 模型”;它是一个让工具、文件、轨迹和提供商选择都变得可管理的界面。
Open Axis Benchmark 和 Vangrid 则展示了物理 AI 里的平行模式。一个项目让评估目标持续变化,另一个则试图让物理世界更便宜地被采集,也更容易被信任。它们解决的问题不同,但都在回应同一个瓶颈:具身系统需要比静态基准或合成演示更鲜活的外部现实。
6. 新动态与值得关注的内容
MiMo 发布了当天最清晰的公开失败分析
@XiaomiMiMoDevs 分享了(187 次点赞、14 条回复、4,278 次浏览、28 次收藏)是一篇罕见地具体的复盘:重复工具调用源于奖励机制的盲点,抑制泛滥的惩罚启动得太晚,而一个小型、专门处理重复问题的 RL teacher 加上 MOPD,就以远低于完整重训的成本修复了这一问题。这之所以值得注意,是因为它暴露了精确的训练病灶,而不是躲在一句含糊的“我们改进了模型”后面。
原生 Ruby 的 AI 框架竞争开始变得可见
@DanKornas 强调了(8 次点赞、2 条回复、627 次浏览、4 次收藏)将 RubyLLM 描述为一个以 Ruby 和 Rails 为先、覆盖众多模型提供商的抽象层。公开的 README 现在写明支持 19 家提供商,并内置工具、智能体、多模态文件、结构化输出以及 Rails 集成。这之所以值得注意,不是因为它是当天最大的框架,而是因为它表明 AI 应用基础设施正开始按语言生态细分,而不再继续集中于 Python 和 JavaScript。
果蝇脑图谱作为 AI 效率的思想实验,再次进入信息流@trajektoriePL 认为(84 个赞、4 条回复、3,946 次浏览、26 次收藏)指出,一份新近完成映射的果蝇连接组图谱包含 166,700 个神经元和 1.25 亿个突触,这之所以与 AI 相关,是因为生物系统一直在以极低功耗解决导航与适应问题。这条推文真正重要的地方,不在于关于 Minecraft 和 Bitcoin 的梗,而在于它提醒我们:对 AI 构建者而言,高能效认知依然是一个尚未解决的系统问题。
7. 机会在哪里
[+++] 面向过程的智能体优化与决策层 —— MiMo 的工具循环修复、Jev 的校准式评判、SkillOpt 的验证门控自我改写、CLM-8B 的开放权重定位,以及 Ember-1 关于 token 效率的主张,都指向同一个缺口:团队需要的是能优化智能体执行路径的系统,而不只是优化它最终给出的答案。
[+++] 具备可见轨迹和真实工具的开源工作流界面 —— OpenScience 和 RubyLLM 都因将文件、工具、模型选择和执行轨迹整合进一个可用界面而获得关注。这个方向之所以显得强劲,是因为需求对应的是重复性工作,而不是某一轮基准测试周期。
[+++] 物理 AI 的溯源与动态评测基础设施 —— Vangrid 强调溯源的数据供给叙事,与 Open Axis Benchmark 的新任务循环,最终汇聚到同一个瓶颈:具身系统需要可信的外部现实,以及不会过时的基准。这个机会很强,因为痛点明确且反复出现。
[++] 本地与开放权重 AI 的上手引导和诊断 —— 当天最强的教育类帖子讲的是 KV cache、prefill 与 decode 的区别、VRAM 计算和失效模式,而对 vLLM 的称赞则集中在缓存管理内部机制上。这说明,市场确实需要能够教学、诊断并推动开放权重 AI 落地的产品,而不只是罗列模型选项。
[+] 面向特定编程语言的 AI 应用层 —— RubyLLM 是一个小但有用的信号,说明提供商可移植性和智能体抽象会持续在主流 AI 技术栈之外的生态中被重新构建。这一方向仍在早期,但它预示着 AI 基础设施将更广泛地扩展到按语言和框架划分的开发者社区。
8. 要点
- 更小、边界明确的模型,正成为大型智能体的默认补充。 SkillOpt、Jev 和 CLM-8B 都将真正有意思的工作定义为围绕更大模型进行技能编辑、评判、路由或动作选择,而不是直接取而代之。(来源)
- 公共讨论越来越善于点出智能体循环中的具体失效模式。 MiMo 的重复 bug 和 Ember-1 对重复推理的削减,都把“效率”转化成了实际可以调试的机制。(来源)
- 开源 AI 工具在打包完整工作流时最容易赢得关注。 OpenScience 和 RubyLLM 之所以重要,是因为它们把提供商选择与工具、文件和贴近真实工作的执行界面结合在了一起。(来源)
- 物理 AI 的瓶颈,更多仍在于可信现实,而不是模型雄心不足。 Vangrid 和 Open Axis 反复回到溯源、任务新鲜度和反记忆化设计,而不是又一次新的基础模型发布。(来源) 5.本地化与开放权重 AI 素养,如今本身已经成为一种独立的产品层。 当天最强烈的纯学习信号,是一篇篇幅很长且极其实用的指南,系统讲解了模型机制、运行时选择和硬件算力的计算,人们大量将其加入书签。(来源)
- AI 构建者仍在从生物学中寻找提升效率的线索。 这篇关于果蝇连接组的帖子之所以重要,是因为它把低功耗动物认知变成了一个系统基准,而这一点仍是当前 AI 难以企及的。(来源)