Twitter AI - 2026-10-10
1. 大家在讨论什么
1.1 比起展示 agent,如何把 agent 运行起来变得更具体了(🡕)
信息流中最清晰的一组话题,不是在赞叹 agent,而是在讨论如何运营 agent。至少有四条高信号内容都认为,真正的难点在于:该让 agent 做什么、该保留哪些状态,以及如何判断它们是否真的完成了工作。
@AlexFinn 发布了(71 次点赞,23 条回复,6,847 次浏览,81 次收藏)在《智能体用例》中先指出,他听到最常见的抱怨是:人们搭好了 Grok Bot、Muse、Hark、Dots 或 Hermes,然后就不知道该拿它们做什么。配图把这一点说得更具体:已索引 1,041 个用例,当周新增 104 个,其中包括把网页调研整理进电子表格、端到端完成问卷、构建 Google Maps 列表,以及用 Codex 修复 bug 等具体条目。

@0xwhrrari 认为(79 次点赞,28 条回复,7,702 次浏览,66 次收藏)称,agent memory 会失效,是因为系统在保存事实时,没有重新检查这些事实是否依然成立。回复区进一步把这一点提炼成了明确的运行规则:加载时必须校验有效性,过时记录需要有过期或失效机制,而只追加不修改的历史记录会让旧事实压过更新后的真实情况。
@sermakarevich 将其定义为(50 次点赞,15 条回复,2,125 次浏览,62 次收藏)也以同样的方式讨论了 agentic evals。在回复线程里,他举了一个例子:只按回复内容打分的评估,在 60 次运行中有 58 次通过;而能感知状态的评估只通过了 48 次,因为其中 10 次运行在数据库状态根本没有变化的情况下,却信心十足地声称退款已经存在。
讨论洞察: 回复区表明,人们想要的不只是更好的模型。Alex Finn 那条线程里有一条回复追问,为什么每个人都得各自在孤岛里重复造同一个 agent;而在 memory 和 eval 相关线程中,讨论也不断回到同样的现实诉求:新鲜度检查、明确的步骤预算,以及可共享、可靠的工作流。
与前一天相比: 2026-10-09 的 agent 讨论,重点还在 harness 设计和验证闭环。到了 2026-10-10,这种对可靠性的关注进一步落到了日常运营层面:究竟要实际运行什么、保存什么,以及评估什么。
1.2 开放式类型化决策模型继续扩大存在感(🡕)
昨天关于决策层的讨论并未消退,反而继续扩展到由创作者自行构建的开放系统:它们试图用有边界的选项、概率输出和明确的升级路径,取代自由文本生成。
@Nandakishorm1 开源了(182 次点赞,12 条回复,3,123 次浏览,60 次收藏)发布了 Vega,这是一种基于物理的类型化决策模型。他表示,该模型有 800M 和 4B 两个版本,具备 73K-token 上下文、图像支持,以及更强的单次 Jev 风格基准成绩。其最突出的主张在于架构本身:先在隐藏状态空间中表征 observation、question 和 outcomes,再让决策在各个 outcome 的“谷地”之间收敛,而不是生成散文式文本。
@Sumanth_077 分享了(9 次点赞,5 条回复,854 次浏览)发布了 AnyJev,这是一个开放框架:它读取有界选项上的 next-token logits,校正选项顺序偏差,并能在低置信度情况下升级回完整推理。对于一条体量不大的推文来说,它公开的指标异常具体:顺序翻转率从 0.230 降到 0.073,准确率从 0.747 提升到 0.803,而在 5% 风险下可自动决策案例的占比从 7.7% 提高到 46.3%。
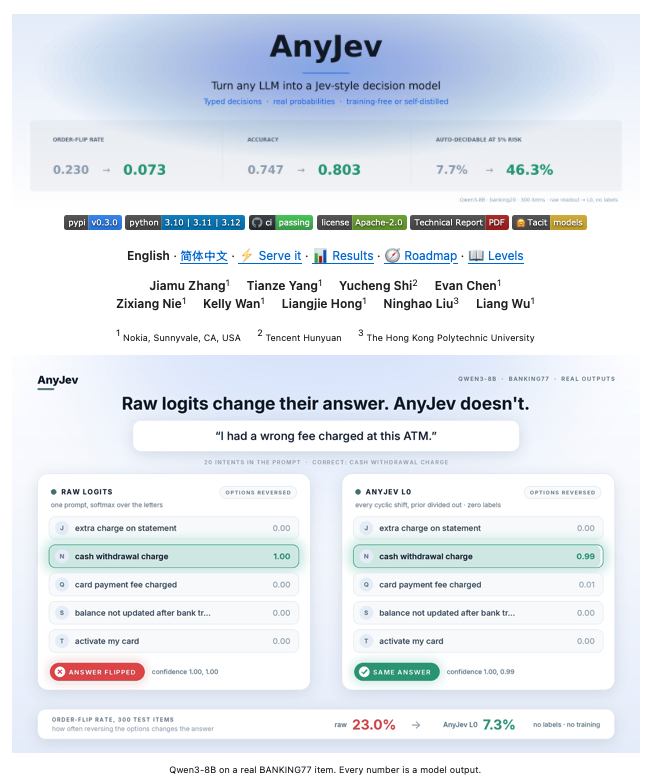
讨论洞察: 最有价值的质疑恰恰来自 AnyJev 自己的线程。作者承认,无需训练的类型化决策依然继承了基础 transformer 的前向计算成本,因此收益在于结构和校准,而不是白得来的算力。至于 Vega,第一条回复就追问改进究竟来自架构,还是只是包装方式不同;作者回应称,架构和训练都是新的。
与前一天相比: 2026-10-09 的决策模型讨论,主要由 Microsoft-Decision-1 和 Drex distribution 代表。到了 2026-10-10,这个类别看起来更开放,也更具实验性,独立构建者开始发布新的变体和去偏方法。
1.3 AI 同时成了使用场景入口和买家的发现层(🡕)
第三组话题把 AI 视为一个既能推荐任务、也能帮助挑选供应商的入口。这里的信号主要来自产品截图和有调查支撑的采购数据,而不是抽象的模型争论。
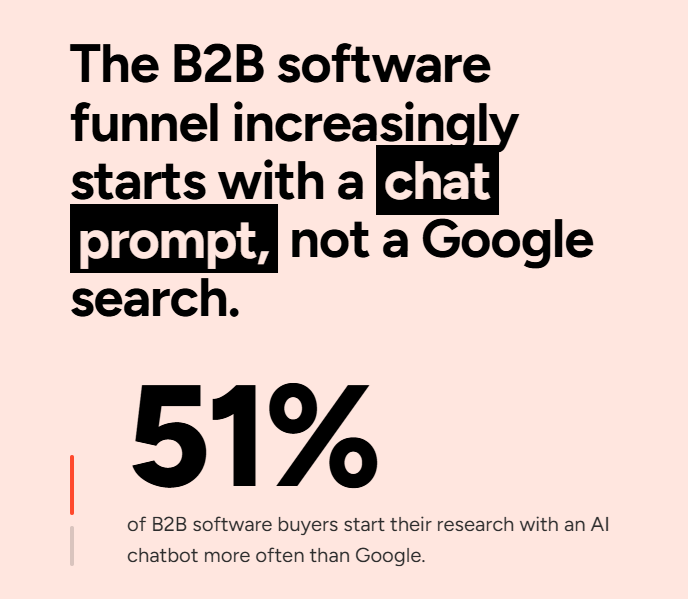
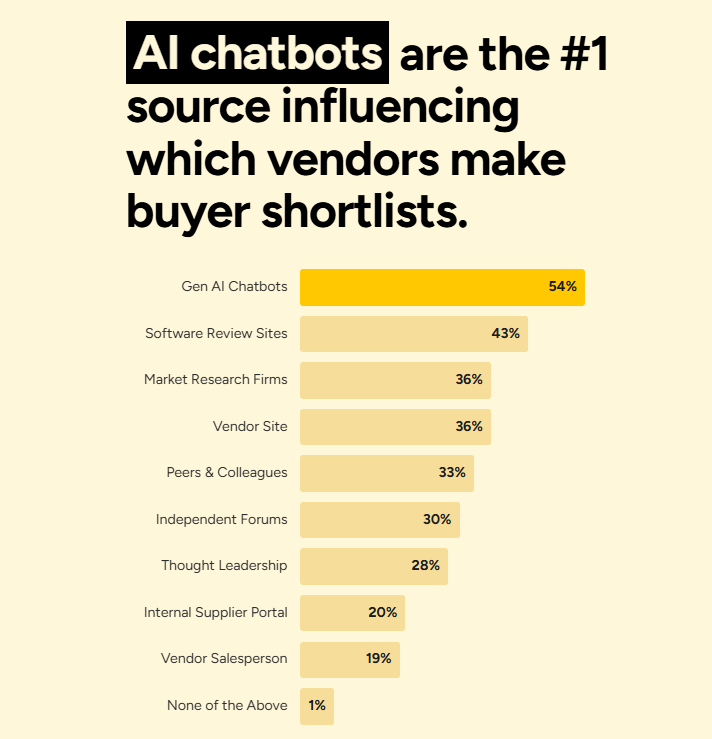
@alexgroberman 认为(29 次点赞,1 条回复,1,546 次浏览)称,AI 聊天机器人正在改写 B2B 软件候选清单,并引用了 G2 在 2026 年 3 月对 1,076 名买家的调查。公开的 PR 公告 支持了他帖文中的核心数据:51% 的人现在比起 Google 更常用 AI 开始调研,69% 的人在 AI 指引后选择了与原计划不同的供应商,还有三分之一的人购买了此前从未听说过的供应商产品。
 @alliekmiller 声称(19 个赞、14 条回复、2,016 次浏览、8 次收藏)表示,Meta Muse 的 ideas 标签页远胜于其他实验室反复展示的那些泛泛的度假、膳食规划和健身提示。她的截图也用更具体的建议印证了这一点:根据收件箱上下文修正合同时间安排、将 Stripe 付款同步到日历、并排比较品牌报价,以及延续另一个 AI 已经掌握的用户信息。
讨论洞察: 这些帖子真正讨论的并不是模型孰优孰劣,而是 AI 能否给出有用的下一步行动,以及如今被 AI 引用,是否会改变哪些人从一开始就会被纳入考虑范围。
与前一天相比: 相比 2026-10-09 对 harnesses 和 runtimes 的关注,2026-10-10 又增加了一个面向买方的维度:AI 被讨论时,不再只是一个用来构建系统的系统,也越来越被视为一个决定人们购买什么、尝试什么的系统。
1.4 Physical AI 依然热度很高,但最强的观点集中在泛化与可组合技能上(🡒)
在回顾样本中,Physical AI 依然非常显眼,但最值得保留的内容主要是关于如何评估或组织机器人系统的论点,而不是新发布的基准测试结果表。讨论的重点更多是哪些东西不该相信,而不是某一个单独的突破。
@ChuzzyTech 认为(85 个赞、84 条回复、541 次浏览)表示,固定不变的机器人基准会夸大进展,因为任务会被记住——无论是有意还是无意。他更倾向的替代方案是使用一个持续变化的任务库,每一轮都抽取新任务,让模型必须泛化,而不是重做昨天的考卷。
@Jaxon0x 认为(59 个赞、40 条回复、1,169 次浏览)表示,单体式 embodied 模型是一种架构陷阱,Physical AI 更应该把低成本的专用专家、由效用驱动的数据选择,以及能够训练出更强后继模型的部署 rollout 串联起来。
讨论洞察: 回复大多是在表示认同,而不是展开技术讨论,因此大部分有用细节都留在原帖中,而不在讨论区。最强的共识是:衡量机器人进展,应该看其在未见任务上的表现,以及技能组合能否复用,而不是看某一个固定分数。
与前一天相比: 在 2026-10-09,Physical AI 的论据更多依赖公开的 AXIS 数据引擎和评估数字。到了 2026-10-10,这个话题依然活跃,但贡献的更多是关于基准的理念和规模化论证,而不是新的公开结果。
2. 什么让人沮丧
如何把 agent 能力变成可重复的日常工作
严重程度:高。最突出的现实抱怨并不是模型太弱,而是人们在完成 setup 之后,不知道该拿 agents 做什么。@AlexFinn 表示(71 个赞、23 条回复、6,847 次浏览、81 次收藏)称这是他听到的“头号抱怨”,随后通过发布一个可直接照抄的用例目录来回应。@alliekmiller 推出了(19 个赞、14 条回复、2,016 次浏览、8 次收藏)也从产品侧看到了同样的挫败感:人们已经厌倦了千篇一律的度假、膳食规划和健身演示,而当 UI 提示的是合同清理、付款同步或报价比较这类具体工作时,反应会更好。人们目前的应对方式,是整理 playbook 并展示更具体的想法。值得构建:高,因为多篇帖子都把这个缺口视为尚未解决、且足以围绕其打造产品的问题。
过时记忆和只看回复的评分方式,仍会让 agents 失败得看起来很顺
严重程度:高。@0xwhrrari 描述了(79 个赞、28 条回复、7,702 次浏览、66 次收藏)提到了一个常见失败模式:agent 同时记得当前截止日期和已被替代的旧截止日期,却无法判断哪个仍然有效。@sermakarevich 补充道(50 个赞、15 条回复、2,125 次浏览、62 次收藏)指出,只看回复内容的评估方式会把这类失败判成成功;在他的例子里,十次运行都声称已经退款,但状态里根本没有发生退款。应对模式说得很明确:在加载时重新验证记忆、让过时记录失效、同时评估工具使用和最终状态,并强制执行步骤预算。值得构建:高。
AI 基础设施看起来依然像一门专家学科,而不是后台管道
严重程度:中高。@suraj_sharma14 列出了(119 个赞,10 条回复,4,381 次浏览,209 次收藏)列出了 AI 基础设施工作的十二个层次,从 CUDA 内核和 KV-cache 路由,到 GPU 调度、语义路由,以及公开拆解。回复进一步点明了抱怨的核心:token 价格只是总成本的一部分,而搜索、抓取和 enrichment 等外部调用,往往才是每项已完成任务的主要成本。人们正通过 quantization、batching、routing,以及 bitnet.cpp 这类本地推理方案来应对,但这条帖子真正想强调的,正是技能门槛本身。值得构建:高。
机器人开发者仍不相信固定基准能够证明真正的泛化能力
严重性:中。@ChuzzyTech 认为(85 个赞,84 条回复,541 次浏览)认为,在已见任务上拿到 95% 的分数,与其说证明了能力,不如说更像是在证明记忆;而 @Jaxon0x 认为(59 个赞,40 条回复,1,169 次浏览)则认为,单体化的具身策略会带来计算膨胀和遗忘。常见的变通办法是拆解:使用可迁移的任务库、狭窄专家和链式技能,而不是一个庞大的单一策略。值得构建:中,因为需求很明确,但目前保留下来的证据更多是观点交锋,而不是以基准测试为主。
3. 人们希望出现什么
真实 agent 工作流的共享库
今天的证据表明,许多用户并不需要另一个关于 agent 的抽象承诺;他们需要的是一个可靠的、已经验证可用的示例库。@AlexFinn 构建了(71 个赞,23 条回复,6,847 次浏览,81 次收藏)构建了一个可搜索的工作流目录,原因正是如此;还有一条回复明确发问,为什么每个人都得在彼此隔离的环境里重复构建同样的 agent,而不是在协作环境中一起完成。这是现实需求,不是愿景,因为需求表达围绕的是日常使用,而不是前沿能力。机会:直接。
速度快、校准良好、并能在不确定时升级处理的决策层
@Nandakishorm1 介绍了(182 个赞,12 条回复,3,123 次浏览,60 次收藏)将 Vega 描述为一种支持长上下文和图像的 typed decision model,而 @Sumanth_077 分享了(9 个赞,5 条回复,854 次浏览)则提到 AnyJev 的答案有界概率,以及回退到 reasoning 的升级路径。他们的表述清楚传达了这种需求:人们想要的是介于规则引擎与完整生成式模型之间的东西,尤其适用于 yes/no、路由、评分和安全决策。这一需求已有部分方案在解决,但竞争正在迅速加剧。机会:竞争型。
知道何时该遗忘、重载和验证的记忆系统
@0xwhrrari 描述了(79 个赞,28 条回复,7,702 次浏览,66 次收藏)直接点出了缺失的能力:更多历史并不会告诉 agent,过去的哪些事实现在仍然有效。回复也把期望中的行为说得很明确:expires_at 式失效机制、源变更检测,以及在加载时进行有效性检查,而不是被动保留。这是一个紧迫的现实需求,因为它正处在记忆与正确性之间的关键路径上,而信息流中并没有出现一个被普遍接受的默认解法。机会:直接。
更清楚地了解 AI 如何推荐产品,以及 AI 系统在生产环境中的实际行为
保留下来的证据显示,围绕可见性存在两类相邻需求。@alexgroberman 将供应商选择与 AI 推荐入口关联起来,而 @MiaAI_lab 则为混合 GPU 集群提供了更多遥测能力,包括 Windows 主机、RDMA 计数器和 Prometheus 导出。一类需求是商业可见性:品牌会在哪里出现在 AI 回答中;另一类需求是运维可见性:已部署的 AI 系统实际上在做什么。两者都很务实,但也都已有多个参与者。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Agent Use Cases | 工作流目录 | (+) | 将模糊的 agent 兴趣转化为可搜索、可复用的任务与 prompts | 今天的公开证据主要来自创始人的 tweet 和截图,而不是可供核查的公开数据集 |
| Vega | Typed decision model | (+/-) | 有界决策、长上下文、图像支持,为结构化结果提供新架构 | 公开基准细节由作者概述,采集到的记录中并没有独立展开 |
| AnyJev / Tacit | 决策框架 / 模型 | (+) | 无需训练的有界决策、选项顺序去偏、自适应升级到 reasoning | 仍继承了基础 transformer 的前向传递成本,并且在模糊场景下需要置信度校准才能站得住脚 |
| bitnet.cpp | 本地推理运行时 | (+) | 为 BitNet 模型提供更快、更节能的 CPU 推理;无需 GPU 也能运行大型本地模型 | 仅限 BitNet 模型家族,而非通用本地推理 |
| sparkDash | 可观测性仪表板 | (+) | 混合集群监控、Windows GPU 支持、RDMA 遥测、Prometheus 导出、按 GPU 查看 | 聚焦于 NVIDIA GPU 运维,而不是通用的应用层工作流调试 |
| Meta Muse ideas tab | 助手 UX / 创意发现 | (+) | 提供具体、上下文丰富的任务建议,而不是泛泛的演示 prompts | 今天的证据来自单个用户的评价和截图,而不是更广泛的使用数据 |
| State-aware end-state grading | 评估方法 | (+) | 能抓住仅看回复评分会漏掉的流畅性失败;检查工具、状态和步骤预算 | 需要可复现环境,且比只判断最终答案需要更多准备 |
| vLLM / SGLang / TensorRT-LLM | 服务栈 | (+) | 吞吐调优、batching、quantization 和硬件特定优化已被视为核心基础设施技能 | 运维复杂度高到连技能鸿沟本身都反复成为抱怨点 |
最强烈的正向情绪集中在那些能够收窄范围并暴露结构的工具和方法上。@Sumanth_077(9 个赞,5 条回复,854 次浏览)强调的是概率和有界输出,而不是 prose;@sermakarevich(50 个赞,15 条回复,2,125 次浏览,62 次收藏)强调的是最终状态和工具路径,而不只是答案文本。
常见的变通模式是分层升级:先用小型 typed decision layer,只有在置信度较低时才调用更大的 reasoning model;在可能的情况下使用本地或 quantized inference;重载记忆时显式检查时效性;系统进入生产后再补上更丰富的遥测。最清晰的迁移趋势,是从单体化的“直接问模型”流程,转向有界决策、可观测基础设施,以及由 AI 介导的发现入口。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Agent Use Cases | @AlexFinn | 可搜索的真实 agent 工作流与 prompts 目录 | 人们搭好了 agent,却不知道哪些具体任务值得自动化 | 每日网页扫描与分类工作流索引, | 如作者所述 | Beta |
| Vega | @Nandakishorm1 | 面向结构化结果的基于物理的类型化决策模型 | 对于是/否和选择题这类有界决策,自由生成未免小题大做 | 基于 LLM/VLM 隐状态表征的 engine+adapter 测试时训练架构;支持图像;73K 上下文 | Alpha | 推文 |
| AnyJev / Tacit | Nokia Applied Research | 用于类型化选择、是/否和评分决策并输出概率的框架与模型家族 | 团队需要的是结构化决策、偏差校正和选择性升级,而不是整段文本输出 | 开放式因果 LLM、去偏 logit 读出、Tacit 自蒸馏模型、transformers / vLLM | 已发布 | GitHub, 推文 |
| Fold2Reason | GENTEL Lab | 可迁移到更广泛推理任务的蛋白质结构后训练流水线 | 对空间与结构推理而言,人类文本可能不是理想的教师 | Qwen3.5 流水线、FoldingCorpus、LoRA、共享空间工作区、冻结的几何解码器 | Alpha | GitHub, arXiv, 推文 |
| sparkDash | Mia's AI Lab | 面向 DGX Spark 和其他 NVIDIA GPU 主机的实时仪表盘 | 运维人员需要对 GPU、LLM、存储和网络行为进行跨异构机群的可观测性监控 | React、Express、SSH 采集器、Prometheus 导出、支持 Windows 和 Linux GPU 主机 | 已发布 | GitHub, 推文 |
| bitnet.cpp | Microsoft | 面向 CPU 和 GPU 上 1-bit LLM 的官方推理框架 | 对大模型来说,本地推理依然成本高且耗电 | BitNet b1.58 模型、优化的 CPU/GPU 内核、低比特推理运行时 | 已发布 | GitHub, 推文 |
最值得注意的模式,是围绕狭窄但反复出现的痛点展开的专业化。@AlexFinn 已发布(71 次点赞、23 条回复、6,847 次浏览、81 次收藏)构建了一层工作流发现层,因为用户在真正用上 agent 能力之前,仍然需要先看到示例;而 @alliekmiller(19 次点赞、14 条回复、2,016 次浏览、8 次收藏)则称赞 Meta Muse 在助手内部解决了同样的发现问题。
第二种模式是有界决策基础设施。@Nandakishorm1(182 次点赞、12 条回复、3,123 次浏览、60 次收藏)推出了一种新的类型化决策架构,而 @Sumanth_077(9 次点赞、5 条回复、854 次浏览)则强调了一个开放框架,可让这些决策实现去偏、概率化,并按需升级处理。反复触发这一需求的原因,与第 2 节和第 4 节中看到的是同一个:对于本应在一个小型答案集合内结束的任务,团队不愿为生成式模型付出成本。
第三种模式是,基础设施构建依然贴近底层。@MiaAI_lab(30 次点赞、7 条回复、3,896 次浏览、10 次收藏)上线了更广泛的遥测能力和 Windows 支持,而 @oliviscusAI(13 次点赞、1 条回复、529 次浏览、15 次收藏)则指向了 CPU 高效的 1-bit 推理。就连 Fold2Reason 中的研究型构建也遵循了这一模式:它不是靠笼统的品牌化叙事,而是通过一套具体的训练方案来攻克推理迁移问题。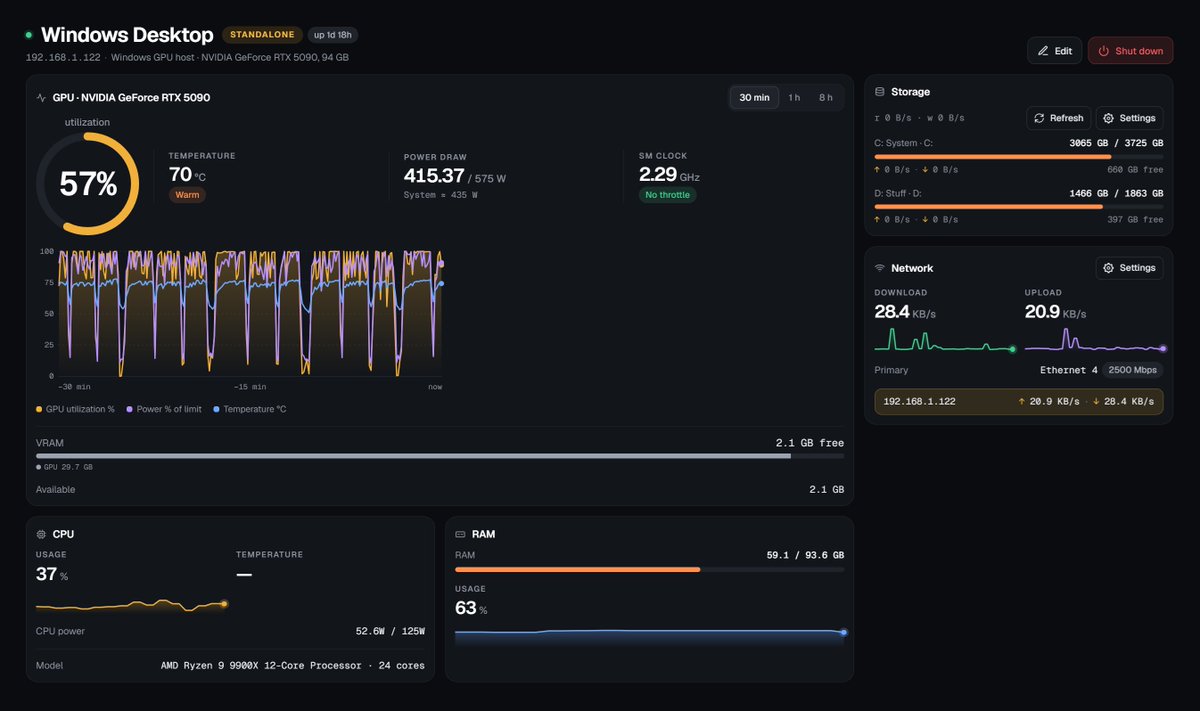
6. 新内容与重点动态
Fold2Reason 将蛋白质结构用作后训练信号,以扩展通用推理能力
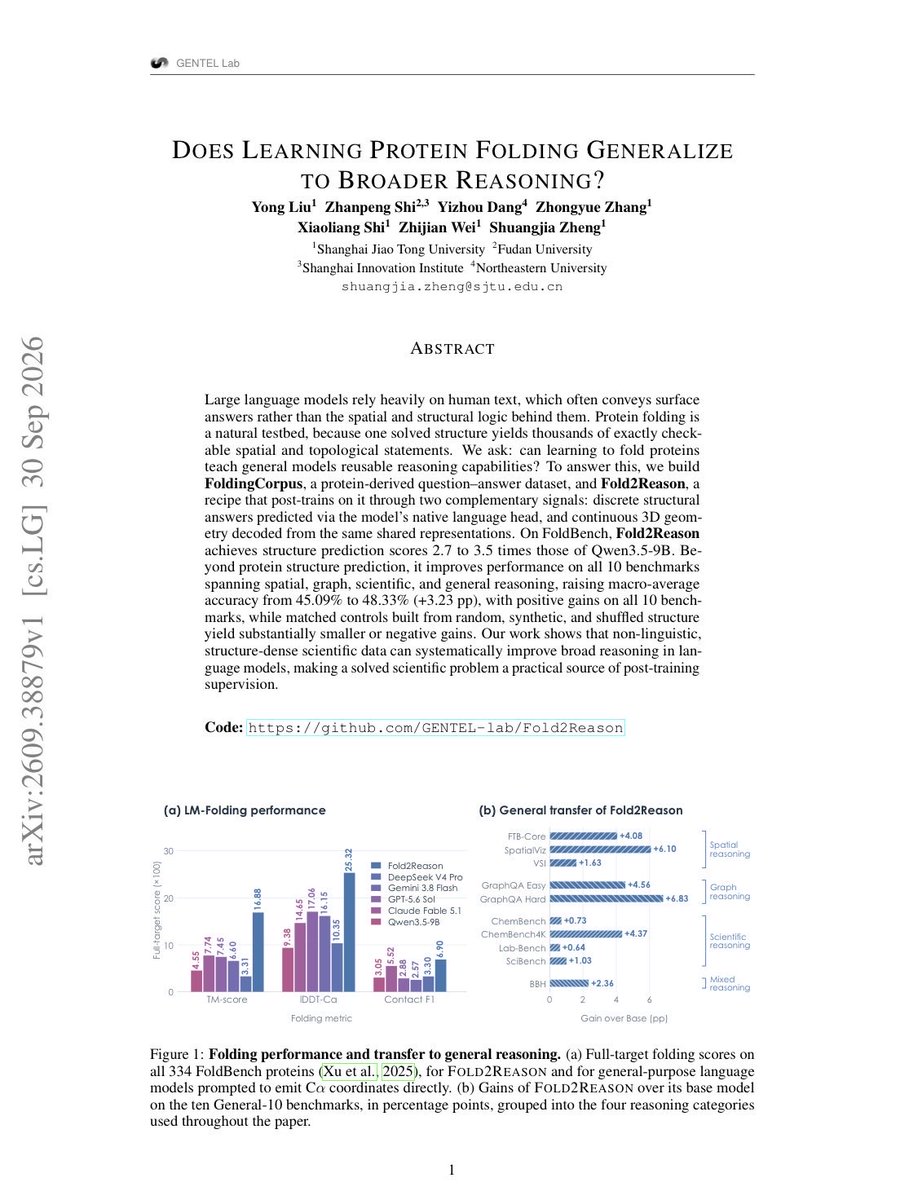
@gurtej__gill_ 重点介绍了(64 次点赞,5 条回复,2,122 次浏览,53 次收藏)提到一篇论文:它利用已解析的蛋白质结构,向模型传授可复用的空间与结构逻辑。随附页面和公开的 代码仓库 让这一主张显得格外具体:Fold2Reason 报告称,其结构预测得分达到基础版 Qwen3.5-9B 的 2.7 到 3.5 倍,通用推理宏平均成绩也从 45.09% 提升至 48.33%;而打乱或合成的对照组并未复现这种迁移效果。
bitnet.cpp 继续推进本地推理效率的叙事
@oliviscusAI 提到了(13 次点赞,1 条回复,529 次浏览,15 次收藏)将 Microsoft 的 bitnet.cpp 呈现为一种切实可用的本地推理成果,而非含糊其辞的承诺。公开的 README 为这条推文的表述提供了支撑:已公布的 CPU 加速在 x86 上最高可达 6.17 倍,能耗最高可降低 82.2%,并称一个 100B 的 BitNet 模型可以在单个 CPU 上以接近人类阅读的速度运行。
“答案经济”以图表形式变得清晰得多
@alexgroberman 已打包发布(29 次点赞,1 条回复,1,546 次浏览)把 G2 的调研浓缩成一句商业警告:如果 AI 不推荐你的品牌,成交的就会是别家的品牌。相关图片之所以重要,在于它们把这件事从一句口号变成了可衡量的漏斗变化:买家如今更常从 AI 而非 Google 开始,AI 聊天机器人在影响候选名单方面已超过评测网站和厂商页面,而实际发生交互的界面甚至可能只是一个简单的聊天机器人回答,而不是搜索结果页。

Meta Muse 的创意标签页展现了更扎实的消费级 AI 建议风格
@alliekmiller 称赞了(19 次点赞,14 条回复,2,016 次浏览,8 次收藏)提到 Meta Muse,并不是因为它在原始智能方面有什么宣称,而是因为它展示出的任务点子比常见的实验室 demo 更好。截图值得注意,是因为其中的示例都很具体、可操作:调整一个由合同驱动的日历时间块,将 Stripe 事件同步进排期,并排比较两笔品牌合作,以及承接另一位助手中的上下文。

7. 机会在哪里
[+++] Agent reliability infrastructure - Evidence came from both the memory thread and the eval thread. @0xwhrrari 显示了市场对具备时效性感知记忆的需求,而 @sermakarevich 则说明了为什么只看答案的评分方式会漏掉状态层面的失败。一个将记忆失效、状态回放、工具路径检查和最终状态评估结合起来的产品,将回应一个反复出现的现实抱怨。
[+++] 带升级处理的类型化决策层 - Vega 和 AnyJev 表明,路由、评分和安全检查正在成为独立的一层,而不再只是藏在聊天模型内部的提示词。这个机会之所以明显,在于收益非常具体:更低的延迟、受约束的输出,以及在置信度不足时更清晰地回退到完整推理。[++] Agent 工作流的发现与复用——Alex Finn 的工作流目录,以及人们对 Muse 更优创意建议的积极反响,都指向同一个缺口:用户仍然需要帮助,才能把模型能力转化为具体、可重复执行的任务。在产品能够把示例与提示词、类别、预期结果,以及工作流确实有效的证据配套呈现的场景里,这一点体现得最明显。
[++] AI-search visibility and citation analytics - The G2 numbers cited by @alexgroberman 表明,AI 正越来越多地决定哪些供应商能够进入候选名单。这个机会处于中等水平,因为需求真实存在,但这一赛道已经开始变得拥挤,而且可信度取决于可信的第三方引用。
**+] 混合机群 AI 可观测性** - [sparkDash 表明,运维人员仍然需要更好的遥测能力,能在一个地方同时覆盖 Windows 和 Linux GPU 主机、RDMA 链路、LLM 面板以及 Prometheus 导出。这一信号在今天的信息流中仍处于浮现阶段,而非主导地位,但它与更广泛的、迈向可观测且具备成本感知能力的 AI 基础设施趋势直接相连。
8. 要点
- Agent 可靠性已经从研究问题转变为运营问题。 留存表现最强的帖子,讨论的是工作流目录、记忆新鲜度和状态感知评测,而不是模型整体有多“聪明”。(Alex Finn 推文, 0xwhrrari 推文, sermakarevich 推文)
- 开放式类型化决策系统在昨天决策模型热度激增后继续升温。 Vega 扩展了这一类别中由创作者构建的一端,而 AnyJev 则提供了开源证据,表明有界决策、去偏和升级处理可以被封装为可复用工具。(Nandakishorm1 推文, AnyJev GitHub)
- AI 正日益成为需求生成层,而不只是产品功能。 Alex Groberman 所引用的 PR 发布重申了 G2 在 2026 年 3 月的调查数据:51% 的买家如今更常以 AI 而不是 Google 作为起点,69% 的买家则会根据 AI 的引导更换供应商。(PR Newswire, alexgroberman 推文)
- 专业化基础设施仍然获得了实质性关注。 当天最强的基础设施类内容不是泛泛而谈的云,而是本地推理的经济性、GPU 可观测性,以及 KV-cache 处理、批处理和路由等具体的服务栈技能。(suraj_sharma14 推文, bitnet.cpp GitHub,sparkDash GitHub)
- 具身智能仍然保持活跃,但今天释放出的信号,更多关乎评估理念,而非新的基准成绩突破。 保留下来的机器人相关帖子强调了可迁移的任务库、模块化专家,以及将记忆误当作泛化的风险。(ChuzzyTech 推文,Jaxon0x 推文)