YouTube AI - 2026-08-13
1. 人们在讨论什么
1.1 开放权重不再只是模型发布叙事,而是围绕本地代理、推理与基础设施展开的全栈竞争 🡕
至少有十条内容支撑这一主题。相比 2026-08-12 当天开放权重的讨论还主要集中在部署控制和模型周边工作空间,2026-08-13 的信息流则把叙事进一步压向更底层:战略、本地硬件适配、推理工程和资本开支,都被纳入了同一场竞争。

CNBC 提供了最宏观的战略框架,获得了 147,362 次观看、2,316 个赞和 588 条评论。其内容认为,美国虽然守住了芯片层,但依然缺乏开源 AI 战略;与此同时,来自中国的开放权重正变得更便宜、更容易运行在私有服务器上,也更贴近企业真实部署的重心。其独特视角在于,它将开放模型视为国家与企业的杠杆,而不只是开发者偏好的体现(视频)。


WorldofAI 给出了最清晰的本地硬件测试,获得 13,348 次观看、223 个赞和 17 条评论。Meta 的发布帖称,Muse Glimmer 是一个 30B、Apache 2.0 许可的模型,针对常开型本地代理工作流进行了优化,并通过量化和推测解码适配 24GB 到 32GB 的本地显存范围;WorldofAI 则在真实消费级硬件上,将这一承诺与 Qwen 做了对比测试。其独特视角在于,这一天对开放权重的评判标准,已经变成它们能否真正作为本地代理运行,而不只是能否被下载(视频, Meta 博客)。


Latent Space 释放了最强的运维侧信号,获得 47,120 次观看、265 个赞和 21 条评论。Baseten 的推理工程指南指出,模型发布之后的工作,如今已扩展到运行时、硬件、软件,以及量化、推测解码、KV-cache 复用、模型并行和解耦部署等优化技术。其独特视角在于,开放模型的势头最终仍会转化为系统设计劳动,而不是无摩擦的采用(视频, 指南)。
讨论洞察: Better Stack 通过 ThinkingCap-Qwen3.6-27B 将同一主题带入了更硬核的运营经济学层面——据称其平均推理 token 数减少了 46%;与此同时,The Information 和 Bloomberg Tech 表明,开放模型竞争同样也是一场算力支出竞赛:据报道,Nvidia 正推进一项 300 亿美元的云计算计划,而 Anthropic 正在探索一笔 60 亿美元的基础设施押注。
与前一天对比: 2026-08-12 让开放权重显得兼具战略意义和运营价值。到了 2026-08-13,同样的叙事则进一步扩展到了基础设施、量化和资本配置。
1.2 信任边界变得更尖锐:用户要么希望 AI 更少,要么希望更多本地控制,要么要求极其明确的上下文塑形 🡕
至少有六条内容支撑这一主题。相比 2026-08-12 对可见封装和有界工作流的信任,2026-08-13 的信息流让“边界”本身成为焦点:有创作者彻底否定 AI 编程,有人转向自托管搜索,而 Meta 对本地代理的定位,则直接围绕“助手需要看到一个人生活中的多少内容”来展开。


Brett Codes 给出了这组数据中最强烈的反弹信号,获得 287,265 次观看、15,496 个赞和 5,300 条评论。他关联的帖子称,AI 编程让他陷入冷漠、存在性焦虑和抑郁,并把他推入一个主要负责审查和测试代码、却不再对其拥有归属感的角色。其独特视角在于,反 AI 的论据建立在手艺、作者身份和心理健康之上,而不是抽象安全或劳动政治(视频, 文章)。

Fireship 是当天资料中单条最受关注的 Muse Glimmer 解读,获得 369,393 次观看、10,973 个赞和 506 条评论。Meta 的发布帖明确表示,一个有用的本地代理需要深度访问个人上下文,比如文件、消息、日程和截图,这使得该视频的切入点不再只是“更快的模型”,而更像是在讨论:若要给代理这样的触达范围,用户需要付出怎样的信任成本。其独特视角在于,当天最重磅的开放权重发布,同时也是一个关于个人边界的故事(视频, Meta 博客)。


Switch and Click 给出了最明确的退出式回应,获得 115,117 次观看、5,332 个赞和 324 条评论。其教程主张自托管 SearXNG,因为 Google 搜索如今广告过重、AI 成分也过重;而 SearXNG 项目本身则将自己描述为一个不会追踪或画像用户的元搜索引擎。其独特视角在于,对 AI 饱和的一种显性反应,并不是寻求“更好的 AI”,而是有意识地转向私密、可审视、无 AI 的检索(视频, 仓库)。
讨论洞察: IBM Technology 解释了这一信任主题为何反复出现:如果代理要可靠执行,上下文检索与上下文生成就必须协同塑形。Tech With Tim 和 PCWorld 则指向两种现实应对路径——一边是可自托管、支持模型与 harness 替换的工作空间,另一边是基于消费级硬件的本地代理部署。
与前一天对比: 2026-08-12 依然在奖励明确的封装层。到了 2026-08-13,信息流则把信任、作者身份、隐私和上下文控制变成了真正的门槛问题。
1.3 工作流优先的 AI 依然压过黑箱魔法,尤其是在创作者工具和单一任务代理中 🡒
至少有七条内容支撑这一主题。相比 2026-08-12 对封装和模板的强调,2026-08-13 的信息流继续偏爱那些把整套配方展示出来的产品:清晰的委派角色、面向创作者的本地工作流,以及能端到端解决某一个痛点任务的助手。

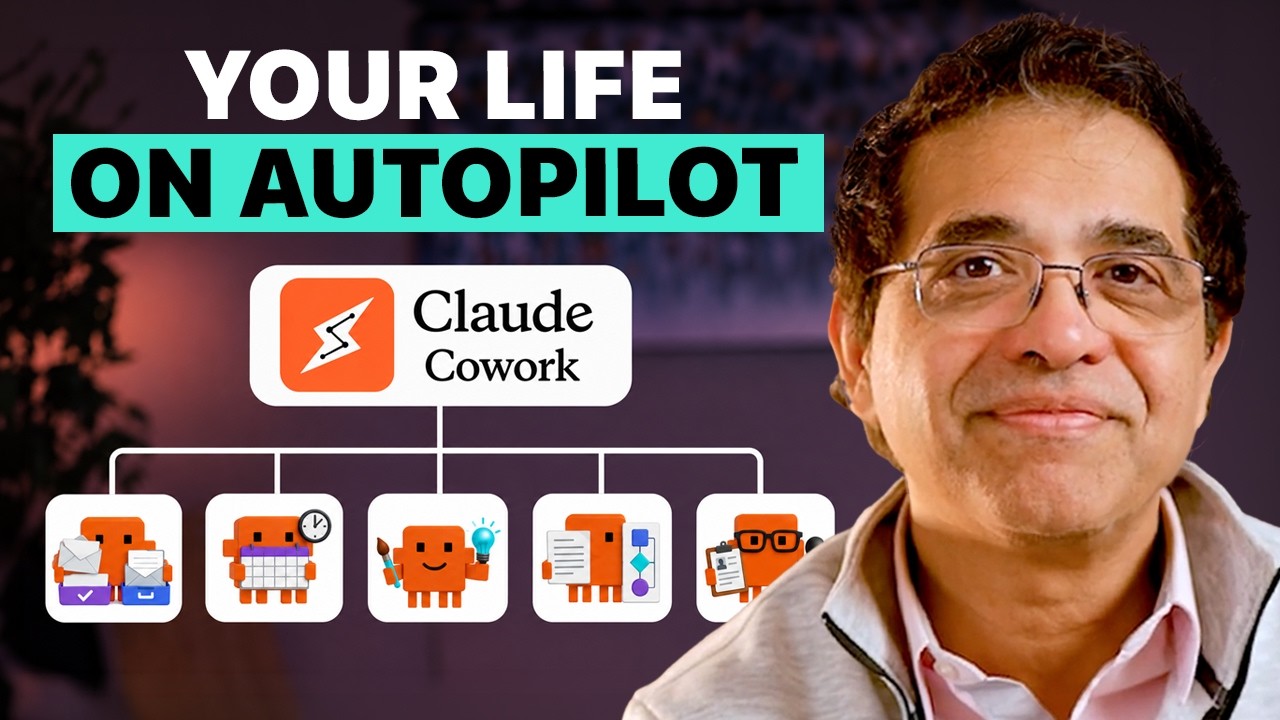
Sandeep Swadia 仍然是最强的广谱兴趣工作流信号,获得 658,289 次观看、17,658 个赞和 410 条评论。他的 Four Cs 框架把代理变成围绕协调、创意、清晰度和辅导展开的可复用角色,而不是模糊的未来能力。其独特视角在于,AI 最有效的销售方式,依旧是可见的操作习惯,而不是隐藏的后端(视频)。


AI Search 给出了最强的创作者工作流信号,获得 198,069 次观看、9,733 个赞和 1,200 条评论。ComfyUI 的文档称,MiniMax H3 原生提供 text-to-video、image-to-video 和 reference-to-video 模板,支持多模态参考、立体声音频以及最高 2K 输出,因此吸引力并不在于又一个通用模型发布,而在于一套现成的本地生产配方。其独特视角在于,创作者的注意力依旧更多追随工作流形态,而不是模型名望本身(视频, 文档)。


Techno Mike 提供了最清晰的窄领域代理证明点,获得 135,616 次观看、2,105 个赞和 423 条评论。该视频测试了 Pine AI 在真实车险谈判中的表现,而 Pine 官网称,这项服务目前拥有 150k+ 用户、93% 的谈判成功率,以及平均节省 270 分钟。其独特视角在于,一个“代理”之所以显得可信,恰恰是因为它处理的是一个有可见结果的官僚式单一任务,而不是承诺无所不能(视频, 网站)。
讨论洞察: BMF MEDIA 和 Curious Refuge 让创作者侧始终锚定在真实生产环境中。其一强调了 LTX-2.3 中的插帧、局部重绘、扩图、风格重塑和 LoRA 训练;其二则认为,MiniMax H3 的开放权重优势依然伴随着许可限制,而且在物理表现或多镜头叙事上弱于 Seedance(评测)。
与前一天对比: 2026-08-12 就已经在奖励可见工作流。到了 2026-08-13,这一偏好保持稳定,并进一步转向编辑控制、本地部署和硬结果指标。
2. 什么让人沮丧
当人类沦为审查者、测试者和责任兜底者时,AI 编程依然会失灵
这是高严重度问题,因为 Brett Codes 提供了这组数据中最清晰的一手描述:AI 编程让他与软件本身脱节,把他推向代码审查和质量保障,而非作者身份,并让他感觉自己学得更少而不是更多。IBM Technology 则从系统层面解释了同一个问题:更多原始上下文并不会自动产出可靠输出;上下文必须被有意识地检索与塑形。可见的应对方式,要么是彻底退出 AI 编程,要么是收窄 AI 所扮演的角色,以便人类仍然掌握推理路径。这是非常值得围绕其构建产品的方向。
开放权重的采用,仍然把硬件、路由和服务复杂性一股脑丢给运营方
这是高严重度问题,因为 CNBC、WorldofAI、Latent Space、Better Stack、The Information 和 Bloomberg Tech 都在描述同一负担的不同组成部分。如今,团队必须先评估开放模型的来源、本地硬件适配、token 效率、推理栈设计以及算力的资本密集度,模型才能在生产中真正有用。可见的变通方式,是通过路由、量化、面向效率的微调,以及对基础设施的重投入,而不是直接部署。这是非常值得围绕其构建产品的方向。
面向创作者的 AI 视频,仍迫使用户在本地控制、免费获取、编辑深度和分发权利之间来回权衡
这是高严重度问题,因为 AI Search、BMF MEDIA 和 Curious Refuge 都从不同方向指向了同一组权衡。一条路径强调现成的本地模板,另一条强调插帧、局部重绘、风格重塑和 LoRA 训练,而最强的外部评测仍指出,即便开放模型看起来很有吸引力,许可限制和运动质量仍可能阻碍其公开使用。可见的变通方式,是持续进行工具比较与路径切换,而非在一个稳定的创作者技术栈上定下来。这是非常值得围绕其构建产品的方向。
只有当隐私、上下文和范围都明确时,个人助手才会让人觉得可以接受
这是高严重度问题,因为 Fireship、Switch and Click、Techno Mike 和 Tech With Tim 都从不同角度奖励了同一种产品行为。人们要么想要更少的 AI,比如自托管搜索;要么想要更窄、更可审视的助手,比如账单谈判,或者支持模型切换与显式记忆的可自托管协作助手。可见的变通方式,是自托管、供应商多样化,以及边界清晰的工作流,而不是一个无所不包的通用个人代理。这是非常值得围绕其构建产品的方向。
3. 人们希望出现什么
AI 编码审查与作者身份台账
Brett Codes 和 IBM Technology 暗示,人们需要这样一类工具:记录哪些内容由 AI 编写、实际经过了多少人工审查、上下文质量在哪里失效,以及开发者是否仍足够理解最终系统、能对其负责。这是一个高紧迫度的现实需求,因为最强的反 AI 编程证据,指向的是作者身份流失与审查负担过重,而不只是代码补全效果差。如今 IDE 遥测和代码审查工具只解决了部分问题,还没有打通完整的作者身份与责任闭环。机会:直接。
开放模型路由与本地部署驾驶舱
CNBC、WorldofAI、Latent Space、Better Stack、The Information、Bloomberg Tech 和 PCWorld 暗示,人们需要一个统一界面,用来比较开放与闭源模型的来源、硬件适配、token 效率、服务方案和基础设施成本。这是一个高紧迫度的现实需求,因为现有证据不断把运营决策拆散在战略覆盖、本地基准测试、推理工程和资本市场新闻之间。如今路由器和基准仪表盘只解决了部分问题,还没有形成完整的运营驾驶舱。机会:直接。
保持信任的个人 AI 工作空间
Fireship、Tech With Tim、Switch and Click 和 IBM Technology 暗示,人们需要一个工作空间:让权限、记忆、检索和模型选择都保持清晰可见,同时允许用户决定哪些内容保留在本地、哪些可以共享、哪些则完全排除在 AI 系统之外。这是一个高紧迫度的现实需求,因为这一天反复把上下文访问视为最核心的信任边界。如今自托管工具和协作助手应用只解决了部分问题,还没有形成完整的隐私与控制层。机会:直接。
创作者工作流与权利路由器
AI Search、BMF MEDIA 和 Curious Refuge 暗示,人们需要一款产品,能在创作者投入时间或金钱之前,就比较本地工作流、编辑能力、硬件负担、输出质量和区域分发权利。这是一个高紧迫度的现实需求,因为最强的创作者侧证据依然分散在教程、评测和许可限制提示之间。如今文档和评测频道只解决了部分问题,还没有解决路径选择问题。机会:直接。
面向消费者行政事务、可追踪结果的服务型代理
Techno Mike 和 Sandeep Swadia 暗示,人们需要那种一次专注解决一个重复、烦人的任务,同时让权限、状态和节省效果都清晰可见的助手。这是一个中等紧迫度的现实需求,因为其价值主张极其清晰,但 Pine 已经表明,这一类别正在从概念走向产品。如今通用 copilots 只解决了部分问题,还没有形成具备可量化 ROI 的完整任务型执行层。机会:竞争型。
私密搜索与来源优先的发现方式
Switch and Click 暗示,人们需要既能保留可见链接、隐私和引擎选择,又不要求用户变成家庭实验室运维者的产品。这是一个中等紧迫度的现实需求,因为行为信号真实存在,但规模小于开放模型部署或创作者工具。如今元搜索引擎只解决了部分问题,还没有提供适合主流用户的迁移与管理层。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| MindsHub Cowork | 代理工作空间 | (+) | 可切换开放或闭源模型、可替换的代理 harness,以及连接数据、记忆和产物的能力,让工作空间本身更具持续性 | 仍然需要用户自己决定应向代理开放哪些上下文和权限 |
| Muse Glimmer | 本地代理模型 | (+/-) | Apache 2.0 发布、面向本地代理、多模态输入、工具使用,以及 24GB 到 32GB 的本地目标配置,让本地代理显得更可行 | 个人上下文需求、硬件限制和本地部署复杂度,仍然把信任门槛维持在高位 |
| ThinkingCap-Qwen3.6-27B | 推理模型优化 | (+) | 平均约减少 46% 的推理 token,使延迟和推理成本更容易控制 | 仍需按具体工作负载验证,并继承更广泛的 Qwen 部署选择问题 |
| SearXNG | 搜索 | (+) | 无追踪、无画像的自托管元搜索,为用户提供了一个私密、弱 AI 化的检索界面 | 需要自托管、维护,以及愿意自行管理搜索栈 |
| MiniMax H3 + ComfyUI 工作流 | 本地视频工作流 | (+/-) | 原生 T2V、I2V 和 R2V 模板、立体声音频、多模态参考以及本地控制,让创作者工作流更可复用 | GPU 负担、工作流搭建,以及许可或质量方面的限制,仍拖慢采用 |
| LTX-2.3 | AI 视频模型 | (+/-) | 强大的编辑界面,支持插帧、Retake、局部重绘、扩图、风格重塑和 LoRA 训练 | 仍需要提前规划硬件,并且在运动表现或整体输出质量上可能落后于更强模型 |
| Pine AI | 消费者谈判代理 | (+) | 具体的结果指标与清晰的任务边界,让代理价值主张一目了然 | 领域覆盖较窄,意味着隐私和信任必须一个工作流一个工作流地建立 |
| 上下文工程 | 代理方法 | (+/-) | 通过把原始检索转化为结构化、可执行的模型输入,提升可靠性 | 依赖上游检索质量和审慎的系统设计,而不是单一开箱即用工具 |
| 推理工程栈 | 服务方法 | (+/-) | 路由、量化、缓存复用和解耦部署,让开放模型能够在生产环境中真正可用 | 运维开销很高,而且工具链变化速度和模型本身一样快 |
最强的正向情绪集中在那些要么恢复用户控制、要么完成一个窄任务的工具上:可切换模型的工作空间、私密搜索、token 效率优化、可复用的创作者工作流,以及谈判代理。它们都让 AI 这一层变得更清晰,而不是更“神奇”。
只要用户仍要承担太多隐藏决策,情绪就会转为复杂。本地代理模型、视频栈、上下文工程方法和推理栈都显得有用,但它们也都把某种形式的负担留给了运营方:硬件压力、权利分析、编排复杂性或信任风险。
迁移趋势更偏向自托管、路由层和窄用途助手,而不是单模型默认方案。竞争逻辑正从“谁的基础模型最聪明”,转向“谁能在不交出太多控制权的前提下,让模型真正可用”。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| MindsHub Cowork | MindsHub | 一个工作空间:你可以为整个项目做统筹说明、切换模型或 harness,并把结果、记忆和数据保存在同一处 | 用户希望代理工作流能够超越聊天记录,又不愿接受供应商锁定 | Model Router、Anton/Hermes harnesses、connectors、memory、artifacts、scheduling | 已发布 | 网站, 仓库, 视频 |
| SearXNG deployment | SearXNG 贡献者 | 无追踪、无画像的自托管元搜索引擎 | 搜索用户希望获得私密、可审视的检索,而不是默认被 AI 重度介入 | 元搜索引擎、自托管、可配置搜索引擎 | 已发布 | 仓库, 视频 |
| ThinkingCap-Qwen3.6-27B | BottleCap AI | 一个微调版 Qwen 变体,减少过度思考,同时保留大部分性能 | 团队希望在不更换整个模型家族的前提下,获得更便宜、更快的推理 | Qwen3.6-27B、微调、Apache 2.0 发布、Hugging Face 分发 | 已发布 | 文章, 视频 |
| Muse Glimmer | Meta | 面向编码、工具使用、多模态推理和长时工作流的开放 30B 本地代理模型 | 开发者希望获得可在本地运行的代理,而不是完全依赖云端 | 30B 模型、4-bit 量化、DFlash speculative decoding、本地运行时与服务集成 | 已发布 | 博客, 视频 |
| MiniMax H3 workflow stack | MiniMaxAI | 面向文本、图像和参考视频生成的开放权重创作者工作流,原生支持立体声音频 | 创作者希望获得可复用的本地视频生成流程,而不是脆弱的一次性提示词 | MiniMax H3、ComfyUI、T2V/I2V/R2V templates、本地 GPU、Hugging Face 权重 | 已发布 | 文档, 视频, 评测 |
| Pine AI | Pine | 可拨打电话、谈判、处理投诉并取消订阅的 AI 助手 | 人们希望把痛苦的生活行政事务外包出去,而不只是得到建议 | 语音通话、工作流自动化、谈判流程、消费者账户操作 | 已发布 | 网站, 视频 |
| Gemini Robotics ER 2 | Google DeepMind | 高层具身推理模型,可聊天、规划、调用工具,并为机器人协调多步骤物理任务 | 开发者希望机器人能对现实世界任务进行推理,并在出错时恢复 | 具身推理模型、Gemini API、工具调用、VLA handoff、多模态流 | 测试版 | 博客, 视频 |
MindsHub 和 SearXNG 在不同领域体现了同一种构建者直觉:信任存在于模型之外的那一层界面中。前者通过路由、记忆、连接器和产物来封装代理,后者则通过隐私、自托管和可见链接来封装搜索。
ThinkingCap 和 Muse Glimmer 则展现了第二种模式:压缩成本与控制层,直到开放模型呈现为一种运营方案,而非意识形态主张。两者卖点都不主要是抽象智能,而是更易于运行或部署某个已知模型家族的方式。
MiniMax H3、Pine 和 Gemini Robotics ER 2 展现了第三种模式:最可信的 AI 产品,依然会划出清晰的工作流边界。创作者流水线、消费者谈判和多步骤物理任务,看起来都比“万能助手”式的泛化主张更有说服力。
6. 新内容与值得关注的点
拒绝 AI 编码成为高互动的创作者话题
Brett Codes 值得关注,因为这种反弹并不是以政策论战或基准测试抱怨的形式出现,而是一份关于作者身份流失、手艺退化,以及开发者被降格为审查与质量保障的一手叙述;它吸引了 5,300 条评论,是这份资料中最强的互动信号之一。
Muse Glimmer 让本地代理讨论的核心,从模型权重转向个人上下文
Fireship 和 WorldofAI 值得关注,因为它们把 Meta 的发布同时视为一则本地性能故事和一则信任故事。Meta 自己的帖子明确表示,有用的代理需要深度访问个人上下文,这也引出了一个问题:为了换取本地自治,用户愿意暴露多少内容(博客)。
围绕开放模型的算力竞赛变得公开化
The Information 和 Bloomberg Tech 值得关注,因为它们把开放模型讨论从功能层面直接拉到了资产负债表层面。Nvidia 据称将推动 300 亿美元的算力投入,Anthropic 可能达成 60 亿美元的基础设施交易,再加上周边对 CoreWeave 和 Cerebras 的讨论,都让部署经济学成为了头条级内容。
Gemini Robotics ER 2 将代理叙事延伸到了物理系统
TheAIGRID 值得关注,因为其背后的 Google 发布已经超越了聊天和桌面使用场景。Google 称,Gemini Robotics ER 2 能聊天、对物理世界进行推理、调用工具、基于连续视频反馈进行适应,并支持多机器人协作,这让“agentic AI”不再局限于屏幕之内(博客)。
无 AI 搜索的行为信号依然清晰可见
Switch and Click 值得关注,因为它把对 AI 塑形搜索结果的不满,转化成了一条具体的自托管迁移路径。这个信号不只是对 Google 的不信任,更是用户愿意运行一个明确以隐私、可审视性以及无追踪、无画像为优先级的替代方案(仓库)。
7. 机会在哪里
**+++] 开放模型路由与本地部署工作空间** - [CNBC、WorldofAI、Latent Space、Better Stack、The Information 和 Bloomberg Tech 都指向一个强需求:需要一个统一界面,把来源、成本、硬件适配、推理选择和部署风险整合起来。之所以说这是强需求,是因为同样的痛点从政策层覆盖一路延伸到了本地部署层。
**+++] AI 编码作者归属、评审与返工平台** - [Brett Codes 和 IBM Technology 暗示,人们强烈需要能够显示 AI 生成代码来源、实际审查程度,以及人类是否仍理解最终系统的产品。之所以说这是强需求,是因为痛点既是情绪层面的,也是运营层面的。
**+++] 保护信任的个人 AI 上下文保险库** - [Fireship、Tech With Tim、Switch and Click 和 IBM Technology 都暗示,人们强烈需要能让权限、检索、记忆以及本地与远程边界保持明确的产品。之所以说这是强需求,是因为个人上下文访问是当天反复出现的主要信任障碍之一。
**++] 创作者工作流与权益路由器** - [AI Search、BMF MEDIA 和 Curious Refuge 暗示,中等偏强的需求在于:需要一个统一入口,在创作者选定技术栈之前,就能比较模板、编辑功能、硬件需求、输出质量和许可限制。之所以说这是中等偏强,是因为痛点重复出现且非常实际,但主要集中在一个受众群体中。
**++] 具有可见 ROI 的垂直服务代理** - [Techno Mike 和 Sandeep Swadia 表明,对于那种一次只处理一个重复任务、同时让权限、节省金额和状态都清晰可见的助手,存在中等偏强的机会。之所以说这是中等偏强,是因为当范围和结果都很具体时,信任会显著上升。
**+] 私密搜索与以来源为先的发现界面** - [Switch and Click 暗示,一个正在浮现的机会是:构建既能保留可见链接和隐私、又不要求用户自托管整套系统的产品。之所以说这是新兴机会,是因为行为信号真实存在,但规模小于上述模型部署和编码信任两大类。
8. 要点总结
- 开放权重如今已是一个全栈运营问题,不再只是一次发布事件。 CNBC 提供了战略层的框架,WorldofAI 测试了本地硬件层,而 Baseten 则梳理了权重发布之后才真正开始的推理工程层。(来源, 来源, 来源)
- 这场信任之争,本质上是在争夺上下文、作者身份和隐私的边界。 Brett Codes 以手艺为由拒绝 AI 编码,Meta 对 Muse Glimmer 的定位预设了对深度个人上下文的访问,而 SearXNG 则代表了转向私密检索的退出路径。(来源, 来源, 来源)
- 可见的工作流配方,依然胜过黑箱式 AI 承诺。 Sandeep 的 Four Cs、ComfyUI 的 MiniMax H3 模板,以及 Pine 的谈判流程,都通过预先展示操作形态,让产品变得清晰可理解。(来源, 来源, 来源)
- 竞争优势正转向控制力与效率,而不是单纯的模型神秘感。 ThinkingCap 的 token 效率叙事、MindsHub 的可切换工作空间,以及 Muse Glimmer 的本地代理目标,卖的都是更可用的操作界面,而不只是更大的模型故事。(来源, 来源, 来源)
- 算力经济学和具身代理,是接下来值得关注的相邻前沿。 The Information 和 Bloomberg 让基础设施支出成为头条话题,而 Google 的 Gemini Robotics ER 2 则把同一场代理讨论推进到了物理任务和多机器人协同之中。(来源, 来源, 来源)