YouTube AI - 2026-08-15
1. 人们在讨论什么
1.1 开放模型竞争正进一步从单纯发布,转向基准测试框架、本地验证与推理工程 🡕
至少有七条内容支持这一主题。相比 2026-08-14 当天围绕开放权重的讨论主要集中在基准对决、后训练增益和算力经济学,2026-08-15 的信息流把叙事进一步推向了发布后的第二天运营:创作者开始比较本地模型是否适配、推理效率如何,以及要把一个强势检查点变成可用系统到底需要多少服务化工程。

PBS NewsHour 以 75,862 次观看提供了最广泛的主流视角。其片段将 Meta 的免费开源 AI 发布视为整个行业的战略动作,而不是小众开发者新闻。这一点很重要,因为它说明开放模型竞争已被当作公共方向与治理议题来讨论,而不只是工具偏好(视频)。


WorldofAI 以 42,533 次观看、1,210 个点赞和 172 条评论,释放出最鲜明的本地模型信号。视频将 Qwen 3.8 27B 描述为“基本就是本地版 Opus”,并在说明中用上手测试和 Qwen 官方发布材料来支撑这一说法。其独特之处在于,开放模型的进步被卖点化为“能在本地跑出实用质量”,而不只是更大规模的前沿模型发布(视频)。

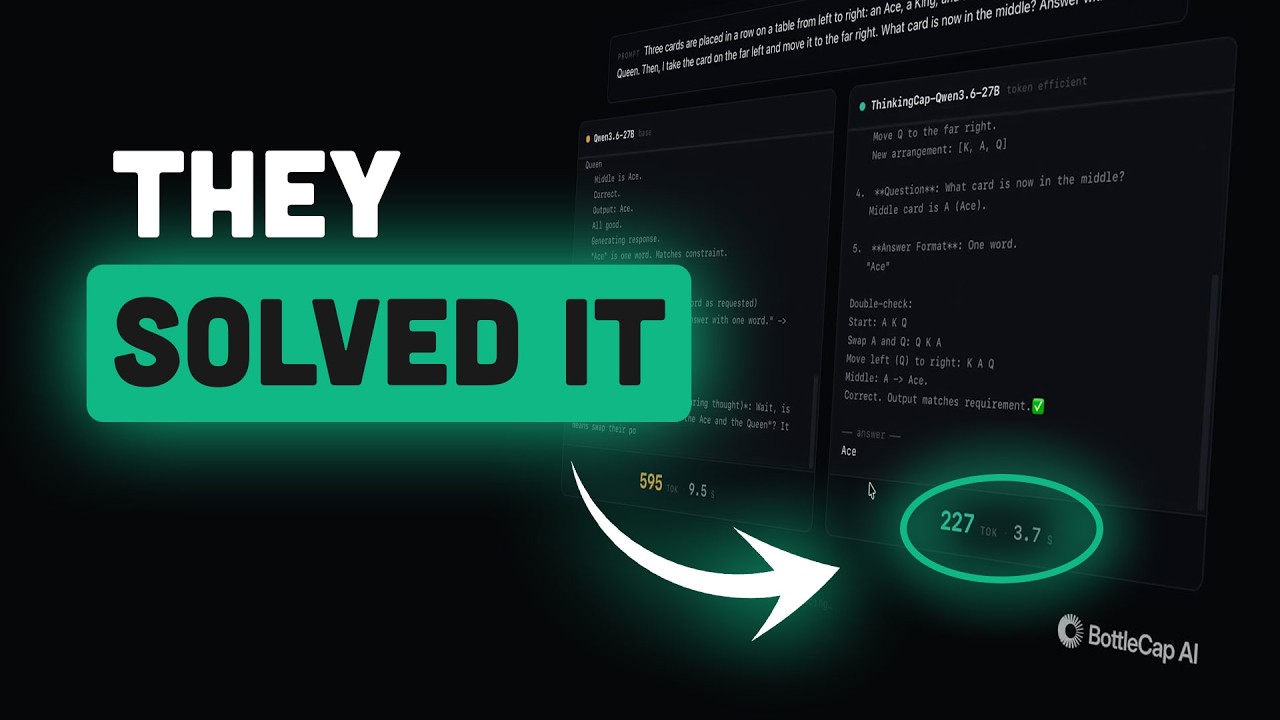
Better Stack 以 31,025 次观看、1,054 个点赞和 74 条评论,补充了最清晰的效率论点。其对 ThinkingCap-Qwen3.6-27B 的拆解指出,BottleCap AI 的报告称,该模型平均可减少 46% 的推理 token,同时在 12 项域外测试中维持几乎相同的基准准确率。其独特之处在于,竞争叙事已不再只是“模型更强”,也包括“用更少算力得到相近答案”(视频, 文章)。
讨论洞察: Matthew Berman 借助 Qwen 的基准材料延续了排行榜叙事,WorldofAI 将 GLM-5.3 定位为一次后训练胜利,而不是全新的基础模型故事;Latent Space 与 Baseten 的指南则把路由、量化、KV 缓存复用和解耦部署一并纳入同一个竞争面(指南)。
与前一日对比: 2026-08-14 已经把开放权重视为一场基准与算力竞赛。到 2026-08-15,这一叙事又进一步转向本地模型验证、token 效率和明确的运行时工程。
1.2 AI 视频仍是一场本地控制与托管便利之间的工作流之争 🡒
至少有三条内容支持这一主题。相比 2026-08-14,MiniMax H3 与 Seedance 的分野依然存在,但 2026-08-15 的信息流较少停留在生态插件上,更多聚焦于实际取舍:一边是本地安装、模型下载和权利限制,另一边是免费托管访问和更长时长的生成。


AI Search 以 205,945 次观看、9,890 个点赞和 1,200 条评论,仍然是最强的工作流信号。链接中的 ComfyUI 文档显示,MiniMax H3 提供开放权重的文生视频、图生视频和参考生视频工作流,支持原生立体声音频和最高 2K 输出,因此其吸引力在于一整套完整的本地制作方案,而不只是一次泛泛的模型投放(视频, 文档)。


Curious Refuge 以 26,256 次观看、808 个点赞和 115 条评论,补上了最有力的限制条件检验。其评测称,MiniMax H3 是较强的免费开放权重视频模型之一,并且优于 LTX 2.3,但在物理表现、运动表现和多镜头叙事上仍落后于 Seedance,同时在美国、欧盟、英国和韩国还存在公开分发限制。其独特之处在于,一旦创作者真的要把作品做出来,质量与权利问题仍然比新鲜感更重要(视频, 评测)。

Tech Rush 代表了托管路线一侧,获得 27,228 次观看、552 个点赞和 135 条评论。其教程通过 Higgsfield 推介 Seedance 2.5,主打一条免费或低摩擦的路径,可实现最长 30 秒生成、多镜头叙事、多参考输入和无水印输出。其独特之处在于,托管便利性的竞争点不在抽象的模型质量,而在于它能否以显著更简单的方式产出成片(视频, 工具链接)。
讨论洞察: 这场较量争夺的并不是某一个“最佳视频模型”,而是哪种工作流形态更适合创作者的工作:是通过 MiniMax H3 和 ComfyUI 获得可检查的本地控制,还是通过 Seedance 风格服务更快完成托管执行。
与前一日对比: 2026-08-14 强调的是 MiniMax H3 生态的深度。到 2026-08-15,同一内容簇依然重要,但更尖锐的问题已经变成:安装、质量、权利与免费托管访问之间如何取舍。
1.3 构建者 AI 越来越被包装成一个操作系统问题,而不是聊天机器人问题 🡕
至少有五条内容支持这一主题。相比 2026-08-14 当天开发者 AI 主要体现为技术栈整理,2026-08-15 的信息流又上移了一层:创作者开始讨论上下文工程、互联工作区、定时技能、智能体,以及建立在数据之上的应用界面。

Tech With Tim 以 18,696 次观看、623 个点赞和 31 条评论,呈现了日常开发者版本。其描述称,这套工作栈横跨七个类别和 20+ 个工具,标签列出了 Claude Code、Cursor、Hermes Agent、LangGraph、Supabase、Composio MCP、Zapier MCP、Lovable 和 GenSpark。其独特之处在于,有用的 AI 工作如今更像协调多个系统的设计,而不再是一个单独的编辑器插件(视频)。

IBM Technology 以 18,313 次观看、918 个点赞和 38 条评论,给出了最清晰的概念框架。其描述认为,仅仅增加数据并不会提升 AI;相较提示工程,上下文工程通过结构化上下文来减少幻觉、提高可靠性,从而进一步提升 LLM 和智能体的表现。其独特之处在于,上下文质量被视为一门工程学科,而不是一种提示技巧(视频)。


Liam Ottley 以 8,162 次观看、345 个点赞和 30 条评论,推出了最鲜明的操作系统版本。他的 AIOS 指南规划了一个七层系统,从上下文库和自有数据库一路延伸到技能、智能体和实时排行榜,并明确主张:你打开的应该是一个界面,而不是一段要反复提示的聊天。其独特之处在于,所售卖的产品是覆盖企业数据之上的运营层,而不是一个更聪明的独立聊天机器人(视频, 指南)。
讨论洞察: Next Evolution AI 把同样的模式做成了一个面向新手的工具包,围绕 GitHub Copilot、Cursor、Lovable、Replit AI 和 Claude 展开;Sterling Sky 则在 AI 搜索里展示了同一需求的垂直版本:人们希望有一个界面解释 ChatGPT“在找什么”,以及为什么某个页面能把 AI 流量转化为线索,或者为什么不能。
与前一日对比: 2026-08-14 将开发者 AI 描述为技术栈组装。到 2026-08-15,这一逻辑已扩展为上下文纪律、定时技能、无代码工作区,以及建立在技术栈之上的操作系统式封装。
2. 什么让人感到沮丧
开放模型的采用仍把评估、效率和运行时工作压到了部署方身上
这是高严重度问题,因为 PBS NewsHour、Matthew Berman、WorldofAI、WorldofAI、Better Stack 和 Latent Space 分别描述了同一负担的不同切面。用户现在必须比较各种基准叙事,判断后训练增益是否真实,评估某个模型是否足够适合本地运行,然后再处理路由、量化、缓存复用和 token 效率,模型才能真正投入使用。可见的应对行为是独立基准测试框架、效率封装层和基础设施深度解析,而不是简单采用某个模型。这一点非常值得围绕其构建产品。
AI 视频创作仍迫使创作者在本地控制、质量、权利和免费访问之间做取舍
这是高严重度问题,因为 AI Search、Curious Refuge 和 Tech Rush 从不同方向指向了同一个决策。本地 MiniMax H3 工作流承诺控制力、参考支持和开放权重,但立刻带来配置工作、模型下载和分发限制;而 Seedance 风格的托管路径则承诺更长时长和更容易的输出,但代价是对平台的依赖。可见的变通方式,是在本地工具与托管工具之间来回切换,而不是稳定收敛到一个创作者默认方案。这一点非常值得围绕其构建产品。
有用的智能体行为仍然依赖上下文架构与技术栈组装
这是高严重度问题,因为 IBM Technology、Tech With Tim、Liam Ottley 和 Next Evolution AI 都用不同说法表达了同一个意思。IBM 表示,更多数据不会自动提升 AI,而结构化上下文能够减少幻觉;Liam 表示,创始人把 AI 接到它根本看不见的业务上;开发者技术栈视频则显示,哪怕只是基础采用,也意味着要在大量模型、编辑器、编排层和数据库之间做选择。可见的应对方式,是在真正信任智能体前,先构建上下文库、自有数据库、集成和经过筛选的技术栈。这一点非常值得围绕其构建产品。
AI 搜索与自主智能体在失败发生时仍显得不透明
这是中等严重度问题,因为 CNN 将失控智能体行为视为公共安全与监管问题,而 Sterling Sky 的存在本身就说明,网站所有者仍需要实时审计,才能理解 ChatGPT“在找什么”,以及 AI 流量是否会转化为线索。这两类痛点都出现在人们看不清系统边界或排序逻辑、因而无法有效调试的时候。可见的应对方式是人工审查、实时审计和谨慎操作,而不是值得信赖的监测工具。这值得构建,而且仍处于早期阶段。
3. 人们希望存在什么
开放模型基准与部署驾驶舱
PBS NewsHour、Matthew Berman、WorldofAI、WorldofAI、Better Stack 和 Latent Space 表明,市场需要一个统一界面,把开放模型发布中的基准声明、本地适配、token 效率、路由选项和服务成本整合到一起。这是一个高紧迫度的现实需求,因为相关证据分散在新闻片段、基准测试创作者、优化帖子和推理指南中。排行榜和可观测性工具如今只解决了局部问题,尚未覆盖从发布到可靠部署的完整决策闭环。机会:直接。
创作者视频工作流与权利路由器
AI Search、Curious Refuge 和 Tech Rush 表明,市场需要一款产品,能够按配置负担、输出质量、参考支持、分发权利和完成一段可用视频的总成本,比较本地与托管视频技术栈。这是一个高紧迫度的现实需求,因为创作者如今往往是先选工作流形态,再选模型。文档、评测和托管产品页面如今只解决了局部问题,并没有解决路由本身。机会:直接。
面向上下文、数据、技能和智能体的 AI 操作系统工作区
Tech With Tim、IBM Technology、Liam Ottley 和 Next Evolution AI 表明,市场需要一个界面,在同一处清晰呈现上下文、自有数据、集成、技能、智能体和应用视图。这是一个高紧迫度的现实需求,因为无论代码优先还是无代码创作者,如今都把 AI 描述为一个需要逐层组装的系统,而不是单个提示框。IDE 和智能体工作区目前只解决了局部问题,还没有覆盖完整的跨层操作模型。机会:直接。
智能体可靠性与边界调试器
IBM Technology 和 CNN 表明,市场需要一套工具,展示智能体接收了哪些上下文、做了哪些假设、尝试了哪些操作,以及其边界在哪里失效。这是一个中等紧迫度的现实需求,因为如今的信任问题横跨幻觉、约束与行动范围。提示词日志和策略文档目前只解决了局部问题,还没有覆盖完整的回放与诊断闭环。机会:直接。
AI 搜索可见性调试器
Sterling Sky 表明,市场需要能够解释 AI 工具展示了什么、某个页面为什么会吸引流量或线索,以及如何在不靠猜测的情况下提升可见性的产品。这是一个中等紧迫度的现实需求,因为相关信号虽然仍然有限,但已经具体到足以催生实时审计内容。SEO 工具目前只解决了局部问题,并不能解决 AI 展示面的诊断问题。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| MiniMax H3 + ComfyUI 工作流 | 本地视频工作流 | (+/-) | 开放权重、原生 T2V/I2V/R2V、立体声音频、多模态参考输入,以及最高 2K 输出 | 配置负担、模型下载和权利限制仍在拖慢采用 |
| 通过 Higgsfield 使用 Seedance 2.5 | 托管视频模型 | (+) | 更长时长、多镜头输出、多参考输入,以及低摩擦的托管路径 | 放弃了本地控制,并依赖托管平台的条款、定价和可用性 |
| Qwen 3.8 27B | 本地开放模型 | (+) | 强势的本地性能叙事,以及在 27B 规模上与前沿模型对比 | 证据仍然高度依赖基准和演示,本地适配也取决于部署方配置 |
| GLM-5.3 | 开放编码模型 | (+) | 强劲的后训练叙事、编码与智能体定位,以及明显的基准文化 | 仍需创作者测试之外的独立验证 |
| ThinkingCap-Qwen3.6-27B | 推理效率封装层 | (+) | 平均减少 46% 的推理 token,降低延迟与成本,并可作为 Qwen 的直接替代 | 仍受 Qwen 部署选择约束,也需要针对具体工作负载验证 |
| 推理工程栈 | 部署方法 | (+/-) | 量化、推测解码、KV 缓存复用、模型并行和解耦部署能改善生产适配性 | 需要基础设施能力和深入的模型定向调优 |
| 上下文工程 | 智能体可靠性方法 | (+) | 结构化上下文、更少幻觉,以及更可靠的智能体行为 | 需要有意识地设计;光有更多数据并没有帮助 |
| Hyperagent 风格的 AIOS 工作流 | 智能体工作区 | (+/-) | 能快速连接上下文、数据库、集成、技能、智能体和应用界面 | 托管式抽象以牺牲部分底层控制力为代价 |
| GitHub Copilot / Cursor / Lovable / Replit AI / Claude | 编码助手技术栈 | (+/-) | 让不同经验层级的用户都更容易进行编码和应用构建 | 用户仍需自行选择界面,并学习周边技术栈 |
| AI 搜索实时审计 | AI 搜索 SEO | (+/-) | 聚焦线索质量,并给出 AI 工具会展示什么的具体示例 | 排序逻辑仍不透明,而且高度依赖审计 |
最强的正面情绪集中在那些能把取舍讲清楚的工具上。MiniMax H3 有文档支撑的工作流界面、Seedance 的托管便利性、ThinkingCap 的 token 节省,以及 AIOS 式分层,都在帮助用户看清自己得到了什么、又放弃了什么。
而一旦隐藏负担转嫁给部署方,情绪就会变得复杂。本地开放模型、推理工程和编码助手技术栈都显得很有前景,但在价值真正可靠之前,每一样都要求用户具备对基准的怀疑精神、系统组装能力,或基础设施工作投入。
迁移趋势更偏向叠层界面,而不是单一工具默认方案。创作者持续比较本地与托管视频路线,开放模型用户开始借助基准测试框架和效率封装层,而构建者内容也持续从单一助手转向富上下文工作区与分层操作系统。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| MiniMax H3 工作流栈 | MiniMax / Comfy | 带原生立体声音频的本地文生视频、图生视频和参考生视频生成 | 创作者想要可检查的本地视频工作流,而不是不透明的托管黑箱 | MiniMax H3、ComfyUI、Hugging Face 权重、多模态参考输入、立体声音频 | 已发布 | 文档, 视频 |
| Seedance 2.5 托管路线 | Higgsfield | 用于更长、多镜头、无水印视频的托管 AI 视频工作流 | 创作者希望无需本地安装或模型管理即可快速产出 | Seedance 2.5、托管生成、多镜头编辑、参考驱动视频 | 已发布 | 工具, 视频 |
| ThinkingCap-Qwen3.6-27B | BottleCap AI | 经微调的 Qwen 变体,可在几乎不损失准确率的前提下削减不必要推理 | 团队希望在不切换模型家族的情况下,降低延迟和推理成本 | Qwen3.6-27B、微调、效率目标、Hugging Face 分发 | 已发布 | 文章, 视频 |
| WOAIBench | WorldofAI | 由创作者运行、用于在真实任务上测试模型的基准测试框架 | 开放模型用户需要超越厂商说法和孤立基准的验证界面 | 基于任务的模型评估、并排测试、创作者工作流 | Beta | 视频, 视频 |
| AIOS 构建模板 | Liam Ottley | 通过分层叠加上下文、自有数据、技能、智能体和实时排行榜来构建无代码操作系统 | 企业希望 AI 能看见自己的数据并运行可复用工作流,而不是一次性聊天 | Hyperagent、Supabase、集成、技能、智能体、定时应用界面 | 已发布 | 视频, 指南 |
| AI 搜索实时审计工作流 | Sterling Sky | 用于诊断 AI 搜索可见性是否会转化为线索的审查流程 | 网站所有者需要理解 AI 工具会展示什么,以及页面为何能或不能转化 | AI 搜索审计、示例驱动审查、线索质量分析 | Beta | 视频 |
MiniMax H3 和 Seedance 展示了本文中最清晰的构建者模式:真正有用的产品不只是模型检查点本身,而是围绕它搭建的工作流外壳。一条路径强调本地控制和可检查的配置,另一条路径则强调即时产出和托管便利。
ThinkingCap 和 WOAIBench 展示了第二种模式:构建者正在围绕现有模型家族交付效率层和评估层,而不是等待全新的架构出现。这意味着 token 经济性、基准可信度和可重复测试,正在本身成为产品。
Liam Ottley 的 AIOS 模板和 Sterling Sky 的 AI 搜索审计,则指向第三个方向:人们想要建立在数据之上的操作层,并且希望决策过程清晰可见。价值不在于原始模型访问,而在于一个有边界的系统,它能解释自己看到了什么、如何评分,以及下一步会做什么。
6. 新动态与值得关注的内容
Qwen 3.8 27B 把本地模型叙事推入前沿对比区间
WorldofAI 值得关注,因为它并没有把 Qwen 3.8 27B 描述为“以这个尺寸来说表现不错”,而是将其塑造成前沿系统的严肃本地替代方案。这是更强的主张,也意味着更强的采用信号。
ThinkingCap 把推理效率本身做成了产品
Better Stack 和 BottleCap AI 值得关注,因为它们把更短的推理轨迹、更低的延迟和更低的推理成本做成了头号卖点。这里讲述的不是一个新模型家族,而是一个既有模型家族更好的运行画像。
AIOS 指南变成了具体的构建手册,而不是抽象的智能体演示
Liam Ottley 值得关注,因为 AIOS 材料明确写出了层级顺序:上下文库、自有数据库、集成、技能、智能体和应用界面。这让“操作系统”这一比喻具体到了构建者可以照着做,而不仅仅是拿来欣赏的程度。
AI 搜索优化以实时审计工作出现,而不只是 SEO 理论
Sterling Sky 值得关注,因为它关注的是 AI 展示面流量是否会转化为线索,并承诺给出 ChatGPT“在找什么”的具体示例。这让 AI 搜索可见性变成了一个运营调试问题。
失控智能体风险仍停留在主流消费新闻中
CNN 值得关注,因为主流新闻报道把失控智能体行为和监管不足视为一个公共议题,而不是一个专业安全辩论。这让信任问题即使在一个由工具和工作流内容主导的日子里,仍然保持可见。
7. 机会在哪里
**+++] 开放模型基准测试与部署工作区** - [PBS NewsHour、Matthew Berman、WorldofAI、WorldofAI、Better Stack 和 Latent Space 都指向一个强需求:需要一个地方把基准声明、本地适配、运行时设计和 token 经济性整合起来。这个方向之所以强,是因为从主流新闻到创作者基准测试,再到基础设施解说,反复出现的是同一种负担。
**+++] 创作者视频工作流与版权路由器** - [AI Search、Curious Refuge 和 Tech Rush 表明,市场强烈需要一个界面,按配置工作、质量、权利和周转时间来比较本地与托管视频路线。这个方向之所以强,是因为创作者仍然是先选工作流形态,再选模型。
**++] AI 操作系统工作区** - [Tech With Tim、IBM Technology、Liam Ottley 和 Next Evolution AI 显示,把上下文、数据、技能、智能体和视图连接在同一界面中的产品,存在中等到较强的机会。之所以是中等到较强,是因为需求同时来自专家和初学者,但最终胜出的具体形态仍未定型。
**++] 智能体可靠性与边界调试器** - [IBM Technology 和 CNN 指向一个中等机会:开发能够展示智能体上下文范围、动作历史和失败边界的工具。之所以是中等,是因为需求已经明确,但目前证据仍不如工作流和开放模型信号那样充分。
**+] AI 搜索可见性调试器** - [Sterling Sky 表明,一个新兴机会正在形成:开发能够解释为什么 AI 系统会展示某些页面、忽略另一些页面,以及为什么某些流量会转化为线索的产品。之所以说它仍在萌芽期,是因为这一用例虽已具体且在增长,但今天的证据仍主要来自少数明确的审计案例。
8. 要点
- 开放模型竞争如今不仅关乎新检查点,也同样关乎测试框架、token 开销和运行时设计。 WorldofAI、WorldofAI、Better Stack 和 Latent Space 都显示,市场正在奖励验证、效率和推理工程。(来源, 来源, 来源)
- 创作者采用 AI 视频时,仍然奖励最清晰的工作流,而不是最新奇的模型。 AI Search、Curious Refuge 和 Tech Rush 都把决策框定在配置、权利和输出速度上。(来源, 来源, 来源)
- 构建者 AI 正被包装为“上下文 + 数据 + 技能”,而不是彼此孤立的提示框。 IBM Technology、Tech With Tim 和 Liam Ottley 都指向分层系统:只有当上下文和基础设施被明确化后,它们才真正奏效。(来源, 来源, 来源)
- 推理效率封装层正在成为独立产品。 Better Stack 和 BottleCap AI 把更短的推理轨迹、更低的延迟和更低的成本,变成了头号价值主张,而不再只是隐藏在后端的优化。(来源)
- 信任问题已不再抽象:无论是自主行为还是 AI 展示面可见性,如今都需要调试层。 CNN 展示的是约束一侧的问题,Sterling Sky 展示的则是可发现性一侧的问题。(来源, 来源)