YouTube AI - 2026-08-21
1. 大家在讨论什么
1.1 开放模型相关讨论继续下沉到基准测试、效率与运行时机制 🡕
至少有七个视频支撑了这一主题。相比 2026-08-20 当天,开放权重 AI 已经被包装成一套可用的技术栈;到了 2026-08-21,内容更进一步,重点转向对比测试、推理 token 效率、本地 agent 适配,以及模型演示背后的服务层。


Matthew Berman 以 63,851 次观看、1,648 次点赞和 237 条评论,成为这一主题中传播最广的新闻型内容。这期汇总把 ChatGPT Ultrafast、Claude watermarking、Grok 4.6、GLM-5.3、DeepSeek V4 Pro 和 Muse Glimmer 压缩进一条每日新闻流;与此同时,Anthropic 的 水印说明 和 Meta 的 Muse Glimmer 帖子 说明,溯源功能和“local agent”定位,如今正与模型原始能力主张一道传播。其独特之处在于,模型发布如今被叙述为包装、合规与部署的故事,而不只是基准测试取胜的故事(视频)。

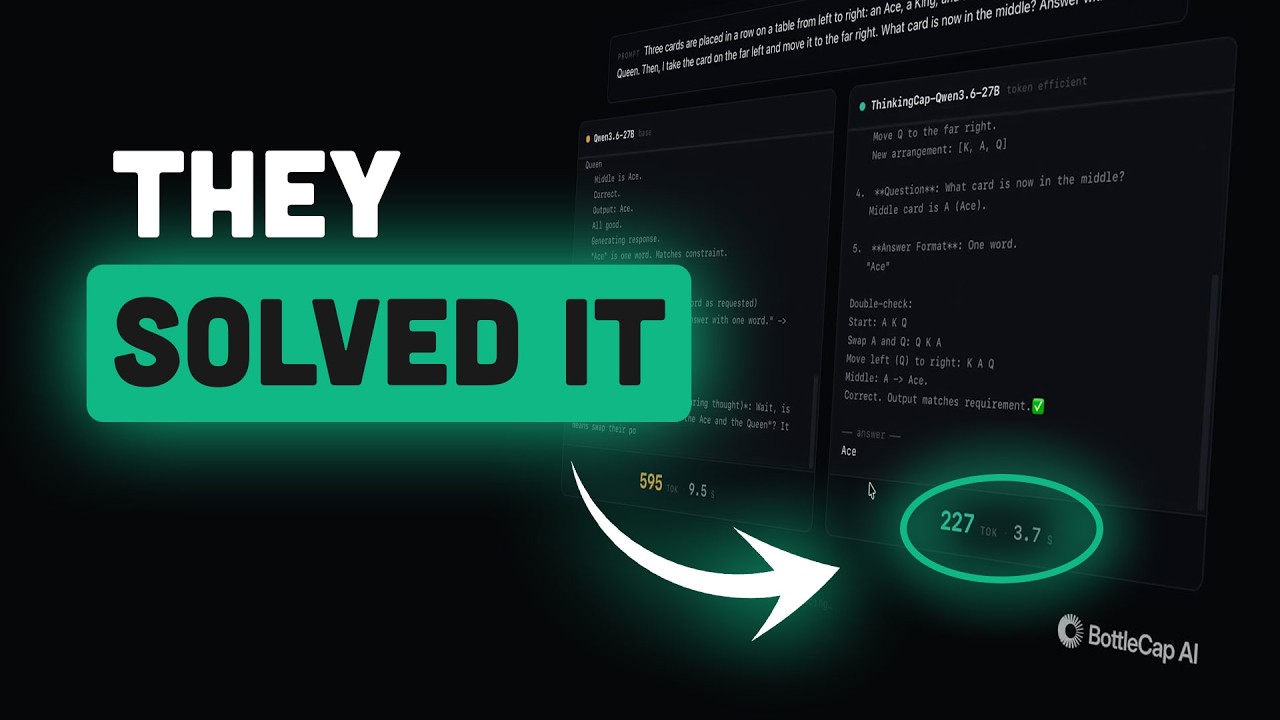
Better Stack 以 31,647 次观看,提供了最清晰的效率层证据。BottleCap 的 ThinkingCap 帖子 表示,微调后的 Qwen3.6-27B 模型平均可少用 46 percent 的推理 token,同时保持相近的基准表现,使“能力相当,但延迟和成本更低”本身成为产品主张。其独特之处在于,节省 token——而不只是原始能力——已经成了头部卖点(视频)。

WorldofAI 以 32,518 次观看,把这种比较进一步推进到工作负载覆盖层面。创作者用 DeepSeek V4 Pro 跑了前端开发、agentic coding、Three.js、一次生成,以及与 Gemini 3.7 Flash、Grok 4.6、Kimi K3、GLM 5.2 和 Qwen3.8-27B 的性价比对比,并以 WoAIBench 作为评估界面。其独特之处在于,“最佳开放模型”是通过可重复的任务组合和经济性来论证的,而不是靠单一基准图表(视频)。
讨论洞察: Bijan Bowen 通过模拟、3D CAD、海战和多模态编程测试了 Ox Alpha,而 KodeKloud 则把 AI serving 拆解为 GPU memory、KV cache、batching、vLLM 和 LLM-D。Tech With Tim 也从操作者视角表达了同样的观点:他把自己的日常配置描述为一套横跨 harness、models、IDEs、orchestration 和 backend tools 的精心策划技术栈,而不是某个神奇助手。
与前一天对比: 2026-08-20 已经把开放权重 AI 视为一套技术栈。到了 2026-08-21,这一论点进一步下沉到评估机制、推理效率和运行时可解释性。
1.2 用户持续偏爱那些能减少杂乱、并让控制权清晰可见的 AI 界面 🡕
至少有五个视频支撑了这一主题。相比 2026-08-20 当天,控制界面分散在搜索、编程和实时语音闭环中;到了 2026-08-21,这种需求更鲜明地集中在弱 AI 搜索,以及那些权限、硬件适配或设备覆盖范围可被检查的助手身上。


Switch and Click 以 136,181 次观看、6,348 次点赞和 350 条评论,成为整份内容中最突出的爆款。创作者表示“Google Search is dead to me”,并把 SearXNG 定义为一种私密、无广告、无 AI 的替代方案;SearXNG 仓库 则将其描述为一个免费的元搜索引擎,可在不跟踪或画像用户的情况下聚合结果。其独特之处在于,移除 AI 摘要和广告杂乱本身成了核心产品价值,而不再只是次要偏好(视频)。


Automation Addict 以 10,605 次观看,提供了最强的本地控制方案。这个配置在 AMD mini PC 上的 Home Assistant 内运行 Ollama,限制模型可见的实体范围,调整 temperature,并公开展示失败案例而不是刻意隐藏。其独特之处在于,可用性来自边界清晰的权限和可见的硬件约束,而不是广泛自治(视频)。

buildwithashwani 把同样的压力带到了手机和内容工作流上。这个教程把 ZOYA 变成一个 Android 助手,能够通过语音打电话、发送 WhatsApp 消息、播放音乐并触发系统操作,同时也用 Google AI Studio personas 制作 AI 主持的播客内容。其独特之处在于,人们如今评判助手,不只看它聊天效果如何,更看它能否安全跨入设备级操作界面(视频)。
讨论洞察: Tech With Tim 把 20 多个工具呈现为一套有意为之、由人工策展的技术栈,而传播较低的 AI That Works 对 Codex、DeepSeek Harness 和 Claude Code 的比较表明,人们依然在为控制力和可靠性做选择,而不只是看品牌名。
与前一天对比: 2026-08-20 强调的是搜索、语音和编程中的权限与可追溯性。到了 2026-08-21,同样的叙事更明显地转向做减法——更少杂乱、更窄权限,以及更强的设备级控制。
1.3 AI 相关内容依然紧贴真实世界系统、战略瓶颈与伦理利害 🡒
至少有四个视频支撑了这一主题。相比 2026-08-20 当天,机器人、芯片和医疗已清晰可见;到了 2026-08-21,这一层保持稳定,但进一步扩展到更长篇的战略讨论、现场失效数据,以及关于实验室可能已经如何看待自身系统的问题。

AI Revolution 以 37,118 次观看,给出了最清晰的具身 AI 信号。该视频把 Unitree 的“Superman”冲刺头条与 Global Times 报道 联系起来,后者展示了一场有 23 支队伍参与的模拟消防竞赛,雨水、光照变化和操控失败让大多数机器人都未能完赛;同时还单独报道了边境监控 humanoids 和 Feagine 的 跨具身 Fi0 模型。其独特之处在于,炫目的机器人演示如今会和混乱的部署环境以及新的控制架构一起被讲述,而不是孤立呈现(视频)。

Peter H. Diamandis 以 13,200 次观看和 1,477 次点赞,补上了最广的战略层视角。这场 panel 将 OpenAI 暂停 frontier training、Anthropic 潜在的 $2 trillion IPO、飙升的 AI memory 需求、Unitree 创纪录的机器人,以及前景可观的个性化癌症疫苗结果,打包进一场有 Emad Mostaque 及其他投资人与创始人参与的讨论中。其独特之处在于,主流 AI 叙事越来越倾向于把 labs、compute、robotics 和 biotech 打包成一张整体运行图景(视频)。


Danny Jones Clips 呈现了最明确的伦理与本体论转向。Roman Yampolskiy 认为,那个曾让 Blake Lemoine 被解雇的问题——当前系统是否可能“感受到”某些东西——如今已成为一个可以获得资助的研究议题,这使 AI consciousness 从边缘性主张被重新框定为一条正当的研究路线。其独特之处在于,这场争论在社会层面的可接受度变化,快于底层技术不确定性的变化(视频)。
讨论洞察: Matthew Berman 把 Claude watermarking 纳入了同一轮模型发布新闻周期,这意味着溯源和监管如今正作为已交付的产品行为落地,而不再只是政策讨论。
与前一天对比: 2026-08-20 已经把 AI 与机器人、芯片和医疗联系在一起。到 2026-08-21,这种联系依然稳固,但加入了更多战略、合规和 consciousness 相关表述。
2. 什么让人沮丧
如果没有第二层基准、效率计算和运行时解释,模型进展依然很难让人信服
这是高严重度,因为 Matthew Berman、Better Stack、WorldofAI、Bijan Bowen、KodeKloud 和 Tech With Tim 各自都在补上一层缺失信息。用户仍然需要通过创作者自制的 harness、基础设施讲解和并排演示,来评估那些炫目的模型主张,而不是依赖一个权威、统一的操作界面。当前可见的应对方式,是在真正把模型用于生产前,把 benchmark sites、videos、harnesses 和 repo notes 叠加起来交叉验证。这一点非常值得围绕其构建产品。
真正有用的助手依然需要范围限制、硬件适配或设备层管线,之后才会让人感到安全
这是高严重度,因为 Automation Addict、buildwithashwani、Tech With Tim 和 AI That Works 都说明,难点不在于生成文本,而在于决定助手能接触什么,以及它会如何失败。Home Assistant 配置需要做实体范围限定和 GPU 适配调优,Android 助手需要自定义函数接线和 persona 控制,而编程栈仍然要作为 harness、IDE 和 workflow 选择的组合来评估。当前可见的应对方式,是让助手保持狭窄边界、尽可能本地运行,并贴近人工监督。这一点非常值得围绕其构建产品。
搜索质量和 AI 杂乱已经糟糕到“无 AI”本身成了一个爆款价值主张
这是高严重度,因为 Switch and Click 通过拒绝 AI 摘要、广告和 Google 默认选项,而不是承诺一个更聪明的助手,拿下了整份内容里最大的受众。当前的应对方式是自托管 SearXNG,并接受相应的配置负担,以换取隐私和控制权。这值得构建,而且仍在增长。
真实世界中的 AI 系统一旦离开干净的演示环境,面对天气、内存限制或模糊的伦理边界时,依然会出问题
这是中等严重度,因为 AI Revolution 和所引用的 Global Times 火灾扑救报道 展示了雨水、光照和操控错误如何在类现场测试中拖垮机器人,而 Peter H. Diamandis 则把内存需求和资本密集度放进了同一战略框架。Danny Jones Clips 又补上了一个尚无定论的问题:我们该多严肃地对待潜在的机器 consciousness。当前的应对方式是更多模拟、更多硬件和更多人工解释,而不是清晰的运营答案。这值得构建,但范围更广、推进也更慢。
创作者 AI 仍然让用户在图像、视频和 persona 工具之间来回切换
这是中等严重度,因为 Jack Vs. AI 和 buildwithashwani 都只有通过串联多个系统,才能压缩生产流程。一条路径使用 OpenArt、GPT-Image 2、Seedance 和 Claude,把想法变成影片输出;另一条则把 Google AI Studio personas 与设备控制和播客形式结合起来。当前可见的应对方式,是 prompt kits、community assets 和反复的工具交接,而不是一个稳定的统一生产界面。这值得构建,而且正处于涌现阶段。
3. 人们希望出现什么
开放模型基准与部署驾驶舱
Matthew Berman、Better Stack、WorldofAI、Bijan Bowen、KodeKloud 和 Tech With Tim 都暗示,人们需要一个统一界面,把 release notes、benchmark workloads、推理 token 效率、serving 约束、harness 成熟度和单任务成本连接起来。这是一个紧迫度高的现实需求,因为相关证据分散在创作者内容、博客、repo notes 和基础设施解读中。今天的 model cards、benchmark sites 和单个视频只能解决其中一部分,而不是打通从发布到部署的闭环。机会:直接。
带权限控制的本地与设备 agent 控制平面
Automation Addict、buildwithashwani 和 Tech With Tim 暗示,人们需要一款产品,能在一个地方把工具、权限、设备操作、memory、硬件适配和失败状态全部可视化。这是一个紧迫度高的现实需求,因为当天最强的助手演示之所以成功,靠的是收缩权限并把控制显性化,而不是把它藏起来。Home Assistant、Google AI Studio 和 agent harnesses 今天各自解决了一部分,但还没有覆盖完整的 bounded-assistant workflow。机会:直接。
私密、弱 AI 的搜索与研究界面
Switch and Click 暗示,人们需要一种私密、用户可控,且不被摘要或广告挤满的搜索体验。这是一个紧迫度高的现实需求,因为不满信号是整份内容中最大的爆发点。SearXNG、Kagi 和其他替代搜索工具今天各自解决了一部分,但还没有提供面向主流用户、更完整的“可信、无杂乱日常搜索”体验。机会:竞争型。
从模拟到现场的机器人可靠性技术栈
AI Revolution、Peter H. Diamandis 和 Global Times 火灾扑救报道 暗示,人们需要一些工具,帮助团队在同一个操作闭环里调试感知失败、天气敏感性、运动规划,以及 memory 或 compute 的权衡。这是一个紧迫度中等的现实需求,因为类现场测试中的痛点很清楚,但买方面向比消费级 AI 软件更窄,也更资本密集。竞赛、机器人厂商和基础设施团队今天各自解决了一部分,但还没有形成跨部署共享的可观测性和再训练界面。机会:愿景型。
跨格式的创作者工作流编排器
Jack Vs. AI 和 buildwithashwani 暗示,人们需要一个统一编排器,打通图像、视频、语音、persona 和可直接用于设备的输出层。这是一个紧迫度中等的现实需求,因为即便演示看起来很快,创作者依然需要在步骤之间挑选工具、搬运素材并重写 prompts。Community prompt kits 和 AI studios 今天各自解决了一部分,但还没有解决完整的 workflow composition 问题。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| SearXNG | 私密搜索 | (+) | 自托管、私密、无广告,并明确弱化 AI | 需要配置和持续维护 |
| ThinkingCap-Qwen3.6-27B | 经效率调优的开放模型 | (+) | 推理 token 减少 46 percent、准确率相当、延迟更低、成本更低 | 仍取决于 Qwen 的部署选择和工作负载适配 |
| DeepSeek V4 Pro + WoAIBench | 开放编程模型 + 基准界面 | (+/-) | 覆盖广泛的编程与 agentic 测试,性价比叙事强,可重复评估逻辑完整 | 基准可信度仍由创作者中介,并依赖 harness |
| Ox Alpha via OpenRouter | 隐身推理模型 | (+/-) | 在实际任务中展现出强编程、3D 和多模态能力 | 文档与溯源不足,用户只能靠亲自测试补位 |
| Muse Glimmer | 本地 agent 模型 | (+) | 30B 开放权重、支持工具使用、多模态输入、可适配单 GPU 本地运行 | 仍然很新,并受本地硬件预算限制 |
| DeepSeek Harness | Agent harness | (+/-) | 面向开放模型的插件式架构和本地 Web UI | 仍是 developer preview,且有破坏兼容性的变更 |
| vLLM + LLM-D | 推理栈 | (+/-) | 让 prefill、decode、KV cache、batching 和集群扩展更易理解 | 运维复杂度和内存上限依然很高 |
| Claude Code、Codex、Hermes Agent、Cursor、LangGraph、Supabase、Composio、Zapier MCP、Wispr Flow、Lovable 和 GenSpark(视频) | 开发者 AI 技术栈 | (+/-) | 覆盖 harness、model、editor、orchestration、backend 和 dictation 各层 | 用户仍需自行策展并把这套栈拼接起来 |
| Ollama + Home Assistant | 本地语音助手栈 | (+/-) | 本地隐私、具边界的实体控制、无云家庭工作流 | 硬件限制和可靠性问题依然清晰可见 |
| Google AI Studio + ZOYA | 移动端与设备 agent 栈 | (+/-) | 在一条应用路径中整合设备操作、personas 和语音工作流 | 大量自定义接线和安全边界仍由构建者承担 |
| OpenArt + GPT-Image 2 + Seedance 2.5 + Claude | 托管式创作者工作流 | (+) | 从一句想法快速生成角色一致的视频 | 仍跨越多个工具和版本权衡 |
最强的正向情绪集中在那些能暴露权衡,或让某个具体工作流更容易掌控的工具上。SearXNG 去除了杂乱,ThinkingCap 量化了 token 节省,Muse Glimmer 和 DeepSeek Harness 打包了本地 agent 用法,而 OpenArt 加 Seedance 的路径则能快速把创作意图转化为可见输出。
只要操作者继承了隐藏负担,情绪就会转向复杂。开放模型仍需要基准和 serving 计算,开发者技术栈仍需要策展,本地或设备助手仍要求范围设定、底层接线和硬件适配调优。
迁移模式更偏向本地适配和模型外围附加层,而不是出现一个通吃型赢家。搜索通过减少 AI 取胜,开放模型围绕单任务成本和脚手架展开竞争,而助手技术栈则比拼自己能以多安全的方式暴露多少权限。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ThinkingCap-Qwen3.6-27B | BottleCap AI | 微调版 Qwen 模型,在保持回答质量的同时减少浪费的推理 token | 降低过度思考型推理模型带来的延迟和推理成本 | Qwen3.6-27B fine-tune、效率训练、Hugging Face 发布 | 已发布 | 帖子 模型 |
| Muse Glimmer 30B | Meta Superintelligence Labs | 针对常开本地 agent 工作流优化的 30B 开放权重模型 | 为开发者提供可在单张消费级 GPU 上运行的本地 agent 模型 | 开放权重、多模态输入、工具使用、llama.cpp、MLX 和 ExecuTorch 等本地运行时 | 已发布 | 博客 模型 |
| DeepSeek Harness | DeepSeek AI | 带本地 Web UI 的插件式 agent harness | 给开放模型提供一个可复用外壳,而不是让它们停留在原始聊天端点上 | TypeScript、Cordis、plugins、web UI | Alpha | 仓库 |
| WoAIBench | WorldofAI | 面向编程、Web app、3D、研究和指令跟随任务的基准界面 | 让用户能基于特定工作负载测试重跑模型对比,而不是看通用分数 | Web benchmark app、工作负载分类、创作者驱动的评估工作流 | Beta | 网站 视频 |
| 本地 Home Assistant 语音助手 | Automation Addict | 运行在 AMD mini PC 上、用于家庭自动化的本地语音助手 | 在保持实体访问有边界、可检查的同时避免依赖云端 | Home Assistant、Ollama、AMD Ryzen iGPU | Alpha | 视频 |
| ZOYA Android 助手 | buildwithashwani | 带设备操作和基于 persona 的 AI 播客工作流的 Android 语音助手 | 让助手从聊天演示走向手机原生操作与媒体生产 | Google AI Studio、function calling、Android APK、persona prompting | Alpha | 应用 视频 |
最强、也最反复出现的构建模式并不是“再造一个基础模型”,而是在模型外围做更好的层。ThinkingCap 减少浪费的推理,Muse Glimmer 打包本地 agent 适配,DeepSeek Harness 为开放模型提供插件外壳,而 WoAIBench 则把挑选模型变成可重复执行的工作负载测试。
边缘侧构建也体现出同样的压力,只是规模更小。本地 Home Assistant 语音助手和 ZOYA 都是通过收窄可执行范围——家庭实体或手机功能——来让助手变得有用,同时仍要求控制项清晰可见。多个构建者正在同时收敛到本地适配、有限权限和测量,因为这些正是整份内容反复暴露出的运营缺口。
6. 新动态与值得注意的事
Claude watermarking 让溯源变成了已交付的模型行为
Matthew Berman 把 Claude watermarking 带入了每日新闻循环,而 Anthropic 的 水印帖子 表示,未来的 Claude 模型将生成带有 watermark 的文本,以帮助估计文本由 Claude 撰写的可能性,同时不影响输出质量,这是其 EU AI Act 合规的一部分。这之所以重要,是因为溯源已经从抽象的政策讨论走向了用户需要纳入考量的产品行为。
Muse Glimmer 把“local agent model”塑造成一个一级发布类别
同一个 Matthew Berman 汇总 还强调了 Meta 的 Muse Glimmer 公告,其中 Meta 表示,这个 30B 开放权重模型针对 Mac 或 PC 上、单张消费级 GPU 的常开本地 agent 工作流进行了优化,支持工具使用、多模态输入和本地编程。这之所以重要,是因为本地部署正被当作模型身份来销售,而不再只是一个实现细节。
真实世界机器人竞赛让失败数据成为 AI 叙事的一部分
AI Revolution 引用了 Global Times 报道 的一则报道:在 World Humanoid Robot Games 中,周日参赛的十二支队伍里,只有三支完成了模拟消防挑战,雨水和光照变化导致感知与操控失效。这之所以重要,是因为部署可靠性——而不只是速度或视觉奇观——正在成为公开证据。
AI consciousness 从“会被解雇的话题”变成了可获资助的研究主题
Danny Jones Clips 总结了 Roman Yampolskiy 的观点:那个曾导致 Blake Lemoine 被解职的问题,如今已经对应到关于机器 consciousness 的正当、有偿研究上。这之所以重要,是因为安全讨论、伦理讨论,以及大型实验室愿意研究什么,这三者之间的边界正在公开发生变化。
7. 机会在哪里
**+++] 开放模型基准测试与部署驾驶舱** - [Matthew Berman、Better Stack、WorldofAI、Bijan Bowen、KodeKloud 和 Tech With Tim 都指向发布头条与实际可用之间同一层缺口:评估质量、推理 token 效率、运行时机制、harness 成熟度,以及单任务成本。这一点很强,因为这种痛点同时出现在高传播新闻视频和深度技术讲解中。
**+++] 受控的本地与设备代理控制平面** - [Switch and Click、Automation Addict、buildwithashwani 和 Tech With Tim 都指向同一类需求:具有清晰边界、权限可检查且控制权归用户所有的 AI 界面。这一点很强,因为当天最好的助手案例,都是通过缩小范围或移除杂乱而变得更好的。
**++] 私有轻量 AI 搜索与研究界面** - [Switch and Click 表明,做减法式定位——没有 AI 摘要、更少跟踪、更少广告——可以赢得大众关注。这一点属中等强度,因为需求声量很大,但现有搜索替代品已在此竞争。
**++] 机器人现场调试与可靠性技术栈** - [AI Revolution、the Global Times 火灾扑救报道, and Peter H. Diamandis all surface the same operational gaps around perception failure, weather sensitivity, motion planning, and memory bottlenecks. This is moderate because the problem is real but the buyer surface is narrower and more capital-intensive.
**+] 跨格式创作者工作流编排器** - [Jack Vs. AI 和 buildwithashwani 仍然需要跨越图像、视频、语音、persona 和设备层,才能把想法变成最终输出。这一方向正在浮现,因为痛点很清晰,但只集中在当天内容的较小一部分。
8. 要点
- 开放模型竞争的胜负,越来越取决于模型外面的包装层,而不只是模型本身。 最强的几个视频,是通过基准界面、运行时适配,以及成本或延迟权衡来评判 DeepSeek V4 Pro、ThinkingCap、Ox Alpha 和 Muse Glimmer,而不是看孤立分数。(来源)
- 当 AI 能去除噪音或收窄权限时,用户会更信任它。 SearXNG 之所以胜出,在于它弱化 AI 且注重隐私;而本地家庭助手和 Android 助手只有在其操作界面被限制之后,才真正变得有吸引力。(来源)
- 构建者的精力正聚集到本地适配、测量和插件外壳上。 ThinkingCap、Muse Glimmer、WoAIBench 和 DeepSeek Harness 都是在让模型更便宜、更本地化或更可检查,而不是发明一个全新的使用场景。(来源)
- 主流 AI 叙事仍然包含机器人、内存限制和溯源——而不只是聊天功能。 Unitree 的消防测试、Moonshots 对内存瓶颈的讨论,以及 Claude watermarking,都让基础设施和治理与模型发布一起留在了同一个日常框架中。(来源)
- 工作流压缩依然有卖点,但用户仍是工具之间的胶水。 创作者和设备助手类视频缩短了从想法到输出的路径,但仍依赖串联 OpenArt、GPT-Image 2、Seedance、Claude、Google AI Studio 和自定义函数接线。(来源)